1. Введение.#
1.1. Юридическая информация#
Оригинальная книга "The OpenFOAM® Technology Primer" распространяется под лицензией Creative Commons «Attribution-ShareAlike» («С указанием авторства — С сохранением условий») версии 4.0 (CC BY-SA 4.0) .
Это означает, что можно свободно использовать, переводить, распространять и даже адаптировать книгу для своих целей, включая коммерческие, при соблюдении двух основных условий :
Указание авторства: Вы обязаны указать имя автора (Tomislav Maric, Jens Höpken, Kyle G. Mooney) и предоставить ссылку на лицензию.
Сохранение условий: Если вы изменяете, дополняете или создаете производную работу на основе книги (например, ваш перевод), вы должны распространять её на тех же условиях лицензии CC BY-SA 4.0.
Книга доступна для бесплатного скачивания в формате PDF на платформе Zenodo по ссылке: https://zenodo.org/record/4630596 .
Соответственно мой перевод с коментариями распостраняется под той же лицензией CC BY-SA 4.0. с сохранением тех же условий ( указание авторства и сохранение условий лицензии)
1.1.1. Важное примечание о торговой марке#
В оригинале есть специальный дисклеймер: это издание не одобрено и не поддерживается компанией OpenCFD Limited, которая владеет торговыми марками OPENFOAM® и OpenCFD® . Соответственно и на перевод эта оговорка распостраняется в полной мере.
1.2. OpenFOAM для инженеров - двигателистов: почему именно сейчас?#
1.2.1. От KIVA до OpenFOAM: сорок лет эволюции двигательного CFD#
История вычислительной газодинамики двигателей внутреннего сгорания — это история нескольких поколений программных платформ. В 1980-х годах революцию совершил KIVA, разработанный в Los Alamos National Laboratory. Впервые стало возможным относительно доступное моделирование процессов внутри цилиндра: движения воздуха, распыла топлива, горения и образования вредных выбросов. На базе научной школы KIVA выросла значительная часть современного двигательного CFD.
Следующим этапом стали специализированные коммерческие системы. В Европе доминирующее положение занял AVL FIRE. В США сформировалась школа профессора Ronald Reitz, которая впоследствии привела к созданию CONVERGE CFD. Параллельно развивались универсальные CFD-платформы, прежде всего Ansys Fluent, ставший фактическим мировым стандартом для широкого круга задач механики жидкости и газа. На протяжении многих лет развитие отрасли происходило именно внутри этой экосистемы.
1.2.2. Российская специфика: эпоха AVL#
Российское двигателестроение прошло собственный путь. Для одномерного моделирования широко использовались AVL BOOST и GT-Power, а позднее GT-SUITE. Однако для многих предприятий именно связка AVL BOOST и AVL FIRE стала основой расчётной инфраструктуры.
Получалась единая инженерная экосистема:
AVL BOOST — рабочий процесс двигателя в 1D;
AVL FIRE — процессы внутри цилиндра в 3D;
другие продукты AVL — динамика, трансмиссии и системный анализ.
Для задач теплообмена, впускных и выпускных трактов, турбомашин и общего CFD широко применялся Fluent.
Именно поэтому у нескольких поколений российских двигателистов вычислительное моделирование ассоциируется прежде всего с AVL FIRE, AVL BOOST и Fluent. Эти инструменты использовались в НАМИ, ЦИАМ, двигателестроительных предприятиях, университетах и исследовательских центрах.
1.2.3. CONVERGE: технология, которая не успела стать массовой#
В мировой отрасли последние пятнадцать лет стали временем стремительного роста CONVERGE CFD. Автоматическая декартова сетка, адаптивное измельчение, эффективная работа с движущимися границами и сильные модели горения сделали его одной из наиболее заметных технологий в двигательной CFD.
Интерес к CONVERGE существовал и в России. В частности, специалисты НАМИ изучали возможности применения CONVERGE для расчётов процессов в цилиндре.
Однако широкого распространения CONVERGE получить не успел. К моменту, когда многие организации только начинали рассматривать переход от FIRE к CONVERGE, условия работы с зарубежным программным обеспечением радикально изменились. Фактически российская отрасль перескочила через этап массового внедрения CONVERGE.
1.2.4. Уход привычной экосистемы#
После 2022 года проблема оказалась гораздо шире, чем вопрос лицензий. Под угрозой оказалась вся сложившаяся методология разработки двигателей. Особенно чувствительным стало отсутствие долгосрочных перспектив для двух ключевых направлений:
одномерного моделирования двигателей;
специализированного двигательного CFD.
На протяжении десятилетий AVL BOOST, GT-Power и GT-SUITE являлись основными инструментами системного моделирования.
Через них проходили:
газообмен;
турбонаддув;
EGR;
тепловые режимы;
анализ рабочих циклов;
предварительная оптимизация конструкции.
Для многих инженеров именно 1D-модель была центральным элементом разработки двигателя. Поэтому вопрос импортозамещения нельзя сводить исключительно к поиску замены AVL FIRE или Fluent.
Речь идёт о необходимости формирования новой расчётной экосистемы.
1.2.5. Российский опыт: FlowVision и пределы импортозамещения#
Говоря о развитии CFD в России, нельзя не упомянуть FlowVision — один из наиболее успешных отечественных программных продуктов в области вычислительной гидродинамики.
Разработка компании ТЕСИС началась ещё в 1990-х годах и привела к созданию полноценной промышленной CFD-платформы, нашедшей применение в авиации, энергетике, судостроении, атомной промышленности и ряде других отраслей. Особенностью FlowVision стала собственная архитектура расчётной сетки и ориентация на широкий спектр задач механики жидкости и газа.
Сам факт существования FlowVision показывает, что в России возможно создание конкурентоспособных CFD-технологий мирового уровня. Однако двигателестроение традиционно предъявляет к программному обеспечению особые требования.
Для расчёта процессов в цилиндре современного двигателя необходимы десятилетия накопления специализированных моделей:
впрыска топлива;
распыла;
испарения;
химической кинетики;
образования NOx;
образования сажи;
детонационных процессов;
взаимодействия турбулентности и горения.
Именно вокруг таких задач исторически развивались AVL FIRE, CONVERGE и их предшественники.
Поэтому, несмотря на очевидные достоинства FlowVision как универсального CFD-пакета, в двигательной среде его распространение оставалось ограниченным. FlowVision занял важное место в российском CFD, но не стал отраслевым стандартом для моделирования процессов внутри цилиндра двигателя.
Это не недостаток продукта. Скорее отражение того факта, что создание универсального CFD-пакета и создание специализированной двигательной экосистемы — задачи разного масштаба.
1.2.6. Почему OpenFOAM оказался в центре внимания#
Ещё десять лет назад большинство мотористов воспринимали OpenFOAM как академический инструмент для университетов и исследовательских групп. Сегодня ситуация выглядит иначе.
OpenFOAM предоставляет:
полный доступ к исходному коду;
современные модели турбулентности;
LES и hybrid LES/RANS;
химическую кинетику;
распыл топлива;
моделирование горения;
динамические и перекрывающиеся сетки;
масштабирование на современные HPC-кластеры.
При этом платформа развивается мировым сообществом и не зависит от решений отдельной коммерческой компании.
Фактически OpenFOAM становится тем, чем когда-то был KIVA: базовой открытой платформой для развития собственных расчётных технологий.
1.2.7. Новая экономика вычислений#
Есть ещё одна причина, по которой разговор об OpenFOAM становится особенно актуальным именно сейчас. GT-Power, GT-SUITE и AVL BOOST получили своё доминирующее положение в эпоху дорогих вычислений. Когда расчёт одного рабочего цикла двигателя в 3D занимал дни или недели, одномерное моделирование было безальтернативным инструментом.
Типичный процесс разработки выглядел так

Однако вычислительная техника развивается быстрее инженерных методик. Современная рабочая станция зачастую превосходит вычислительные ресурсы, которыми располагали многие исследовательские центры двадцать лет назад. Количество доступных процессорных ядер растёт. Стоимость вычислений снижается. Распространяются кластерные и облачные технологии. Разумеется, это не означает исчезновения одномерного моделирования.
Но граница между задачами, которые можно решать только в 1D, и задачами, которые уже можно считать напрямую в 3D, постепенно смещается. То, что вчера требовало суперкомпьютера, сегодня становится доступным инженерному подразделению предприятия.
Возможно, в ближайшие годы процесс будет выглядеть уже иначе:
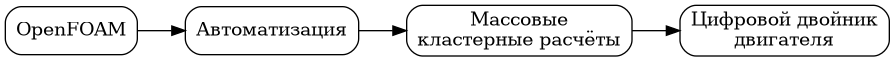
1.2.8. Главная проблема OpenFOAM — не код, а знания#
Парадоксально, но крупнейшим ограничением OpenFOAM сегодня является вовсе не программное обеспечение. Проблема заключается в знаниях. Для Fluent существуют тысячи курсов и учебников. Для GT-SUITE существуют корпоративные программы подготовки. Для AVL FIRE десятилетиями накапливались методические материалы и внутренние стандарты предприятий.
OpenFOAM чрезвычайно распространён в мире, однако качественной учебной литературы существенно меньше, чем принято считать.
Большинство действительно полезных материалов:
англоязычны;
ориентированы на подготовленного пользователя;
зачастую распространяются на коммерческой основе.
Поэтому дефицит систематизированных знаний становится одним из главных препятствий на пути широкого внедрения OpenFOAM в двигательной отрасли.
1.3. The OpenFOAM® Technology Primer как современная библия OpenFOAM#
Среди существующих изданий особое место занимает книга The OpenFOAM® Technology Primer.
Для многих инженеров это наиболее системное введение в архитектуру OpenFOAM.
Книга занимает уникальное положение между пользовательским руководством, справочником разработчика и инженерным учебником.
Она объясняет:
устройство OpenFOAM;
структуру данных;
организацию расчётов;
численные методы;
архитектуру солверов;
принципы разработки собственных моделей.
По своему значению для сообщества OpenFOAM эта книга во многом сопоставима с ролью классических руководств по KIVA для исследователей двигателей в 1990-х годах.
1.3.1. Почему простого перевода уже недостаточно#
Однако сегодня задача состоит не просто в переводе книги. С момента появления первых изданий OpenFOAM значительно изменился.
Получили развитие:
overset-технологии;
современные динамические сетки;
новые модели LES;
методы работы с химической кинетикой;
средства автоматизации расчётов;
HPC-масштабирование;
интеграция с современными инженерными процессами.
Поэтому в 2026 году нужен не буквальный перевод книги десятилетней давности, а её адаптация к современному состоянию OpenFOAM. Фактически речь идёт о создании русскоязычного инженерного комментария к OpenFOAM середины 2020-х годов.
Я надеюсь, что такой труд мог бы стать не просто учебником, а одним из элементов формирования новой школы двигательного CFD.
1.4. OpenFOAM - с надеждой, в будущее !#
Российское двигателестроение оказалось в уникальной ситуации. Впервые за многие годы вопрос стоит не о выборе между двумя коммерческими пакетами, а о формировании собственной вычислительной школы. Когда-то такой платформой для исследователей двигателей был KIVA. Затем наступила эпоха коммерческих экосистем AVL, Fluent и GT-SUITE. Сегодня отрасль получает шанс перейти к следующему этапу.
OpenFOAM интересен не потому, что он бесплатен.
Он интересен потому, что позволяет самостоятельно развивать технологии, создавать собственные модели, формировать собственные компетенции и сохранять контроль над критически важными инженерными инструментами.
Возможно, главная ценность OpenFOAM заключается не в конкретных солверах, моделях турбулентности или средствах автоматизации. Его главная ценность состоит в том, что он позволяет инженеру видеть и понимать технологию целиком. В эпоху, когда готовые коммерческие решения всё чаще превращаются в «чёрные ящики», способность понимать устройство инструмента становится самостоятельным конкурентным преимуществом. Знакомство с архитектурой OpenFOAM сегодня представляет интерес не только для пользователей OpenFOAM, но и для всех специалистов, работающих в области вычислительной гидрогазодинамики и моделирования двигателей внутреннего сгорания.
Именно поэтому вопрос перевода, адаптации и распространения современных знаний по OpenFOAM сегодня становится не издательской задачей. Он становится частью развития инженерной инфраструктуры российского двигателестроения.
1.5. Кому может быть полезна эта книга#
[Инженерам,]{.underline} решающим практические повседневные задачи, требующие CFD анализа. Подразумевается, что все мы уже изрядно забыли институтский курс высшей математики и линейной алгебры и нам затруднительно «с листа» сложные математические формулы. В комментариях, я пытаюсь «на пальцах» разъяснять саму суть используемых математических приемов с практической (инженерной) стороны, строгое математическое описание остается за пределами данного изложения.
Так же подразумевается, что инженер имеет некоторое представление о ИТ инфраструктуре в которой работает CFD программа ( linux, C++), но не сильно в погружен в нее. Первый том этой книги пытается свести к минимуму обсуждение специфичных ИТ вопросов, однако сохранив тот минимум который потребуется для запуска примеров и понимания материала. Если отсутствуют даже элементарные зания о среде Linux и С++, то можно порекомндовать ознакомится с [6, 10]. Сведения о программировании в среде OpenFoam будут приведенны во втором томе этой книги.
[Студентам ВУЗов.]{.underline} Как ознакомительно-учебная литература по OpenFOAM, но, не как полноценный учебник по CFD. Студентам необходимо ознакомится с класической CFD литературой на русском языке [1, 3, 7].
Если усвоение математического материала вызывает трудности, то рекомендую обратится к классическим трудам из институтского курса Высшей математики [2, 4, 5, 8, 9]
[Руководителям,]{.underline} имеющих в своем подчинении отделы разработки. Для понимания возможностей OpenFOAM, планирования финансовых и временных ресурсов на CFD моделирование. Разумеется, что в этом случае рекомендуется только ознакомится с книгой и понять основные этапы CFD моделирования не погружаясь в детали. Особенно полезно для планирования ресурсов изучение Главы 5.
1.6. Как читать эту книгу#
Родная среда для OpenFOAM это Linux. Все примеры, листинги выводов команд, файлов и прочее протестированны мной в Ubuntu 22.04.
Примеры, рассматриваемые в книге в 2026 году можно скачать тут:
git clone https://gitlab.com/ofbook-/ofprimer.gitВ дальнейшем, подразумевается, что ты выполнил эту команду из домашней директории.
Светлые серые обзацы в печатном издании это код ( в он-лайн издании код выделен темно серым ). Обычно принато писать какой имено, но в этой книге всего два варианта — bash и С, так что эта строка для экономии места опущенна.
При написании книги ( а это было более 10 ! лет назад ) использовалась версия OpenFOAM 2.x, сейчас у нас 2026 год и OpenFOAM 13 версии. Я заменил синтаксис кода и разбираемых примеров на текущую версию. До 4 главы включительно, я пользовался OpenFOAM 11 версии. Все примеры должны работать как в OpenFOAM 11, так и в OpenFOAM 13. Но если что-то пойдет не так, то просто надо установить параллельно и 11 и 13.
В некоторых примерах встречаются команды или граничные условия, которые были изменнены. В примерах я подбирал аналогичные по смыслу современные команды и условия.
Все обожают маленькие желтые листочки с напоминалками, которые мы клеим на холодильник, монитор и т. д. Не будем же отказывать себе в удовольствии ! Маленькие шпаргалки ( как правило, это таблицы ), которые я рекомендую распечатать и развесить в разных местах.
Я постарался сохранить специфический CFD стиль. В уравнениях скалярные величины, такие как поток \( \phi \), набираются без специального выделения; векторы набираются жирным шрифтом (например, скорость \( U \)), в не так как нас учили в школе \( \overrightarrow{U} \); тензоры набираются жирным шрифтом с подчёркиванием (например, единичный тензор \( \underline{E} \))
2. Метод конечных объёмов в OpenFOAM#
2.1. Общий обзор метода конечных объёмов в OpenFOAM.#
Шаги неструктурированного FVM в OpenFOAM описывают стандартную процедуру численного моделирования течений жидкости: от определения расчётной области до получения решения. Физические свойства, определяющие течение жидкости, такие как давление, скорость или температура/энтальпия, являются зависимыми переменными в математической модели — формальном математическом описании течения жидкости.
Математическая модель, описывающая течение жидкости, представляет собой систему дифференциальных уравнений в частных производных (partial differential equations, PDE). Различные физические процессы часто описываются с использованием схожих математических моделей. Например, теплопроводность и диффузия концентрации сахара в воде моделируются как диффузионные процессы — математически они выглядят одинаково, хотя физика разная.
Общее уравнение переноса скаляра, описанное в (2.1), содержит члены (дифференциальные операторы), которые моделируют различные физические процессы, например: перенос частиц со скоростью жидкости (конвективный член), источник тепла (источниковый член), и т.д. Поскольку оно содержит часто встречающиеся члены, общее уравнение переноса скаляра используется для описания FVM путём дискретизации:
(2.1\( \frac{\partial\phi}{\partial t} + \nabla \cdot (\mathbf{U}\phi) - \nabla \cdot (D\nabla\phi) = S_{\phi}. \))
Здесь \( \phi \) — некоторое переносимое скалярное свойство, \( \mathbf{U} \) — заданное поле скорости, а \( D \) — коэффициент диффузии. Члены уравнения (1.1) слева направо: временной член, конвективный член, диффузионный член и источниковый член. Каждый член описывает физический процесс, который изменяет свойство \( \phi \) различным образом.
В зависимости от природы процесса, некоторые из членов могут быть опущены: например, для течения невязкой жидкости диффузионный член (перенос импульса) в уравнении движения опускается.
Кроме того, коэффициенты, которые появляются в некоторых членах, могут быть постоянными величинами, пространственно/временно изменяющимися полями или зависеть от самой физической величины. Примером такого зависимого коэффициента является зависящий от температуры коэффициент теплопроводности в уравнении теплопереноса: \( \nabla \cdot \left( k(T)\nabla T \right) \), что делает \( k \) пространственно/временно изменяющимся полем, которое зависит от решения модели (поля температуры).
Цель любого численного метода — аппроксимировать решение математической модели. Приближённое решение сложного физического процесса необходимо, поскольку точное решение может быть получено только для очень частных случаев, которые часто не имеют значения для технических или инженерных приложений.
Приближённое решение математической модели получается путём решения дискретной аппроксимации определяющей системы уравнений. Процесс аппроксимации методом конечных объёмов включает замену системы PDE соответствующей системой линейных алгебраических уравнений, которая затем может быть решена с помощью компьютера.
Построение системы алгебраических уравнений с помощью неструктурированного метода конечных объёмов состоит из двух основных шагов: дискретизации области и дискретизации уравнений.
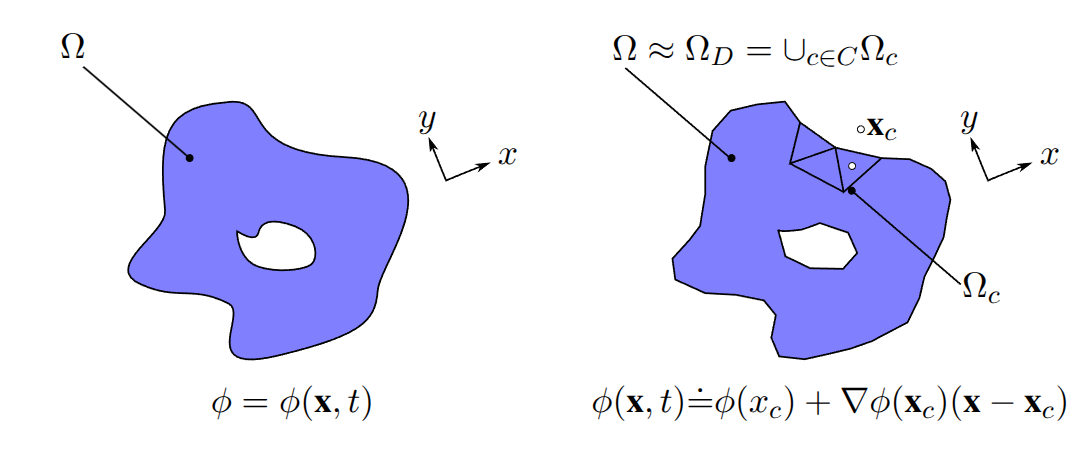 Рисунок 2.1: Непрерывная и дискретизированная
области
(a) Непрерывная расчётная область (b) Дискретизированная расчётная область
Где: \( \Omega \) — непрерывная область - \( \Omega_{D} \) — дискретизированная область (набор ячеек) - \( \Omega_{c} \) — контрольный объём (одна ячейка) - \( \mathbf{x}_{c} \) — центроид ячейки - \( \nabla\phi\left( \mathbf{x}_{c} \right) \) — градиент \( \phi \) в центроиде
2.1.1. Комментарий инженера: основное уравнение (2.1) для практиков#
Одна фраза, объясняющая всё уравнение:
«Что внутри ячейки меняется = Что влетело/вылетело со скоростью + Что размазалось (диффузия) + Что добавилось из источника»
2.1.1.1. Член 1: Временной#
\( \frac{\partial\phi}{\partial t} \) Инженерный перевод: «Как быстро всё меняется во времени».
Если член есть → расчёт нестационарный (transient). Считаем вихри, пульсации, распространение волны. Время идёт.
Если члена нет (пренебрегли) → расчёт стационарный (steady-state). Давление и скорость не меняются. Ищем «финальную картинку».
Где болит: Новички включают нестационарный решатель (pimpleFoam), ставят шаг по времени 0.1 секунды, хотя характерное время процесса 0.01 секунды. Получают «плавную картинку», которая не имеет физического смысла.
Правило большого пальца: Если в задаче есть частота \( f \) (Гц), максимальный шаг по времени \( \Delta t \leq \frac{1}{20f} \). Поставите больше — потеряете физику.
2.1.1.2. Член 2: Конвективный#
\( \nabla \cdot (\mathbf{U}\phi) \) Инженерный перевод: «Что ветер принёс и унёс через грани ячейки».
Этот член отвечает за перенос вещества/тепла/импульса потоком жидкости. Если дует ветер — тепло летит по ветру, а не против.
Где болит — выбор схемы дискретизации в fvSchemes:
| Схема | Устойчивость | Точность | Когда использовать |
| upwind | ✅ Высокая | ❌ Низкая (размазывает градиенты) | Первая итерация, грубая сетка |
| linear (central) | ❌ Низкая (осцилляции) | ✅ Высокая | Только на очень хорошей сетке |
| linearUpwind / vanLeer | ✅ Средняя | ✅ Хорошая | Основной выбор для большинства задач |
2.1.1.3. Член 3: Диффузионный#
\( \nabla \cdot (D\nabla\phi) \) Инженерный перевод: «Как само растекается в покое без ветра». Диффузия не требует движения. Это теплопроводность (тепло течёт от горячего к холодному) или вязкость (сдвиговые напряжения).
Где болит: Диффузионный член зависит от качества сетки намного сильнее конвективного. Если сетка неортогональна (углы ячеек далеки от 90°), OpenFOAM плохо считает ∇φ на гранях.
Проверяй checkMesh:
| Non-orthogonality | Что делать |
| < 70° | ✅ Обычно ок |
| 70–80° | ⚠️ Нужна коррекция: в fvSchemes добавь orthogonalCorrected |
| > 80° | ❌ Расчёт сломается или даст мусор. Перестраивай сетку |
2.1.1.4. Член 4: Источниковый#
\( S_{\phi} \) Инженерный перевод: «Что я сам добавил внутрь ячейки».
Это может быть: - нагрев электрическим током (тепловой источник) - сила тяжести (источник импульса: \( S_{U} = \rho g \)) - поршень, добавляющий массу в ячейку
Где болит: Новички забывают линеаризовать источник. Сильный нелинейный источник взрывает расчёт.
Правило: Если источник зависит от самой переменной \( \phi \) (например, тепловыделение зависит от температуры), нужно разложить:
\( S_{\phi} = S_{C} + S_{P} \cdot \phi \)где:
\( S_{\phi} \) — полный источник
\( S_{C} \) — постоянная часть источника (C =
Constant)
\( S_{P} \) — коэффициент при переменной ϕ (P
= Proportional)
\( \phi \) — сама переменная (температура,
скорость и т.д.)
Пример ошибки: Задали \( S = 1000 \cdot T \) без отрицательной обратной связи. На первой итерации температура поплыла в бесконечность, и расчёт упал.
| Член | Что значит для инженера | Где ломается чаще всего |
| Есть → нестационарный. Нет → стационарный. | Неправильный шаг по времени | |
| Ветер переносит φ | Выбрал linear на плохой сетке → осцилляции | |
| Саморастекание в покое | Неортогональность > 70° | |
| Что добавил сам | Забыл линеаризовать |
2.1.2. Комментарий инженера: ∇ (набла)#
∇ (набла) — это измеритель изменений. Он показывает, как сильно и в какую сторону меняется величина в пространстве.
Аналогия: Представьте, что вы стоите на склоне горы. ∇ — это прибор, который показывает: как круто склон (градиент) и в какую сторону быстрее всего скатится мяч (направление).
| Символ | Название | Что делает | Инженерный перевод | Где в OpenFOAM |
| Градиент | Показывает, как φ меняется в пространстве | «Крутизна поля» | gradSchemes | |
| Дивергенция | Считает, сколько φ втекает или вытекает из ячейки | «Чистый поток через грани» | divSchemes | |
| Диффузия | Считает растекание от соседей | «Саморазмазывание» | laplacianSchemes | |
| Лапласиан | Показывает отличие ячейки от соседей | «Насколько ячейка не похожа на соседей» | внутри laplacianSchemes |
2.1.3. Комментарий инженера: Лапласиан: простое математическое определение#
Лапласиан — это дифференциальный оператор второго порядка, который обозначается как \( \nabla^{2} \) (читается «набла квадрат») или \( \Delta \) или ¿ ( перевернутый знак вопроса ). Для скалярной функции \( \phi(x,y,z) \) лапласиан определяется как дивергенция градиента этой функции:
\( \nabla^{2}\phi = \nabla \cdot (\nabla\phi) \)(2.2)
Простыми словами: Сначала берём градиент от φ (получаем векторное поле), потом берём дивергенцию от этого векторного поля (получаем скаляр).
Если развернуть это определение в декартовых координатах (x, y, z), получим сумму вторых частных производных:
\( \nabla^{2}\varphi = \frac{\partial^{2}\varphi}{\partial x^{2}} + \frac{\partial^{2}\varphi}{\partial y^{2}} + \frac{\partial^{2}\varphi}{\partial z^{2}} \)Что такое вторая частная производная \( \frac{\partial^{2}\phi}{\partial x^{2}} \) ? Это просто скорость изменения наклона. Первая производная \( \frac{\partial\phi}{\partial x} \) — это наклон (крутизна). Вторая производная — это то, как быстро меняется этот наклон.
Лапласиан в точке показывает, отличается ли значение в этой точке от среднего значения вокруг неё.
Таблица 2.3: Шпаргалка. Смысл лаплассиана.
| Ситуация | Лапласиан | Что происходит |
| Точка — локальный минимум (впадина) | ∇²φ > 0 | Значение ниже, чем вокруг |
| Точка — локальный максимум (пик) | ∇²φ < 0 | Значение выше, чем вокруг |
| Точка на склоне (ровный наклон) | ∇²φ = 0 | Значение равно среднему |
Вот почему лапласиан — главный оператор в уравнениях диффузии. Он «сглаживает» поле: тепло течёт оттуда, где лапласиан отрицательный, туда, где он положительный, до тех пор, пока всюду не станет ноль.
[Примеры вычисления лапласиана:]{.underline}
Пример 1: \( T(x,y) = x^{2} + y^{2} \)
\( \nabla^{2}T = \frac{\partial^{2}\left( x^{2} + y^{2} \right)}{\partial x^{2}} + \frac{\partial^{2}\left( x^{2} + y^{2} \right)}{\partial y^{2}} = 2 + 2 = 4 > 0 \)Смысл: Функция выглядит как параболоид (чаша). В каждой точке значение ниже, чем вокруг → лапласиан положительный.
Пример 2: \( T(x,y) = - x^{2} - y^{2} \)
\( \nabla^{2}T = - 2 + ( - 2) = - 4 < 0 \)Смысл: Функция выглядит как перевёрнутая чаша (колпак). В каждой точке значение выше, чем вокруг → лапласиан отрицательный.
Пример 3: \( T(x,y) = x + y \)
\( \nabla^{2}T = 0 + 0 = 0 \)Смысл: Функция — ровная плоскость (постоянный наклон, нет изгиба). Лапласиан ноль.
2.2. Дискретизация области#
В математической модели используются непрерывные переменные. Чтобы получить приближённое решение математической модели, пространство дискретизируется на конечное число объёмов (ячеек сетки). Конечные объёмы (ячейки) образуют сетку конечных объёмов. Переход от непрерывного представления течения с непрерывными полями, заполняющими расчётную область Ω, к дискретизированной области \( \Omega_{D} \) показан на 2.1. Непрерывная область Ω аппроксимируется как объединение ячеек сетки (конечных объёмов):
\( \Omega \approx \Omega_{D} = \bigcup_{c \in C}\Omega_{c} \)где объединение \( \Omega_{D} \) — это сетка конечных объёмов, а \( C \) — множество, содержащее индексы всех ячеек в сетке \( \Omega_{D} \).
Непрерывные поля, определённые в каждой точке пространства, заполненного жидкостью (2.1 a), аппроксимируются линейно внутри конечных объёмов \( \Omega_{c} \), как показано на 2.1 b.
Каждый конечный объём хранит осреднённое по объёму значение физического свойства (например, температуры), которое привязывается к его центроиду \( x_{c} \). Привязка значения к центроиду делает дискретизацию области второго порядка точности.
Чтобы понять, почему это так, предположим, что поле φ можно представить с помощью разложения в ряд Тейлора:
\( \phi(\mathbf{x}) = \phi\left( \mathbf{x}_{c} \right) + \nabla\phi\left( \mathbf{x}_{c} \right) \cdot \left( \mathbf{x} - \mathbf{x}_{c} \right) + \nabla\nabla\phi\left( \mathbf{x}_{c} \right):\left( \mathbf{x} - \mathbf{x}_{c} \right) \otimes \left( \mathbf{x} - \mathbf{x}_{c} \right) + \ldots \) (2.3)
Выражая осреднённое по объёму значение \( \varphi(x) \) внутри ячейки \( \Omega_{c} \) с помощью разложения в ряд Тейлора (2.3), мы получаем величины, определённые в точке \( x_{c} \), которые постоянны в пределах \( \Omega_{c} \). Это приводит к:
\( \begin{array}{r} \phi_{c} = \phi\left( x_{c} \right) + \nabla\phi\frac{\left( x_{c} \right) \cdot 1}{\left| \Omega_{c} \right|}\int_{}^{}\left( x - x_{c} \right)dV \\ + \nabla\nabla\phi\left( x_{c} \right):\int_{}^{}\left( x - x_{c} \right) \otimes \left( x - x_{c} \right) + ...\ dV \end{array} \) (2.4)
Определение центроида \( x_{c} \) объёма \( \Omega_{c} \) даёт:
\( \int_{}^{}\left( x - x_{c} \right)dV = 0 \) (2.5)
Подстановка (2.5) в уравнение (2.4) даёт:
\( \phi_{c} = \phi\left( x_{c} \right) + \int_{}^{}\nabla\nabla\phi\left( x_{c} \right):\left( x - x_{c} \right) \otimes \left( x - x_{c} \right) + ...dV \) (2.6)
Уравнение (2.6) показывает, что среднее значение φ по конечному объёму \( \Omega_{c} \) точно равно значению φ в центроиде \( x_{c} \) для линейного φ, потому что для линейного φ все производные высших порядков равны нулю. Другими словами, ячейка-среднее (cell-centered) значение в центроиде конечного объёма точно восстанавливает значения линейных полей. Метод, который точно восстанавливает значения линейных функций, имеет как минимум второй порядок точности.
\( \phi_{c} \approx \frac{1}{\left| \Omega_{c} \right|}\int_{}^{}\phi_{l}\left( x_{c} \right)dV + O\left( \left\| x - x_{c} \right\|_{2}^{2} \right) \) (2.7)
Интерполяция φ, основанная на (2.6): имеет второй порядок точности, потому что самый большой член в отброшенной части ряда Тейлора в уравнении (2.6) масштабируется как:
\( \left\| X - X_{c} \right\|_{2}^{2} \)В (2.3) градиент \( \nabla\phi\left( x_{c} \right) \) в центре ячейки также должен быть аппроксимирован. Это рассмотрено в разделе о дискретизации уравнений.
Прежде чем понимать, как дискретизируются уравнения, необходимо более детально определить сетку \( \Omega_{D} \), а именно то, как ячейки\( \left\{ \Omega_{c} \right\}_{c \in C} \) связаны друг с другом, поскольку эта связность определяет, какие области могут быть дискретизированы.
2.3. Типы сеток#
Мы различаем три основных типа сеток: структурированные, блочно-структурированные и неструктурированные сетки. Все три накладывают разные требования на дискретизацию области и уравнений и различаются тем, как элементы сетки связаны друг с другом и адресуются.
Связность между элементами сетки (mesh connectivity) определяет, как осуществляется доступ к соседним элементам, что важно для дискретизации уравнений. Это также влияет на возможные оптимизации доступа к элементам сетки, которые отражаются на эффективности численных операций и на том, как эти операции могут быть распараллелены.
Например, неструктурированная адресация ячеек сетки затрудняет доступ к ячейкам в каком-либо конкретном направлении. Это усложняет построение больших шаблонов (stencils) на неструктурированных сетках, необходимых для схем интерполяции высокого порядка, потому что они полагаются на ячейка-средние значения из более широкой окрестности. Параллелизация таких интерполяций высокого порядка с использованием декомпозиции области и передачи сообщений также сложна и, вероятно, неэффективна, поскольку сообщения переменной длины должны передаваться между процессами.
Связность сетки определяет, что может быть эффективно вычислено на сетке, иногда настолько сильно, что неэффективность, вызванная выбором неправильного численного метода для конкретной сетки, делает метод непригодным для практически интересных задач, которые обычно требуют большого количества ячеек.
В OpenFOAM связность сетки также играет очень важную роль в реализации численных алгоритмов: OpenFOAM поддерживает только неструктурированные сетки.
2.3.1. Структурированные сетки#
Структурированные сетки поддерживают прямую адресацию произвольного соседа ячейки, а также прямой обход ячеек: ячейки маркируются индексами, возрастающими в направлениях осей координат (см. 2.2).
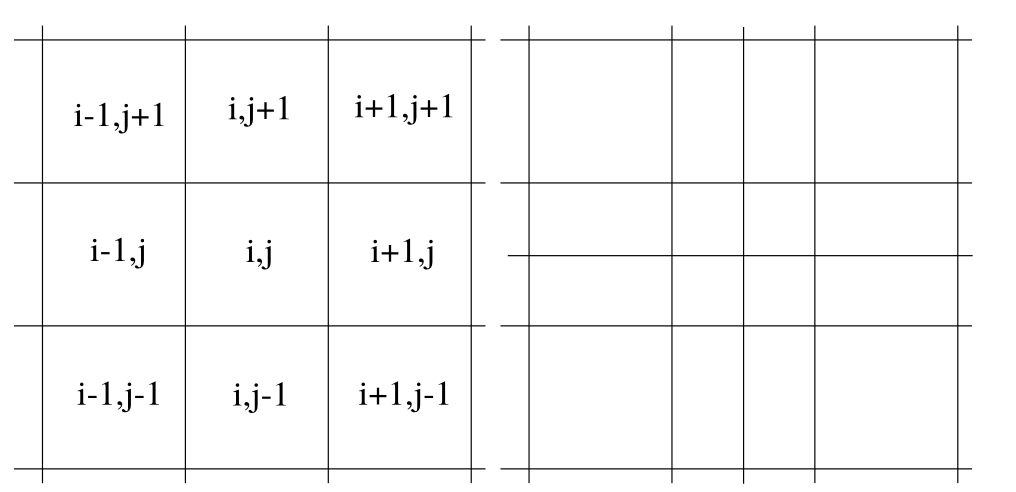 Рисунок 2.2: Структуированная квадратная сетка
(a, левая часть) Подмножество 2D равносторонней декартовой сетки
(b, правая часть) Сгущённое подмножество 2D равносторонней декартовой сетки
Связность структурированной сетки повышает абсолютную точность интерполяций, используемых в FVM, но делает сетку менее гибкой при генерации сетки для геометрически сложных областей.
В процессе генерации сетки пользователь обычно хочет создать густую сетку там, где происходят большие изменения решения, и не тратить вычислительные ресурсы на добавление ячеек в областях, где решение почти постоянно. Все этапы генерации сетки должны выполняться за максимально короткое время, что невозможно достичь со структурированными сетками без существенных доработок.
Локальное сгущение сетки практически невозможно, потому что сгущение должно быть распространено в соответствующем направлении через всю сетку. 2.2b показывает, что сгущение одной ячейки в двух направлениях порождает сгущение во всей сетке.
Структурированные сетки, соответствующие криволинейным геометриям, особенно сложны в генерации. Параметризация криволинейных границ области необходима для поддержания структурированной связности, что возможно только для относительно простых границ.
Часто такие ситуации возникают в областях с резкими изменениями параметров, когда даже порядок интерполяции, доступный на структурированной сетке, не обеспечивает достаточной точности. Например, скачкообразные изменения физических свойств наблюдаются в ударных волнах или при моделировании двухфазных течений не смешивающихся жидкостей. Между фазами формируется граница раздела, а значения физических свойств по обе стороны этой границы могут различаться на несколько порядков. Качественный пример такого распределения показан на 2.4.
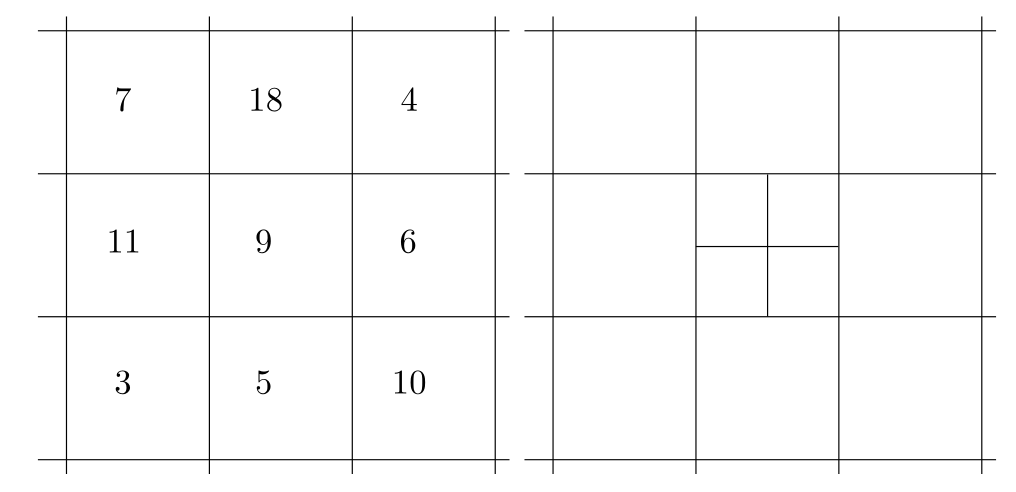 Рисунок 2.3: Не структурированная четырёхугольная
сетка
(a, левая часть) Подмножество 2D не структурированной
четырёхугольной сетки
(b, правая часть) Сгущённое подмножество 2D не структурированной
четырёхугольной сетки
2.3.2. Блочно-структурированные сетки#
Существуют расширения практики структурированной сетки, некоторые из которых позволяют локальное и динамическое сгущение сетки. Чтобы повысить точность локально, может использоваться блочно-структурированное сгущение — процесс построения сетки, состоящей из нескольких структурированных блоков с разной локальной плотностью.
К сожалению, это создаёт новое усложнение, потому что численный метод должен уметь работать с несогласованными границами блоков (висячие узлы, hanging nodes). Альтернативно, блочное сгущение должно быть тщательно выполнено так, чтобы точки на соседних блоках разной плотности идеально совпадали (patch-conforming block-meshes).
Построение блочно-структурированных сеток — сложная задача даже для простых расчётных областей. Это часто делает блочно-структурированные сетки неподходящим выбором для многих технических приложений со сложной геометрией.
2.3.3. Неструктурированные сетки#
Неструктурированные сетки, с другой стороны, не имеют явно выраженного направления (см. 2.3).
OpenFOAM реализует FVM со вторым порядком сходимости с поддержкой произвольных неструктурированных сеток. В дополнение к неструктурированной связности, ячейки произвольной неструктурированной сетки могут быть любой формы. Это позволяет пользователю дискретизировать расчётные области с очень высокой геометрической сложностью.
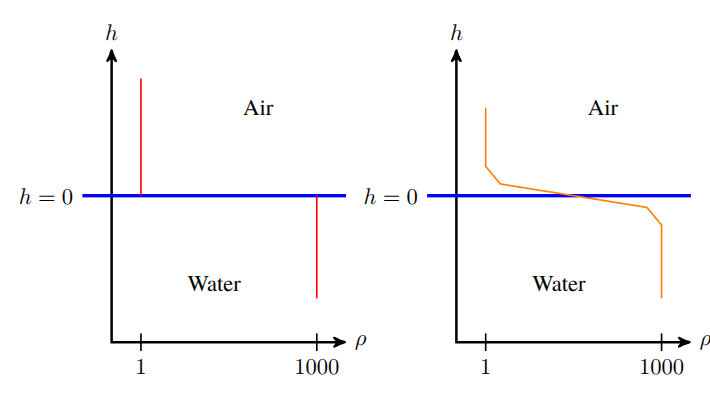
Рисунок 2.4: Качественное распределение плотности ρ по высоте h относительно свободной поверхности
(a) Непрерывное пространство со скачкообразным изменением плотности
ρ
(b) Дискретизированное пространство с плавным, но всё ещё резким
изменением плотности ρ
OpenFOAM реализует FVM со вторым порядком сходимости с поддержкой произвольных неструктурированных сеток. В дополнение к неструктурированной связности, ячейки произвольной неструктурированной сетки могут быть любой формы. Это позволяет пользователю дискретизировать расчётные области с очень высокой геометрической сложностью.
Неструктурированная сетка позволяет очень быстро, иногда даже автоматически, генерировать сетку. Это очень важно для промышленных приложений, где время получения результатов имеет большое значение.
Ещё одно преимущество неструктурированной сетки — возможность локально и напрямую сгущать ячейку, что показано на 2.3 b. Локальное сгущение эффективнее с точки зрения увеличения общей плотности сетки, поскольку увеличивает плотность только там, где это необходимо.
| Характеристика | Структурированные | Блочно-структурированные | Неструктурированные (OpenFOAM) |
| Адресация ячеек | Прямая (по индексам i, j, k) | Прямая внутри блоков | Косвенная (через списки) |
| Доступ к соседям | Простой (инкремент/декремент) | Простой внутри блоков | Сложный (требует поиска) |
| Точность интерполяций | Высокая | Высокая | Ниже (ограниченные шаблоны) |
| Локальное сгущение | Невозможно | Сложно, требует согласования | Возможно (только в нужной области) |
| Генерация для сложной геометрии | Очень сложная | Сложная | Простая |
| Производительность кода | Высокая | Высокая | Ниже (из-за косвенной адресации) |
| Поддержка в OpenFOAM | Нет | Нет | Да (только неструктурированные) |
2.4. Адресация в неструктурированных сетках OpenFOAM#
Способ, которым элементы сетки адресуются алгоритмами численного метода, определяется связностью сетки. OpenFOAM полагается на три механизма:
2.4.1. Косвенная адресация (Indirect addressing)#
Определяет, как сетка собирается из точек сетки (mesh points), которые задаются в виде глобального списка точек. Грани ячеек индексируются в глобальном списке точек с помощью целочисленных меток. Таким образом, координаты точек не повторяются для построения граней, что экономит память и повышает вычислительную эффективность.
Каждая грань — это список целочисленных индексов в глобальный список точек. Все грани в сетке хранятся в глобальном списке граней (список списков индексов — отсюда и название «косвенная адресация»).
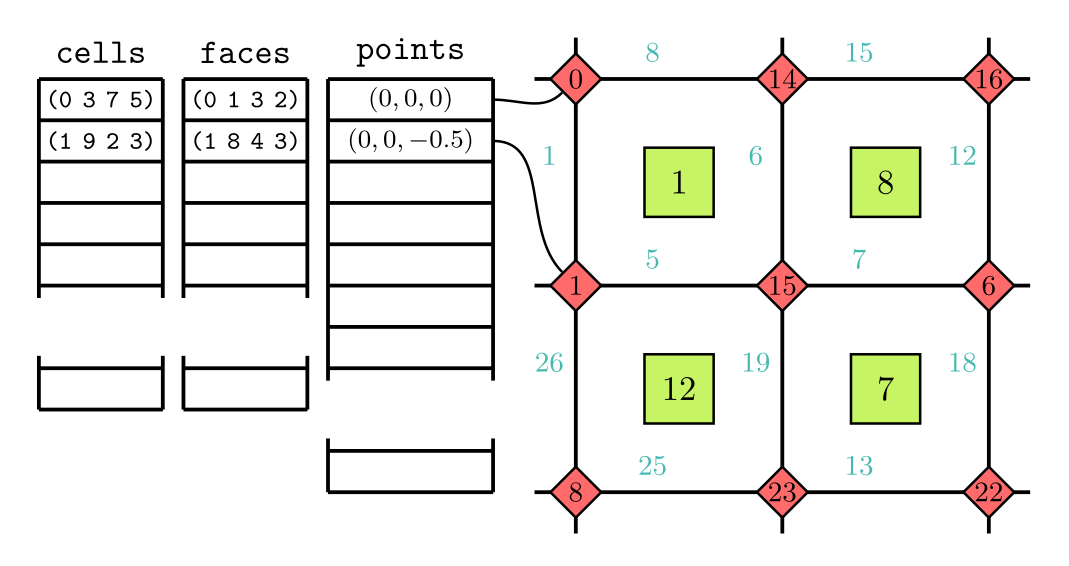 Аналогично, ячейки строятся как списки индексов,
указывающих на позиции граней в глобальном списке граней. Как и грани,
ячейки также хранятся в глобальном списке.
Рисунок 2.5: Пример связности двумерной неструктурированной сетки с метками, где для обозначения ячеек, узлов и граней использованы разные символы (квадраты, ромбы и линии)
Косвенная адресация, используемая для граней и ячеек, избегает копирования точек сетки при каждом создании экземпляра грани или ячейки. В противном случае пришлось бы иметь множество копий одних и тех же точек и граней в памяти, что было бы пустой тратой вычислительных ресурсов и сильно усложнило бы численные и топологические операции.
2.4.2. Адресация владелец-сосед (Owner-neighbor addressing)#
Определяет, какая ячейка владеет данной гранью, а какая является её соседом. Это также оптимизация доступа к граням.
Когда уравнения переноса дискретизируются с использованием неструктурированного FVM второго порядка точности, дискретизация состоит из сумм по граням для каждой ячейки с интерполяцией в центре каждой грани. Поскольку соседние ячейки разделяют грани, вычисление дискретизации для каждой грани привело бы к двум одинаковым расчётам для каждой грани, разделяемой двумя ячейками.
Чтобы избежать этого, в сетку вводятся два глобальных списка с оптимизацией owner-neighbor addressing: - face-owner (владелец грани) - face-neighbor (сосед грани)
Каждая грань может разделяться максимум двумя ячейками. Ячейка с меньшим индексом становится владельцем (owner) грани. Другая ячейка, прилегающая к грани, но с большим индексом, называется соседом (neighbor).
Вектор нормали грани \( S_{f} \) всегда направлен от владельца к соседу. Благодаря этому дискретизация вычисляется не по всем ячейкам, а по всем граням, только один раз. Вклад в центре грани затем добавляется к ячейке-владельцу и вычитается из ячейки-соседа дискретизированным дифференциальным оператором, следуя соглашению о внешней нормали.
Хотя косвенная адресация и неструктурированная связность повышают гибкость при работе со сложной геометрией и применении локального сгущения, косвенность имеет свою цену. Она снижает производительность кода, особенно по сравнению со структурированными сеточными кодами.
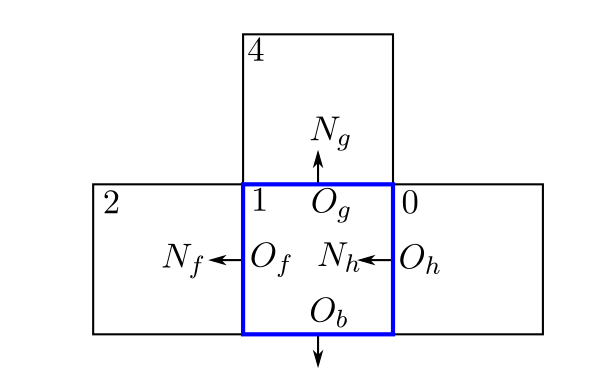
Рисунок 2.6: Адресация «владелец-сосед» на примере ячейки (выделена синей рамкой) с индексом 1, где f, g, h — метки её внутренних граней, а b — метка грани, лежащей на границе расчётной области.
2.4.3. Адресация границ (Boundary addressing)#
Заботится о том, как адресуются грани на границе расчётной области. По определению, все грани, у которых есть только одна ячейка-владелец и нет ячейки-соседа, являются граничными гранями.
Для повышения эффективности граничные грани хранятся в конце глобального списка граней и группируются в патчи (patches). Группировка граничных граней в патчи связана с применением граничных условий, которые будут разными для разных групп граничных граней.
Полная граничная сетка определяется как список граничных патчей. Это позволяет эффективно определять патчи как подмножества глобального списка граней. Такое определение граничной сетки приводит к автоматической параллелизации всего высокоуровневого кода в OpenFOAM, который полагается на интерполяцию на гранях. Поскольку у них только одна ячейка-владелец, все нормали граничной сетки направлены наружу из расчётной области.
2.5. Дискретизация времени#
Время рассматривается как дополнительное измерение расчётной области. Временной интервал [\( t_{0} \), \( t_{E} \)] (где \( t_{0} \) и \( t_{E} \) — начало и конец расчёта) дискретизируется как разбиение:
\( \left\lbrack t_{0},t_{1},t_{2},\ldots,t_{n - 1},t_{n},t_{n + 1},\ldots,t_{E} \right\rbrack \)где \( t_{n - 1} < t_{n} < t_{n + 1} \), а разность \( t_{n + 1} - t_{n} \) называется шагом по времени \( \Delta t \): - \( t_{n - 1} \) — предыдущий момент времени - \( t_{n} \) — текущий момент времени - \( t_{n + 1} \) — следующий момент времени
2.6. Комментарий инженера к 2.2, 2.3, 2.4, 2.5#
Этот раздел — математическое обоснование того, почему в OpenFOAM значения хранятся в центрах ячеек, а не в узлах или на гранях.
2.6.1. Что такое «второй порядок точности» для инженера#
Если вы измельчите сетку в два раза, ошибка уменьшится примерно в четыре раза. Это минимальный стандарт для инженерных расчётов.
Таблица 2.5: Про типы сеток — самое важное
| Тип сетки | OpenFOAM | Причина |
| Структурированная | ❌ Не поддерживается | Невозможно делать локальное сгущение |
| Блочно-структурированная | ❌ Не поддерживается | Сложная генерация, проблемы с висячими узлами |
| Неструктурированная | ✅ Только она | Гибкость, локальное сгущение, работа со сложной геометрией |
2.6.2. Адресация «владелец-сосед»: ключ к пониманию OpenFOAM.#
Эта концепция критически важна, но в книгах о ней говорят мало. Вот как это работает на пальцах:
Каждая внутренняя грань принадлежит двум ячейкам
Ячейка с меньшим номером — владелец (owner)
Ячейка с большим номером — сосед (neighbour)
Нормаль грани всегда смотрит от владельца к соседу
Почему это гениально: Когда считаем потоки через грань, мы делаем это один раз для пары ячеек, а потом добавляем вклад владельцу и вычитаем соседу. Это:
Экономит время (одно вычисление вместо двух)
Гарантирует консервативность (сколько вытекло из одной, столько втекло в другую)
Почему производительность неструктурированных сеток ниже.
Косвенная адресация означает, что данные разбросаны по памяти, а не лежат плотным массивом. Процессор постоянно дёргает оперативную память, а не кэш. На структурированных сетках можно написать цикл, который идёт по памяти линейно — это быстро. На неструктурированных — приходится прыгать по спискам индексов.
Для инженера: Расчёт на 1 млн ячеек в OpenFOAM будет медленнее, чем аналогичный расчёт в коммерческом коде на структурированной сетке. Но вы получаете возможность считать геометрию, которую на структурированной сетке вообще не построить.
2.6.3. Граничные патчи#
Граничные грани группируются в патчи, потому что на разных участках границы — разные условия: - Впускной коллектор → inlet (фиксированная скорость/давление) - Выпускной коллектор → outlet (фиксированное давление/нулевой градиент) - Стенка цилиндра → wall (прилипание, тепловой поток)
В OpenFOAM вы определяете патчи в файле constant/polyMesh/boundary. Это один из первых файлов, которые нужно править при создании нового расчёта.
2.6.4. Производные высших порядков — можно не запоминать#
Формулы (2.3)-(2.7) — чистая математика. Инженеру достаточно знать вывод: метод второго порядка точности, потому что центроидная аппроксимация убивает линейный член разложения.
Если забудете формулы — не страшно. Главное запомните: > Значение в центре ячейки — это среднее по ячейке с точностью до квадрата расстояния от центра. Для линейных полей — точно.
2.6.5. Что нужно запомнить из этого раздела#
| Концепция | Инженерный перевод |
| Второй порядок точности | Измельчил сетку в 2 раза → ошибка упала в 4 раза |
| Неструктурированная сетка | Ячейки любой формы, можно сгущать локально |
| Косвенная адресация | Экономит память, но медленнее |
| Владелец-сосед | Нормаль грани от владельца к соседу, считаем потоки 1 раз |
| Граничные патчи | Группировка граней для удобного задания условий |
2.7. Дискретизация уравнений#
Как только расчётная область разбита на конечные объёмы, к слагаемым математической модели применяются аппроксимации, превращающие дифференциальные операторы (\( \partial t \), ∇, ∇·) из уравнения (2.1) в дискретные дифференциальные операторы. Дискретные дифференциальные операторы неструктурированного МКО представляют собой линейные комбинации осреднённых по ячейкам значений (осреднённых согласно уравнению (2.7)); иными словами, они являются линейными алгебраическими уравнениями, в которых зависимыми переменными выступают значения в центрах ячеек.
Поскольку дискретизация уравнения в частных производных (ДУЧП) для ячейки \( \Omega_{c} \)даёт это ДУЧП в дискретной форме как линейную комбинацию значений в центрах её соседних ячеек, соседи влияют на решение в ячейке \( \Omega_{c} \). Так как это проделывается для каждой ячейки \( \Omega_{c} \), результатом дискретизации становится сборка глобальной системы линейных алгебраических уравнений на основе сетки \( \left( \Omega_{c} \right)_{c \in C} \) и значений \( \left\{ \phi_{c}\left( t^{n + 1} \right) \right\}_{c \in C} \), которая затем решается относительно \( {\phi_{c}\left( t^{n + 1} \right)}_{c \in C} \) . В следующем разделе описывается, как это достигается с помощью дискретизации уравнений неструктурированным МКО.
Чтобы получить алгебраическое уравнение, необходимо дискретизировать все слагаемые уравнения (2.1). Численный метод должен быть согласованным: при уменьшении размеров ячеек дискретная (алгебраическая) математическая модель должна стремиться к точной математической модели. Или бесконечное измельчение расчётной области и решение дискретизированной модели на таком пространственном разбиении приводит к решению исходной математической модели, состоящей из ДУЧП.
Чтобы получить дискретную модель, уравнение (2.1) интегрируется по
ячейке Ωc:
\( \int_{}^{}\frac{\partial\phi}{\partial t}dV + \int_{}^{}\nabla \cdot (U\phi)dV - \int_{}^{}\nabla \cdot \Gamma\nabla\phi dV = \int_{}^{}S(\phi)dV \) (2.8)
Временной член из уравнения (2.8) дискретизируется с помощью (2.7). Используя краткое обозначение \( f\left( x_{c} \right) = f_{c} \) для значений в центрах ячеек, приходим к пространственно-второму порядку точности:
\( \frac{\int_{}^{}{\partial\phi}}{\partial t}dV = \left( \frac{\partial\phi}{\partial t} \right)_{c} \vee \Omega_{c} \vee + O\left( \left\| x_{c} - x \right\|_{2}^{2} \right) \) (2.9)
Затем временной член \( \partial_{t}\phi_{c} \) можно аппроксимировать конечными разностями. В OpenFOAM доступны схема первого порядка точности по времени — обратный Эйлер, и схема второго порядка — обратная разностная схема (BDS2):
\( \left( \frac{\partial\phi_{c}}{\partial t} \right)_{c}^{n + 1} = \frac{\phi_{c}^{n + 1} - \phi_{c}^{n}}{\delta t} + O(\delta t), \) (2.10)
\( \left( \frac{\partial\phi_{c}}{\partial t} \right)_{c}^{n + 1} = \frac{3\phi_{c}^{n + 1} - 2\phi_{c}^{n} + \phi_{c}^{n - 1}}{2\delta t} + O\left( \delta t^{2} \right), \) (2.11)
где \( n + 1 \) — новый временной шаг, \( n \) — текущий, а \( n - 1 \) — предыдущий.
Наконец, используя, например, схему BDS2 второго порядка из (2.11), временной член дискретизируется как:
\( \int_{}^{}\left( \frac{\partial\phi}{\partial t} \right)^{n + 1}dV = \left| \Omega_{c} \right|\frac{3\phi_{c}^{n + 1} - 2\phi_{c}^{n} + \phi_{c}^{n - 1}}{2\delta t} + O\left( \left\| x_{c} - x \right\|_{2}^{2} \right) + O\left( \delta t^{2} \right) \) (2.12)
Конвективный (адвективный) член \( \nabla \cdot (U\phi) \) из (2.8) дискретизируется с помощью теоремы о дивергенции:
\( \int_{}^{}\nabla \cdot (U\phi)dV = \int_{}^{}\phi U \cdot nd\sigma \) (2.13)
Граница \( \partial\Omega_{c} \) ячейки \( \Omega_{c} \) в правой части (2.13) — это объединение поверхностей (граней), ограниченных отрезками (рёбрами), а именно:
\( \partial\Omega_{c} = \cup_{f \in F_{c}}S_{f} \), (2.14)
где \( F_{c} \) — множество индексов граней \( S_{f} \), образующих ячейку \( \Omega_{c} \). Тогда интеграл в правой части (2.13) можно записать как:
 \( \int_{}^{}\nabla \cdot (U\phi)dV = \sum_{}^{}{\int_{}^{}\phi}U \cdot ndo \)
(2.15)
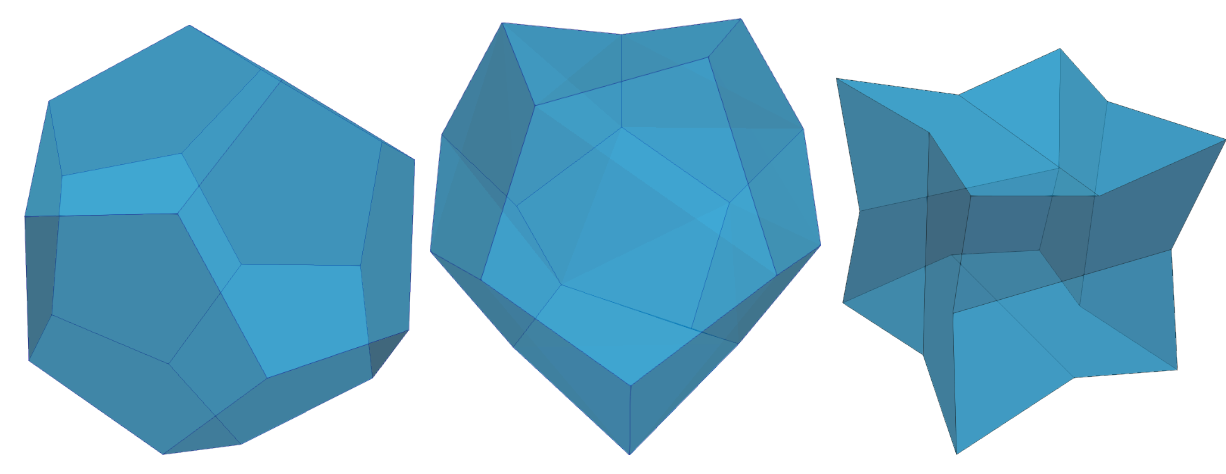
Рисунок 2.7: Примеры додекаэдрических ячеек: выпуклый додекаэдр, невыпуклый додекаэдр с неплоскими гранями, не выпуклый додекаэдр с плоскими, но невыпуклыми гранями.
(a, лево) Правильная додекаэдрическая ячейка.
(b, центр) Невыпуклая додекаэдрическая ячейка.
(c, право) Эндо-додекаэдрическая ячейка.
Грани \( S_{f} \) ячейки \( \Omega_{c} \) являются плоскими многоугольниками, если \( \Omega_{c} \) — выпуклый многогранник (тетраэдр, куб, прямоугольный параллелепипед и т.п.), как, например, додекаэдр на 2.1 а. Но \( \Omega_{c} \) может быть и «обобщённым многогранником»: не выпуклым объёмом, ограниченным гранями, которые сами могут быть неплоскими либо плоскими, но не выпуклыми. Например, не выпуклый додекаэдр на 2.1 b не выпуклый именно из-за того, что его грани не плоские. Эндо-додекаэдр на 2.1c не выпуклый потому, что его грани, хоть и плоские, но не выпуклые. Алгоритмы построения полиэдральных сеток часто создают неплоские многогранники вроде изображённого на 2.1 b. Грани \( S_{f} \) такого многогранника — это нелинейные линейчатые поверхности, ограниченные отрезками (рёбрами сетки), что хорошо видно на верхней грани неплоского многогранника. Эндо-додекаэдр не так важен для построения полиэдральных сеток, хотя теоретически может появиться.
Чтобы избежать введения обработки особых случаев при дискретизации, в OpenFOAM все ячейки \( \Omega_{c} \) рассматриваются как обобщённые многогранники. Все грани ячеек линеаризуются: центроид каждой многоугольной грани используется для разложения её на набор треугольников. Это, разумеется, не вносит ошибок, если ячейка \( \Omega_{c} \) действительно выпуклый многогранник. Если же \( \Omega_{c} \) — обобщённый многогранник с неплоскими гранями, триангуляция граней через их центроид вносит погрешность аппроксимации в правую часть уравнения (2.15).
Для дальнейшей дискретизации (2.15) для каждой грани \( S_{f} \) выполняется осреднение \( \varphi \), аналогичное двумерному эквиваленту осреднения (2.7), в центре \( x_{f} \) грани \( S_{f} \):
\( \phi_{f} = \frac{1}{\left| S_{f} \right|}\int_{}^{}\phi ds + O\left( \left\| x - x_{f} \right\|_{2}^{2} \right) \) (2.16)
где \( \phi_{f} = \phi\left( x_{f} \right) \). Подстановка (2.16) в (2.15) даёт:
\( \int_{}^{}\nabla \cdot (U\phi)dV = \sum_{}^{}\phi_{f}U_{f} \cdot S_{f} + O\left( \left\| x - x_{f} \right\|_{2}^{2} \right) \) (2.17)
пространственно-второй порядок точности дискретизации дивергентного члена из уравнения (2.1). В OpenFOAM используется так называемая совмещённая дискретизация: все зависимые переменные в системе линейных алгебраических уравнений хранятся в центрах ячеек. Поэтому осреднённые по граням величины в правой части (2.17) выражаются через значения в центрах двух соседних по грани ячеек для каждой грани \( S_{f} \).
ИНФОРМАЦИЯ Осреднённые по граням величины в неструктурированном МКО, как и величины в центрах ячеек, имеют второй порядок точности.
Рассмотрим схематичное изображение грани f и двух её соседних ячеек — владельца \( O_{f} \) и соседа \( N_{f} \) — на двумерной треугольной сетке (2.8). Если значение \( \varphi_{f} \) в центре грани выражается с помощью линейной интерполяции (Central Differencing Scheme, CDS), имеем:
\( \phi_{f} = \phi_{O_{f}} + \frac{\phi_{N_{f}} - \phi_{O_{f}}}{\left| d_{f} \right|_{2}}\left| x_{f} - x_{O_{f}} \right|_{2} \) (2.18)
\( w_{f}\phi_{N_{f}} + \left( 1 - w_{f} \right)\phi_{O_{f}} \)= (2.19)
где \( d_{f} = x_{N_{f}} - x_{O_{f}} \), \( \frac{1}{\left\| d_{f} \right\|_{2}} \) — так называемый дельта-коэффициент в OpenFOAM, а \( w_{f}, \) вычисленное по CDS, является линейным коэффициентом грани:
\( w_{f,CDS} = \frac{\left\| x_{f} - x_{O_{f}} \right\|_{2}}{\left\| d_{f} \right\|_{2}} \) (2.20)
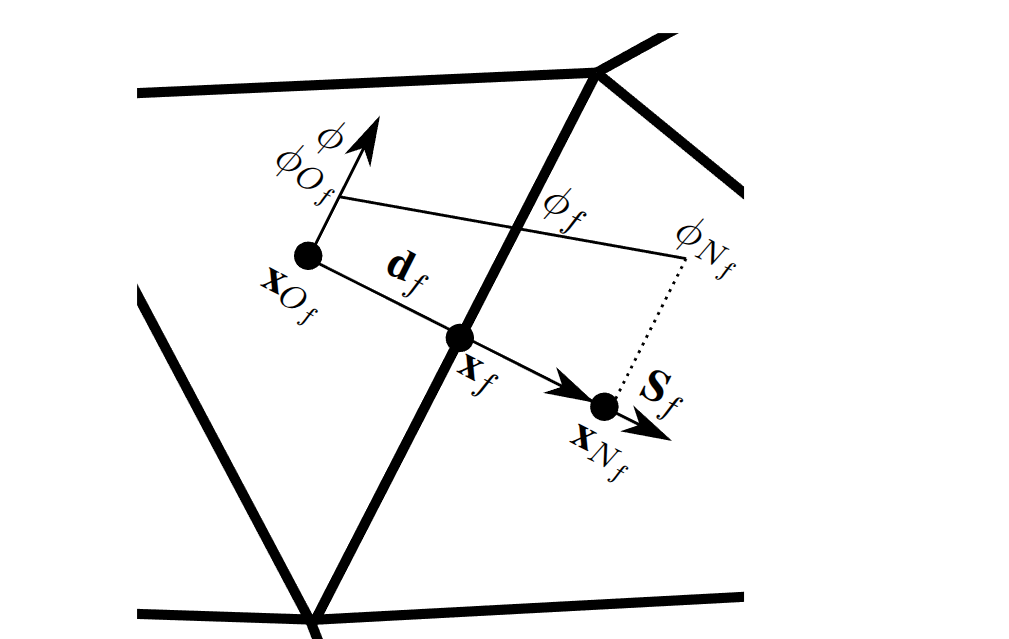 Рисунок 2.8: Схема интерполяции центральными
разностями (CDS), применённая на ортогональной треугольной сетке.
Граневый коэффициент \( w_{f} \in \lbrack 0,1\rbrack \) можно вычислять по-разному. Способ вычисления \( w_{f} \) определяет порядок точности дискретизированного дивергентного члена и влияет на численную устойчивость приближённого решения. Например, для конвективного члена можно использовать противопоточную (upwind) схему, в которой \( w_{f} \) определяется по значению в центре подветренной (вверх по потоку) относительно f ячейки:
\( w_{f,upwind} = 1,еслиF_{f} > 0;0,иначе1 \) (2.21)
,где \( F_{f} \) — скалярный объёмный поток в точке \( x_{f} \):
\( F_{f} = U_{f} \cdot S_{f} \) (2.22)
Если скорость \( U \) задана (не является зависимой переменной в (2.1)), она выражается в (2.17) точно так же, как \( \phi_{f} \) — либо линейной интерполяцией (CDS), либо иной комбинацией значений соседей по грани из (2.19).
Вычисление осреднённого по грани значения как комбинации величин в
центрах соседних ячеек (например, по CDS (2.18)), а также скалярного
объёмного потока (2.22) приводит к дискретному оператору дивергенции
∇c·(·) в виде:
\( \nabla_{c} \cdot (U\phi): = \int_{}^{}\nabla \cdot (U\phi)dV \approx \sum_{}^{}F_{f}\left\lbrack w_{f}\phi_{N_{f}} + \left( 1 - w_{f} \right)\phi_{O_{f}} \right\rbrack \) (2.23)
где Fc — множество индексов всех граней ячейки Ωc.
До сих пор не делалось никаких предположений об ориентации нормалей к
границе ячейки \( \partial\Omega_{c} \) или её
дискретного аналога — ориентации векторов нормальной площади
\( S_{f} \) граней из
\( F_{c} \). Однако в OpenFOAM дискретизация
операторов дивергенции/диффузии из (2.1) (уравнение (2.8)) не
выполняется суммированием по всем граням ячейки (набор индексов Fc);
векторы нормалей к границам ячейки также не ориентированы единообразно
(только наружу или только внутрь) для каждой ячейки. Для каждого центра
грани определён единственный вектор
\( S_{f} \). Это исключает единообразие нормалей,
потому что для одной из двух ячеек, примыкающих к грани f,
\( S_{f} \) окажется направленным внутрь.
Дискретный оператор дивергенции ∇c·(·) реализован в OpenFOAM с
использованием адресации «владелец-сосед». Вектор
\( S_{f} \), показанный на 2.8, — это вектор
нормальной площади поверхности, всегда направленный от ячейки-владельца
\( O_{f} \) к ячейке-соседу
\( N_{f} \) (см. 2.6). Это очень важный аспект
реализации неструктурированного МКО в OpenFOAM.
Теорема о дивергенции предполагает единообразную ориентацию нормали границы \( \partial\Omega_{c} \) в (2.13): нормаль \( n \) может быть направлена либо наружу, либо внутрь по отношению к \( \Omega_{c} \), при этом в OpenFOAM принято соглашение о внешней нормали. Дискретизация дивергентного члена по (2.23) даёт сумму по всем граням ячейки \( \Omega_{c} \). Если бы дискретизация выполнялась для каждой ячейки по отдельности, обеспечение единообразия ориентации нормалей было бы затруднительным. Например, для ячейки 1 на 2.6 один из векторов нормальной площади ориентирован внутрь именно из-за адресации «владелец-сосед». Любое другое определение единственного вектора \( S_{f} \) всё равно заставило бы его указывать из одной ячейки в другую, то есть внутрь одной из них. Адресация «владелец-сосед», однозначно задаёт ориентацию нормали по индексам соседних по грани ячеек: ячейка-владелец имеет меньший индекс, чем ячейка-сосед.
Возникает вопрос: как выполнить дискретизацию дивергентного члена по (2.23), если часть граней ячейки (например, ячейки 1 на 2.6) ориентирована наружу, а часть — внутрь?
Поскольку вектор \( S_{f} \) всегда направлен из
ячейки с меньшим индексом Of (владелец грани) в ячейку с большим
индексом Nf (сосед грани), вклады в сумму из правой части (2.23)
добавляются к владельцу грани и вычитаются из соседа грани f для каждой
грани f в сетке. Для этого вводятся два индексных множества: множество
владельцев (ячеек-владельцев) O и множество соседей (ячеек-соседей) N:
\( O: = \left\{ O_{f}:O_{f} < N_{f} \right\} \) для
каждой грани f в сетке {Ωc}{c∈C} (2.24)
\( N: = \left\{ N_{f}:O_{f} < N_{f} \right\} \) для
каждой грани f в сетке {Ωc}{c∈C} (2.25)
Индексные множества O, N из (2.24) и (2.25) содержат соответственно
метки ячеек-владельцев и ячеек-соседей для каждой грани в сетке, а не
для каждой грани отдельной ячейки, как Fc в (2.23). Это позволяет
выполнить то же самое вычисление, что и в (2.23), даже когда векторы
нормалей \( S_{f} \) ячейки не все направлены
наружу или внутрь. Для каждого индекса грани f ∈ F:
\( \begin{array}{r} \nabla_{O_{f}} \cdot (U\phi) = \nabla_{O_{f}} \cdot (U\phi) + \left\lbrack \left( w_{f}\phi_{N_{f}} + \left( 1 - w_{f} \right)\phi_{O_{f}} \right)F_{f} \right\rbrack \\ \nabla_{N_{f}} \cdot (U\phi) = \nabla_{N_{f}} \cdot (U\phi) - \left\lbrack \left( w_{f}\phi_{N_{f}} + \left( 1 - w_{f} \right)\phi_{O_{f}} \right)F_{f} \right\rbrack \end{array} \) (2.26)
где F — множество индексов всех граней в сетке,
\( O_{f} \) — индекс ячейки-владельца грани из O
(2.24), \( N_{f} \) — индекс ячейки-соседа грани
из N (2.25), а ∇·· — дискретный оператор дивергенции из (2.23).
ИНФОРМАЦИЯ Дискретизация оператора дивергенции по (2.23) удобна для понимания неструктурированного метода конечных объёмов, тогда как фактические вычисления в OpenFOAM выполняются по (2.26).
ИНФОРМАЦИЯ Доступ к индексным множествам владельцев и соседей в сетке можно получить с помощью функций-членов owner() и neighbour() класса fvMesh.
Как показано на 2.6 для ячейки 1, грани на границе области имеют только ячейку-владельца. Поскольку у такой грани нет ячейки-соседа, в (2.26) для неё не будет члена −\( F_{f}w_{f}\phi_{N_{f}} \). Чтобы избежать проверок на принадлежность границы, граничные грани (грань b на 2.6) хранятся в OpenFOAM отдельно от внутренних.
Лапласовский (диффузионный) член из (2.1) дискретизируется
аналогично дивергентному (адвективному). Дискретизация начинается с
интегрирования по Ωc и применения теоремы о дивергенции. Используя
краткие обозначения
\( \Gamma_{f}: = \Gamma\left( x_{f} \right) \),
\( \nabla\phi\left( x_{f} \right): = (\nabla\phi)_{f} \),
получаем:
\( \int_{}^{}\nabla \cdot \Gamma\nabla\phi dV = \sum_{}^{}\Gamma_{f}(\nabla\phi)_{f} \cdot S_{f} + O\left( \left\| x - x_{f} \right\|_{2}^{2} \right) \) (2.27)
где член погрешности второго порядка точности по пространству возникает из-за осреднения по грани (2.16).
Следующий шаг дискретизации лапласиана — дискретизация градиента \( (\nabla\phi)_{f} \). Градиент в центре грани \( (\nabla\phi)_{f} \) в (2.27) не интерполируется из градиентов в центрах соседних ячеек. Вместо этого используются ряды Тейлора от центра грани \( x_{f} \) к центрам ячейки-владельца и ячейки-соседа.
Вводятся краткие обозначения: \( x_{O_{f}} - x_{f}: = x_{f}x_{O_{f}} \) и \( \phi O_{f}: = \phi\left( xO_{f} \right) \)
(аналогично для \( N_{f} \), f), а также тензорное произведение вектора \( a \):
\( a^{n}: = \underset{(n)}{\overset{(a \otimes a \otimes a)}{\underbrace{}}},\ n \in \text{ℕ}^{\text{+}} \)Тогда ряды Тейлора от центра грани к владельцу и соседу:
\( \phi_{O_{f}} = \phi_{f} + (\nabla\phi)_{f} \cdot x_{f}x_{O_{f}} + \frac{1}{2}\left( \nabla^{2}\phi \right)_{f}:x_{f}x_{O_{f}}^{2} + \frac{1}{6}\left( \nabla^{3}\phi \right)_{f}:x_{f}x_{O_{f}}^{3} + ... \) (2.28)
\( \phi_{N_{f}} = \phi_{f} + (\nabla\phi)_{f} \cdot x_{f}x_{N_{f}} + \frac{1}{2}\left( \nabla^{2}\phi \right)_{f}:x_{f}x_{N_{f}}^{2} + \frac{1}{6}\left( \nabla^{3}\phi \right)_{f}::x_{f}x_{N_{f}}^{3} + ... \) (2.29)
Вычитая (2.28) из (2.29), получим:
\( \begin{array}{r} (\nabla\phi)_{f} \cdot \left( x_{f}x_{N_{f}} - x_{f}x_{O_{f}} \right) = \phi_{N_{f}} - \phi_{O_{f}} - \frac{1}{2}\left( \nabla^{2}\phi \right)_{f}:\left( x_{f}x_{N_{f}}^{2} - x_{f}x_{O_{f}}^{2} \right) \\ - \frac{1}{6}\left( \nabla^{3}\phi \right)_{f}::\left( x_{f}x_{N_{f}}^{3} - x_{f}x_{O_{f}}^{3} \right) + ... \end{array} \) (2.30)
на эквидистантных сетках, подобных показанной на 2.8, центры граней \( x_{f} \) делят вектор \( d_{f} = x_{N_{f}} - x_{O_{f}} \) пополам, так что:
\( X_{f}X_{N} = - X_{f}X_{O_{f}} = \frac{1}{2}d_{f} \) (2.31)
Подстановка (2.31) в (2.30), умножение результата скалярно на
\( d_{f} \) и деление на ||df||² обнуляет
член второго порядка в (2.30):
\( \begin{array}{r} (\nabla\phi)_{f} = \frac{\phi_{N_{f}} - \phi_{O_{f}}}{\left| d_{f} \right|_{2}}{\hat{d}}_{f} - \frac{1}{2}\left( \nabla^{2}\phi \right)_{f}:\frac{\left( \left( 0.5d_{f} \right)^{2} - \left( 0.5d_{f} \right)^{2} \right) \cdot d_{f}}{\left\| d_{f} \right\|_{2}^{2}} \\ - \frac{1}{24}\left( \nabla^{3}\phi \right)_{f}::\frac{\left( d_{f}^{3} \right) \cdot d_{f}}{\left\| d_{f} \right\|_{2}^{2}} + ... \end{array} \) (2.32)
что приводит к окончательной дискретизации градиента в центре грани:
\( (\nabla\phi)_{f} \approx \frac{\phi_{N_{f}} - \phi_{O_{f}}}{\left| d_{f} \right|_{2}}{\hat{d}}_{f} - \frac{1}{24}\left( \nabla^{3}\phi \right)_{f}::\left( {\hat{d}}_{f}^{3} \right) \cdot {\hat{d}}_{f}\left\| d_{f} \right\|_{2}^{2} \) (2.33)
Уравнение (2.33) демонстрирует второй порядок точности градиента в центре грани по \( {\left\| d_{f} \right\|_{2}}^{2} \), но только на эквидистантных сетках, удовлетворяющих условию (2.31), и для достаточно гладких φ, допускающих разложение в ряд Тейлора. Если условие (2.31) не выполняется, наибольший член погрешности в (2.33) содержит вклад \( ½\left( \nabla^{²}\phi \right)f:\left( x_{f}x_{N_{f}}² - x_{f}x_{O_{f}}^{²} \right) \) из (2.30), что делает дискретизацию схемой лишь первого порядка точности.
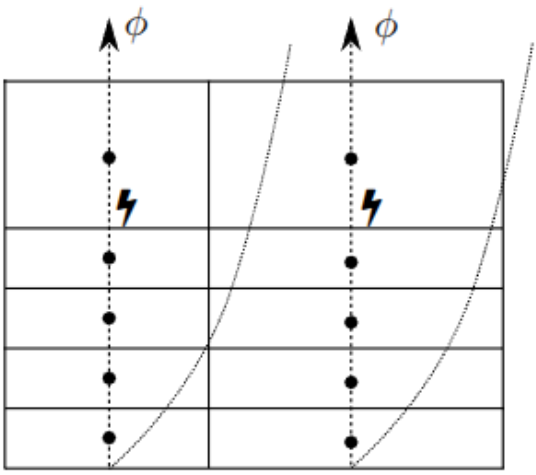
Рисунок 2.9: Потеря точности дискретизации градиента в пограничном слое, вызванная отличием соотношения сторон от 0.5 для граней, помеченных молнией, в области сильного изменения φ в вертикальном направлении.
ИНФОРМАЦИЯ. Иными словами, в областях, где ожидаются сильные изменения φ, желательно, чтобы отношение \( \frac{\left\| x_{f}x_{N_{f}} \right\|_{2}}{\left\| x_{O_{f}}x_{N_{f}} \right\|_{2}} \) было равно 0.5 — тогда выполняется (2.31) и достигается второй порядок точности согласно (2.33). Более сильное сгущение сетки допустимо там, где \( \left( \nabla^{²}\phi \right)_{f} \) пренебрежимо мало и практически не влияет на сходимость решения второго порядка.
Рассмотрим 2.9: \( \phi \) сильно меняется в вертикальном направлении, и пограничный слой воспроизводит это изменение. Однако пограничный слой заканчивается до того, как \( \phi \) перестанет сильно меняться, и дискретизация градиента на гранях, помеченных молнией, вносит погрешность первого порядка, потому что соотношение сторон отличается от 0.5. С другой стороны, в горизонтальном направлении на рис. 1.9 \( \phi \) не меняется совсем, поэтому там отличие соотношения сторон от 0.5 практически не сказывается на точности решения.
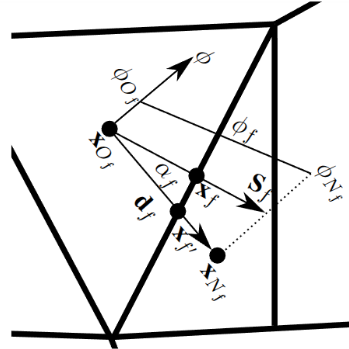
Рисунок 2.10: 2D неортогональная сетка
С полученной по (2.33) аппроксимацией \( (\nabla\phi)_{f} \) второго порядка точности дискретизация лапласиана завершается подстановкой (2.33) в (2.27), что даёт дискретизацию МКО лапласовского (диффузионного) члена со вторым порядком:
\( \int_{}^{}\nabla \cdot \Gamma\nabla\phi dV \approx \sum_{}^{}\Gamma_{f}\frac{\left( {\hat{d}}_{f} \cdot S_{f} \right)}{\left\| d_{f} \right\|_{2}}\left( \phi_{N_{f}} - \phi_{O_{f}} \right) \) (2.34)
Дискретизацию лапласиана (2.34) можно упростить, если векторы и \( {\hat{d}}_{f} \) и \( \hat{S_{f}} \) коллинеарны (\( \hat{d_{f}} \)·\( \hat{S_{f}} \) = 1), то есть если сетка ортогональна:\( \int_{}^{}\nabla \cdot \Gamma\nabla\phi dV \approx \sum_{}^{}\Gamma_{f}\frac{\left\| S_{f} \right\|_{2}}{\left\| d_{f} \right\|_{2}}\left( \phi_{N_{f}} - \phi_{O_{f}} \right) \) (2.35)
Неортогональная сетка показана на 2.10: на грани \( S_{f} \) векторы (\( \hat{d_{f}} \), \( \hat{S_{f}} \)) не коллинеарны и образуют так называемый угол неортогональности \( \alpha_{f} \) := ∠(\( \hat{d_{f}} \), \( \hat{S_{f}} \)). Неортогональность вносит погрешность в уравнение (2.35), и эта погрешность корректируется с помощью дискретизации градиента в центре ячейки, основанной на теореме Гаусса о дивергенции. Градиент в центроиде ячейки можно продискретизировать как:
\( \int_{}^{}\nabla\phi dV = \int_{}^{}\phi \cdot ndS = \sum_{}^{}\phi_{f} \cdot S_{f} + O\left( h_{c}^{2} \right): = (\nabla\phi)_{c} \) (2.36)
со вторым порядком точности, обеспечиваемым осреднением по грани (2.16) и линейной интерполяцией (2.18). Градиент, продискретизированный таким способом в центроиде ячейки, обозначается \( (\nabla\phi)_{c} \). Если затем (2.36) линейно проинтерполировать по формуле (2.18) на центр грани, а именно:
\( (\nabla\phi)_{f} = w_{f}(\nabla\phi)_{N_{f}} + \left( 1 - w_{f} \right)(\nabla\phi)_{O_{f}} + O\left( h_{f}^{2} \right) \) (2.37)
то градиент в центре грани сохраняет второй порядок точности от градиентов в ячейке-владельце и соседе по (2.36), поскольку линейная интерполяция ограничена и сохраняет порядок погрешности \( O\left( h^{2} \right) \) из ячеек \( N_{f} \) и \( O_{f} \). Для краткости член второго порядка точности в (2.36) упрощён до \( O(h²) \): на общих неструктурированных сетках выражение сложнее.
Ошибку можно грубо оценить максимальными величинами, такими как \( \overset{\sim}{h_{c}} = \max_{f \in F_{c}}\left\| d_{f} \right\|_{2} \) и \( h_{f} = \max_{p \in F_{p}}\left\| x_{p} - x_{f} \right\|_{2} \) где \( F_{p} \) — множество всех точек грани. Даже если положить \( h = \max\left( \overset{\sim}{h_{c}},\max_{f \in F_{c}}\left( h_{f} \right) \right) \), можно видеть, что линейная интерполяция градиента Гаусса из центров ячеек сохраняет второй порядок точности при условиях, задаваемых (2.31).
Аппроксимация градиента в центре грани по (2.36) не используется в (2.27) для дискретизации лапласиана, потому что (2.37) может вызывать так называемый шахматный эффект (checkerboarding). Шахматный эффект — это неспособность дискретизации вычислить \( (\nabla\phi)_{c} \) из-за искусственного сокращения в (2.37) в некоторых случаях.
В качестве простейшего примера рассмотрим пять одномерных конечных объёмов с метками (0, 1, 2, 3, 4), с единичным расстоянием между ними и распределением φ в их центрах: (50, 100, 50, 100, 50). Если градиенты в центрах ячеек \( (\nabla\phi)_{₁} \), \( (\nabla\phi)_{₃} \) вычислить по (2.18) и (2.36) с ориентацией нормали по адресации «владелец-сосед» \( \left( n_{₀,₁} = n_{₁,₂} = n_{₂,₃} = n_{₃,₄} = 1 \right), \) получатся градиенты \( (\nabla\phi)_{₁} \) = −75 + 75 = 0 и \( (\nabla\phi)_{₃} \) = −75 + 75 = 0. Эти ложные нули, проинтерполированные далее по (2.37), дадут нулевые градиенты на гранях. Если же вычислить \( (\nabla\phi)_{(₀,₁)} \) напрямую по (2.37), получится \( \frac{(50 - 100)}{1} = - 50 \neq 0 \), и то же для \( (\nabla\phi)_{(1,2)} \). Пример искусственный, но он показывает, что дискретизация может игнорировать осцилляции решения между двумя соседними ячейками. В реальности такие осцилляции — например, пульсации давления от цепочки мелких (недоразрешённых сеткой) вихрей — вполне могут быть частью решения. Именно поэтому градиент в центре грани не вычисляют по (2.37): это чревато шахматным эффектом.
ИНФОРМАЦИЯ
Линейно проинтерполированный градиент в центре грани по (2.37) можно
использовать для коррекции неортогональности в (2.35). Обычно
применяются три подхода к разложению вектора нормальной площади:
минимальная коррекция, ортогональная коррекция и коррекция с верхней
релаксацией. Все три подхода раскладывают вектор нормальной площади
\( S_{f} \) на ортогональную часть
\( S_{f}^{\bot} \), коллинеарную
\( d_{f} \), и неортогональную часть
\( S_{f}^{\boxed{\bot}} \) в в т.е.:
\( (\nabla\phi)_{f} \cdot S_{f} = (\nabla\phi)_{f}^{\bot} \cdot S_{f}^{\bot} + (\nabla\phi)_{f}^{\boxed{\bot}} \cdot S_{f}^{\boxed{\bot}} \) (2.38) так что:
\( S_{f} = S_{f}^{\bot} + S_{f}^{\boxed{\bot}} \) (2.39)
Различные способы вычисления \( S_{f}^{\bot} \) показаны на рис. 1.11, а \( S_{f}^{\boxed{\bot}} \) вычисляется из (2.39).
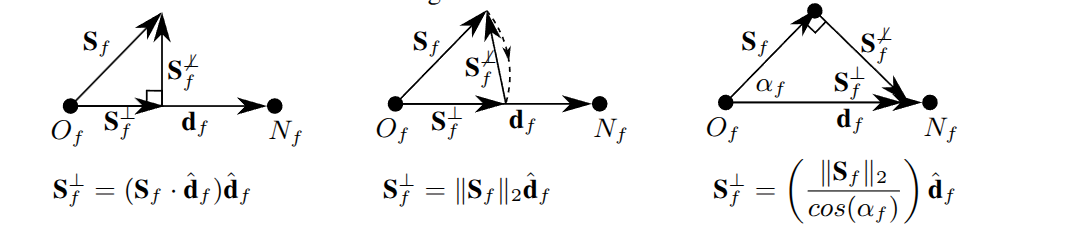 Рисунок 2.11: Коррекции неортогональности
1) минимальная 2) ортогональная 3) коррекция с верхней релаксацией
Ортогональный вклад \( (\nabla\phi)_{f}^{\bot} \) в (2.40) вычисляется по (2.33) с участием двух соседних по грани ячеек и дискретизируется неявно. Неортогональный вклад \( (\nabla\phi)_{f}^{\boxed{\bot}} \) дискретизируется явно:
\( (\nabla\phi)_{f}\left( t^{n + 1} \right) \cdot S_{f} = (\nabla\phi)_{f}^{\bot}\left( t^{n + 1} \right) \cdot S_{f}^{\bot} + (\nabla\phi)_{f}^{\boxed{\bot}}\left( t^{n} \right) \cdot S_{f}^{\boxed{\bot}} \) (2.40)
Это, однако, некорректно, так как ортогональный и неортогональный вклады вычислены на разных временных шагах. Чтобы скорректировать несоответствие между \( t_{n + 1} \) и \( t_{n} \) в (2.40), в OpenFOAM неортогональные поправки выполняются с помощью фиксированного числа M дополнительных итераций внутри каждого временного шага:
\( (\nabla\phi)_{f}\left( t^{n + 1} \right) \cdot S_{f} = (\nabla\phi)_{f}^{\bot}\left( t^{n + 1} \right) \cdot S_{f}^{\bot} + (\nabla\phi)_{f}^{\boxed{\bot}}\left( t^{m} \right) \cdot S_{f}^{\boxed{\bot}} \), m=1,2,3,...M (2.41)
в надежде, что после M итераций \( (\nabla\phi)_{f}^{\boxed{\bot}}\left( t^{M} \right) = (\nabla\phi)_{f}^{\boxed{\bot}}\left( t^{n + 1} \right). \) Итерации для неортогональной коррекции играют важную роль в алгоритмах связывания давления и скорости, где лапласиан используется в уравнении Пуассона для давления. Поэтому в конфигурационных файлах OpenFOAM для таких алгоритмов предусмотрен соответствующий параметр.
ИНФОРМАЦИЯ Число итераций M для неортогональной коррекции в уравнении Пуассона для давления задаётся в файле system/fvSolution.
ИНФОРМАЦИЯ Сведения об угле неортогональности неструктурированной сетки OpenFOAM выдаются утилитой checkMesh.
ИНФОРМАЦИЯ В общем случае, если сетка неортогональна, она также и не эквидистантна, а значит, условие (2.31) не выполняется и аппроксимация градиента в центрах граней становится схемой первого порядка.
В общем случае неортогональность сетки смещает точку пересечения отрезка \( x_{O_{f}} \) \( x_{N_{f}} \) и грани \( S_{f} \) (точка \( x_{f}' \) на 2.10) относительно центроида грани \( x_{f} \), используемого для осреднения по \( S_{f} \) в (2.16). Уравнение (2.16) предполагает, что осреднённое по грани значение привязано к её центроиду — это необходимо для второго порядка точности. Поскольку же интерполяция фактически происходит в точке \( x_{f}' \), возникает так называемая ошибка скошенности (skewness error).
ИНФОРМАЦИЯ В научной литературе предложены различные методы борьбы с ошибкой скошенности, но в стандартной поставке OpenFOAM ни один из них не реализован по умолчанию, поэтому здесь ошибка скошенности подробно не рассматривается.
2.7.1. Комментарий инженера: к разделу 3.7 (с элементами математики)#
2.7.1.1. Зачем нужна дискретизация и что получается в итоге (к началу раздела)#
Исходное уравнение в частных производных описывает физику в каждой точке сплошной среды — бесконечное число точек, бесконечное число уравнений. Компьютер так не умеет. Мы режем область на конечное число ячеек и для каждой записываем тот же закон сохранения, но в интегральной форме: «сколько пришло минус сколько ушло равно сколько осталось». Интегралы и производные заменяются на суммы и разности значений в центрах ячеек. Результат — огромная система линейных уравнений Ax = b, где x — вектор искомых значений (температур, скоростей) во всех ячейках на новом временном шаге. Матрица A — разреженная: у каждой строки всего несколько ненулевых элементов (столько, сколько граней у ячейки).
2.7.1.2. Согласованность#
Согласованность — это требование: когда размер ячейки стремится к нулю, наше упрощённое алгебраическое уравнение должно стремиться к исходному дифференциальному. Проверяется это математически через разложение в ряд Тейлора: подставляем точное решение в дискретную формулу и смотрим, с какой скоростью убывает невязка (ошибка) при уменьшении шага сетки. Если невязка ~ h (где h — размер ячейки) — метод первого порядка; если ~ h² — второго. Второй порядок означает, что при измельчении сетки вдвое ошибка падает вчетверо.
2.7.1.3. Дискретизация по времени (к формулам 3.10–3.11)#
Обратный Эйлер (3.10): берём значение на новом шаге и значение на текущем, разность делим на δt. Просто, надёжно, но грубовато — ошибка ~ δt. BDS2 (3.11): используем три момента времени (новый, текущий, предыдущий), что позволяет учесть «кривизну» изменения φ во времени. Ошибка ~ δt². Плата за точность: BDS2 менее устойчива, чем обратный Эйлер. При большом шаге по времени может «раскачаться». Инженерный компромисс: если течение быстро меняется — лучше Эйлер; если плавное — BDS2 даст выигрыш в точности.
2.7.1.4. Теорема о дивергенции — главный трюк МКО (к формуле 3.13)#
Вместо того чтобы считать, как меняется величина внутри всего объёма ячейки, мы считаем потоки через её грани. Это даёт формула Остроградского–Гаусса: интеграл от дивергенции по объёму равен сумме потоков через замкнутую поверхность. Инженерная аналогия: уровень воды в баке меняется не потому, что мы знаем каждую каплю внутри, а потому что знаем, сколько втекло и вытекло через трубы в стенках. Эта формула автоматически гарантирует консервативность: что втекло в одну ячейку, то вытекло из соседней.
2.7.1.5. Линеаризация кривых граней (к Рисунок 3.1)#
Генераторы сеток иногда создают ячейки с неплоскими гранями. Интеграл по кривой поверхности брать сложно. В OpenFOAM каждую такую грань режут на плоские треугольники (от центроида грани к её вершинам) и суммируют потоки через них. Это вносит ошибку ~ h² в площадь грани — она не ухудшает общий второй порядок метода, но её величина (константа при h²) зависит от «кривизны» грани. На практике: избегайте сильно искажённых ячеек в важных областях потока.
2.7.1.6. Интерполяция на грань: CDS и Upwind (к 3.19–3.21)#
Чтобы посчитать поток через грань, нужно знать значение φ на грани. Хранится оно только в центрах ячеек. CDS (центральные разности, 3.19): проводим прямую через центры двух соседних ячеек и берём значение на грани — это линейная интерполяция, второй порядок точности. Проблема: на сильных градиентах может дать отрицательные значения там, где их быть не должно (осцилляции). Upwind (3.21): берём значение из той ячейки, откуда дует поток. Первый порядок, сильно «мажет» резкие фронты, но зато устойчиво и без осцилляций. В OpenFOAM есть и компромиссные схемы (TVD, NVD), которые переключаются между CDS и Upwind, смотря по локальной гладкости поля.
2.7.1.7. Владелец-сосед (к формулам 3.24–3.26)#
Поток через внутреннюю грань один и тот же для обеих соседних ячеек — только знак разный. Вместо того чтобы считать его дважды (для левой ячейки и для правой), OpenFOAM считает один раз, а затем прибавляет ячейке-владельцу и вычитает у соседа. Правило простое: владелец — та ячейка, у которой индекс меньше; вектор нормали всегда направлен от владельца к соседу. Это жёстко зашито в коде и даёт двойную выгоду: (а) экономия вычислений, (б) автоматическое соблюдение консервативности — сумма всех потоков по всем внутренним граням равна нулю (сколько ушло из одной, столько пришло в другую).
2.7.1.8. Почему неравномерная сетка портит точность градиента (к 3.31)#
Представьте уклон дороги между двумя столбами. Если вы стоите ровно посередине, уклон = (высота_правого − высота_левого) / расстояние. Всё точно. Если вы смещены к левому столбу, та же формула даст ошибку: вы «не видите» изгиб дороги у правого столба. Величина ошибки зависит от второй производной («кривизны») поля \( \phi \) и от величины смещения от середины. Поэтому правило хорошей сетки: в зонах больших градиентов держите грань примерно посередине между центрами ячеек (соотношение ≈ 0.5). Если градиент мал (поле гладкое), можно отходить от этого правила без потери точности.
2.7.1.9. Шахматный эффект (к примеру 50-100-50)#
Шахматный эффект — это когда численная схема «не видит» пилообразных колебаний. Пример: поле (50, 100, 50, 100, 50) в пяти соседних ячейках. Если посчитать градиент в ячейке 1 по формуле, использующей только непосредственных соседей, получится: (100 − 50)/2 + (50 − 100)/2 = 0. Хотя поле колеблется, градиент — ноль! Такой градиент не создаст диффузионного потока, чтобы сгладить пики. Решение в OpenFOAM: градиент на грани для диффузионного члена считают напрямую по разности значений в двух ячейках (3.33), минуя стадию вычисления градиентов в центрах ячеек. Это разрушает шахматный паттерн.
2.7.1.10. Неортогональность: что это и как чинить (к 3.38–3.41)#
Идеальная (ортогональная) сетка: линия, соединяющая центры соседних ячеек, перпендикулярна грани между ними. В реальности почти всегда есть угол \( \alpha_{f} \). Тогда поток через грань раскладывают на две части: (а) «полезную» — вдоль линии центров, считается по значениям в двух ячейках и учитывается неявно (даёт вклад в матрицу); (б) «паразитную» — поперёк, считается по градиенту с предыдущей итерации и учитывается явно (добавляется в правую часть). Чтобы явная и неявная части не разъезжались, внутри одного шага по времени делают несколько под-итераций (M). M=1 обычно достаточно для углов до 50°, M=2–3 для углов до 70°. Сильно неортогональные сетки (> 70°) — источник проблем со сходимостью. Утилита checkMesh покажет распределение углов.
2.7.1.11. Скошенность - ещё один геометрический глюк (к концу раздела)#
Осреднение величины по грани (3.16) привязывает результат к её геометрическому центру \( x_{f} \). Но интерполяция (3.19) фактически даёт значение в точке \( x_{f}' \) — пересечении отрезка между центрами ячеек с плоскостью грани. Если \( x_{f} \) и \( x_{f}' \) не совпадают, мы приписываем значение «не тому месту». Ошибка ~ расстояние_между_\( x_{f} \)_и_\( x_{f}' \) × градиент_вдоль_грани. В стандартном OpenFOAM это не исправляется. [Инженерный совет:]{.underline} смотрите скошенность в checkMesh, при значениях > 4 (по внутренней шкале) в критических зонах лучше перестроить сетку.
2.8. Временнáя дискретизация#
Временная дискретизация объединяет описанные к этому моменту дискретизации временного, конвективного (дивергентного) и диффузионного (лапласовского) членов. Перегруппировав продискретизированное уравнение переноса скаляра (2.1) с использованием уже описанных дискретных операторов, можно записать:
\( \left( \frac{\partial\phi}{\partial t} \right)_{c} = \frac{1}{\left| \Omega_{c} \right|}\left\lbrack \sum_{}^{}D_{f}(\nabla\phi)_{f} \cdot S_{f} - \sum_{}^{}U_{f}\phi_{f} \cdot S_{f} \right\rbrack + S\left( \phi_{c} \right) \) (2.42)
Разложим \( \phi_{c} \) во времени в ряд Тейлора с \( \delta t = t^{(n + 1)} - t^{n} \) в качестве временного шага. Это даёт:
\( \phi_{c}^{n + 1} = \phi_{c}^{n} + \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n}\delta t + O\left( \delta t^{2} \right) \) (2.43)
\( \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n} = \frac{\phi_{c}^{n + 1} - \phi_{c}^{n}}{\delta t} - O(\delta t) \) (2.44) и
\( \phi_{c}^{n} = \phi_{c}^{n + 1} - \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n + 1}\delta t + O\left( \delta t^{2} \right) \) (2.45)
\( \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n + 1} = \frac{\phi_{c}^{n + 1} - \phi_{c}^{n}}{\delta t} + O(\delta t) \) (2.46)
Дискретизации, заданные уравнениями (2.44) и (2.46), эквивалентны и обе имеют первый порядок точности. Однако OpenFOAM использует неявную схему Эйлера, заданную уравнением (2.46), потому что она безусловно устойчива для линейных уравнений с гладкими начальными условиями.
Подстановка уравнения (2.46) в уравнение (2.42) даёт дискретизацию уравнения переноса скаляра (2.1) по часто используемой неявной схеме Эйлера, которая имеет первый порядок точности по времени и второй — по пространству:
\( \begin{array}{r} \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n + 1} = \frac{1}{\left| \Omega_{c} \right|}\left\lbrack \sum_{}^{}D_{f}(\nabla\phi)_{f}^{n + 1} \cdot S_{f} - \sum_{}^{}U_{f}\phi_{f}^{n + 1} \cdot S_{f} \right\rbrack \\ + S\left( \phi_{c}^{n + 1} \right) + O(\delta t) + O\left( h^{2} \right) \end{array} \) (2.47)
где источниковый член \( S\left( \phi_{c} \right)^{(n + 1)} \) либо вычисляется на старом временном шаге \( t^{n} \), либо экстраполируется по \( \phi \) и по времени с помощью линеаризации.
В качестве альтернативы, подстановка уравнения (2.44) в (2.42) и суммирование полученного уравнения с (2.47) даёт схему Кранка–Николсон:
\( \left( \frac{\partial\phi}{\partial t} \right)_{c}^{n + 1} = \frac{0.5}{\left| \Omega_{c} \right|}\begin{bmatrix} \sum_{}^{}D_{f}(\nabla\phi)_{f}^{n + 1} \cdot S_{f} + \sum_{}^{}D_{f}(\nabla\phi)_{f}^{n} \cdot S_{f} \\ - \sum_{}^{}U_{f}\phi_{f}^{n + 1} \cdot S_{f} - \sum_{}^{}U_{f}\phi_{f}^{n} \cdot S_{f} \\ + S\left( \phi_{c}^{n} \right) + S\left( \phi_{c}^{n + 1} \right) \end{bmatrix} + O(\delta t) + O\left( h^{2} \right) \)(2.48)
которая имеет второй порядок точности также и по времени, поскольку члены \( - O(\delta t) \) и \( + O(\delta t) \) при суммировании уравнений (2.44) и (2.46) соответственно сокращаются, оставляя \( O\left( {\delta t}^{2} \right) \) в качестве старшего члена погрешности. Проверка этого утверждения оставляется читателю в качестве короткого упражнения.
В OpenFOAM коэффициент 0.5 в схеме Кранка–Николсон сделан переменным путём группировки неявных и явных членов, а именно:
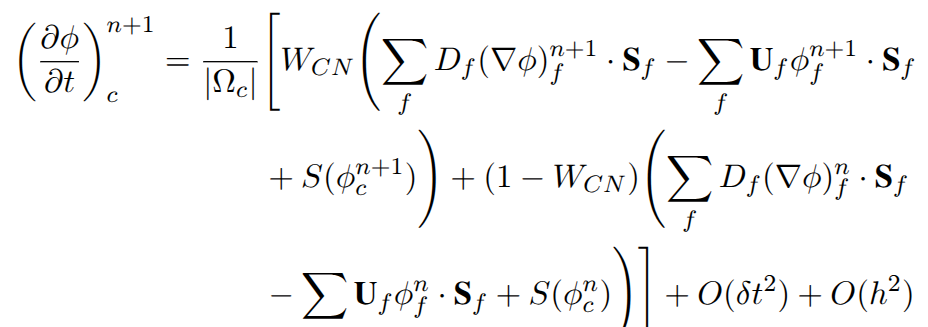
(2.49)
WCN=0.5 уравнение (2.48) сводится к (2.49). 2.48сли в качестве \( \left( \frac{\partial\phi}{\partial t} \right)_{c}^{(n + 1)} \) используется уравнение (2.46), то WCN=1 даёт неявный метод Эйлера первого порядка, заданный уравнением (2.47).
Схемы интегрирования по времени выбираются в расчётном кейсе внутри словаря system/fvSchemes, как показано, например, в листинге 1, где используется WCN=0.5.
Листинг 1: Пример записи временной дискретизации в конфигурационном файле (словаре) system/fvSchemes.
ddtSchemes
{default CrankNicolson 0.5;}
Разумеется, источниковые члены в уравнении (2.49) являются линеаризованными функциями от \( \phi \), что обеспечивает получение в результате дискретизации уравнений линейной алгебраической системы, которую можно решить с помощью линейного решателя.
2.8.1. Комментарий инженера: к разделу 2.8#
2.8.1.1. Собираем всё вместе (к формуле 2.42)#
Формула (2.42) — это полудискретная форма: все пространственные операторы уже заменены на суммы по граням, а производная по времени ∂φ/∂t пока осталась как есть, не discretised. В правой части: первый член — диффузия (сколько «расползлось» по градиенту), второй — конвекция (сколько «сдуло» потоком), третий — источник (сколько «родилось» или «умерло» внутри ячейки). Всё это поделено на объём ячейки |\( \Omega_{c} \)|, чтобы получить скорость изменения величины в центре. Теперь осталось разобраться с этой скоростью изменения по времени — и уравнение станет полностью алгебраическим.
2.8.1.2. Два взгляда на производную: явный и неявный (формулы 2.43–2.46)#
Ряд Тейлора даёт два равноценных способа записать производную:
(2.44): выражаем производную на старом шаге (n) через значения
\( \phi \) на шагах n и n+1.
(2.46): выражаем производную на новом шаге (n+1) через те же
\( \phi^{n + 1} \) и \( \phi^{n}. \)
Обе формулы дают первый порядок точности по времени (ошибка ~ δt). Разница — в том, где «живёт» производная. Если она «живёт» на старом шаге (2.44), то \( \phi^{n + 1} \) входит в неё линейно и его можно явно вытащить — это явный метод. Если она «живёт» на новом шаге (2.44), то \( \phi^{n + 1} \) зашито и в производную, и в потоки — это неявный метод, требующий решения системы уравнений. OpenFOAM выбирает неявный путь: устойчивость важнее простоты.
2.8.1.3. Почему неявный Эйлер? Безусловная устойчивость (к формуле 2.47)#
Неявный Эйлер (2.47) может работать с шагами по времени, которые в десятки раз больше, чем позволил бы явный метод. Это особенно важно для диффузионных задач, где явный метод требует δt ~ h² (измельчили сетку вдвое — шаг по времени упал вчетверо). Неявный Эйлер «съедает» такие ограничения, позволяя разумно сочетать мелкую сетку и приемлемый шаг по времени. Недостаток один: на каждом шаге приходится собирать и решать систему линейных уравнений. Но это всё равно быстрее, чем делать в 100 раз больше шагов явным методом.
2.8.1.4. Кранк–Николсон: полусумма ради точности (к 2.47)#
Схема Кранка–Николсон — это неявный метод, но с «оглядкой» на старый шаг. Берём половину потоков с нового шага и половину со старого, складываем. Математически это убивает ошибку первого порядка: -O(δt) от одного уравнения и +O(δt) от другого гасят друг друга, остаётся O(δt²). Второй порядок точности по времени означает: уменьшили шаг в 2 раза — ошибка упала в 4 раза.
Плата: CN склонен к осцилляциям на резких перепадах. Представьте себе фронт температуры: на новом шаге фронт продвинулся, но в схеме сидит «воспоминание» о старом положении фронта. Это может вызвать нефизичные всплески («звон»). Поэтому чистый CN (W=0.5) хорош для гладких течений и может подвести на ударных волнах или двухфазных интерфейсах.
2.8.1.5. Весовой коэффициент \( W_{CN} \) — главная ручка настройки (к формуле 2.49)#
OpenFOAM даёт инженеру возможность смешивать неявную (новый шаг) и явную (старый шаг) части с произвольным весом \( W_{CN} \):
| WCN | Название схемы | Порядок точности по времени | Устойчивость | Характер поведения | Когда применять |
|---|---|---|---|---|---|
| 1.0 | Неявный Эйлер (Euler implicit) | Первый (O(δt)) | Безусловно устойчива | Очень устойчива, «размазывает» резкие фронты, вносит численную диффузию | Стационарные задачи; переходные процессы, где важна устойчивость, не точность; первый расчёт новой задачи |
| 0.5 | Кранк–Николсон (Crank–Nicolson) | Второй (O(δt2)) | Условно устойчива (может осциллировать на больших шагах) | Точна, но склонна к нефизичным осцилляциям («звон») на резких перепадах и при больших числах Куранта | Плавные ламинарные течения; задачи, где важна точность по времени (вихревые структуры, акустика) |
| 0.6–0.9 | «Инженерный» Кранк–Николсон | Между первым и вторым | Компромиссная | Часть точности принесена в жертву устойчивости; осцилляции сильно подавлены | Большинство реальных промышленных задач; умеренные вихревые течения, задачи с межфазными границами, кавитация |
| 0.0 | Явный Эйлер (Euler explicit) | Первый (O(δt)) | Жёстко ограничена числом Куранта (Co<1) | Быстрый расчёт одного шага, но шаг должен быть очень маленьким | В OpenFOAM используется редко; только в специальных случаях, где важна простота |
2.8.1.6. Пример из листинга 1: как это прописать в кейсе#
Запись в system/fvSchemes:
ddtSchemes
{default CrankNicolson 0.5;}
Если нужно чисто неявный Эйлер — пишем:
ddtSchemes
{default Euler;}
Это эквивалентно CrankNicolson 1.0. В отличие от многих коммерческих CFD-пакетов, OpenFOAM позволяет задать этот параметр явно и плавно, не переключаясь между «чёрным ящиком» схем.
2.8.1.7. Линеаризация источника#
Источниковый член \( S(\varphi) \) часто зависит от самой переменной. Например, теплообмен излучением: \( S = \sigma\left( T⁴_{окр} - T⁴ \right) \). Если \( Т \) — искомая температура, это нелинейность. Чтобы сохранить линейность СЛАУ, S раскладывают: \( S \approx S_{0} + S_{1} \cdot T^{n + 1} \). Константа \( S_{0} \) уходит в правую часть, \( S_{1} \) садится на диагональ матрицы (как дополнительный «сток» или «источник»). Это стандартный трюк, ускоряющий сходимость и предотвращающий расходимость. В OpenFOAM многие физические модели (горение, радиация, кавитация) внутри себя уже линеаризованы.
2.8.1.8. Резюме: как выбирать схему по времени?#
| Тип задачи | Рекомендуемая схема | Обоснование |
| Стационарное решение (интересует только конечное установившееся состояние, переходный процесс не важен) | Euler (W=1.0) | Можно брать большой шаг δt, чтобы быстрее «выбраться» на steady-state. Точность по времени не имеет значения |
| Ламинарное нестационарное течение с плавными пульсациями | Crank-Nicolson 0.5 | Второй порядок точности, осцилляций не будет при умеренных числах Куранта (Co < 1) |
| Вихревые течения (LES, DNS), где важна точность переноса вихрей | Crank-Nicolson 0.5 или BDS2 (backward differencing) | BDS2 даёт второй порядок и более устойчив к осцилляциям на пределе разрешения сетки, чем Crank-Nicolson 0.5 |
| Ударные волны, двухфазные интерфейсы, кавитация | Euler (W=1.0) или Crank-Nicolson 0.7–0.9 | Формальная потеря точности по времени менее критична, чем появление нефизичных осцилляций («звонка») на резких фронтах |
| Первое знакомство с новой задачей | Euler (W=1.0) | Безопасный выбор: убедитесь, что решатель сходится и даёт |
2.9. Система линейных алгебраических уравнений (СЛАУ)#
В результате дискретизации уравнения строится система линейных алгебраических уравнений, которая решается относительно \( \phi_{c}^{n + 1} \) в каждой ячейке \( \Omega_{c} \) сетки \( \Omega_{D} \). Рассмотрим, например, дискретизацию, заданную уравнением (2.48), на ортогональной сетке. Члены \( (\nabla\phi)_{f}^{n + 1} \) и \( \phi_{f}^{n + 1} \), согласно уравнению (2.35) и уравнению (2.23) соответственно, введут в уравнение (2.48) значения из соседних по грани ячеек для ячейки c, взятые с временных шагов n и n+1. Другие члены, такие как \( \left( \frac{\partial\varphi}{\partial t} \right)_{c}^{n + 1} \), содержат только значения \( \phi_{c} \) с текущего (n) и нового (n+1) временных шагов. Отделяя вклад от самой ячейки c и множества её соседей по граням \( N_{c} \), получаем линейное алгебраическое уравнение, которое в общем виде записывается как:
\( a_{c}\phi_{c}^{n + 1} + \sum_{}^{}a_{N}\phi_{N}^{n + 1} = S_{c} \)(2.50)
Неявная дискретизация, такая как в уравнении (2.48), порождает линейное алгебраическое уравнение (2.50) для каждой ячейки \( \Omega_{c} \) в сетке. Уравнения (2.50) связаны друг с другом, поскольку в уравнении для каждой ячейки \( \Omega_{c} \) присутствуют вклады от соседних ячеек. Однако, так как вклады поступают только от соседей, имеющих общую грань с ячейкой \( \Omega_{c} \), система уравнений будет содержать лишь небольшое число ненулевых коэффициентов, и результирующая линейная система будет разреженной. Решение этой разреженной линейной алгебраической системы даёт значения \( \phi_{c} \) в каждой ячейке сетки для нового временного шага
2.9.1. Комментарий инженера: к разделу 2.9#
2.9.1.1. Что такое уравнение (2.50)#
Это одна строка в огромной таблице (матрице) уравнений. Для каждой ячейки:
\( a_{c} \) — диагональный коэффициент
(влияние ячейки на саму себя),
\( a_{N} \) — коэффициенты при соседях (по
одному на каждую грань),
\( S_{c} \) — правая часть (всё, что явно
известно: потоки со старого шага, источники).
2.9.1.2. Почему система разреженная#
У каждой ячейки 5–15 соседей. Значит, в строке матрицы всего 6–16 ненулевых чисел, а ячеек — тысячи или миллионы. Хранить полную матрицу (миллиарды чисел) нет смысла — OpenFOAM хранит только ненулевые элементы, экономя память.
2.9.1.3. Почему уравнения связаны#
Неявный метод: \( \phi^{n + 1} \) в ячейке 5 зависит от \( \phi^{n + 1} \) в соседях 3, 7, 8. А \( \phi^{n + 1} \) в ячейке 7 зависит от \( \phi^{n + 1} \) в ячейке 5. Получается замкнутый круг — все уравнения надо решать одновременно, одной системой.
2.9.1.4. Как это решается на практике#
OpenFOAM использует итерационные решатели (PCG, GAMG, PBiCGStab), которые «угадывают» решение и уточняют его за десятки итераций. Настройка — в файле system/fvSolution:
solvers
{
{
solver PCG; // тип решателя
preconditioner DIC; // ускоритель сходимости
tolerance 1e-08; // требуемая точность
relTol 0.01; // относительная точность
}
}
Это и есть «подкапотная» работа OpenFOAM на каждом временном шаге: собрать матрицу → решить СЛАУ → получить новые φ во всех ячейках.
2.10. Граничные условия#
Граничные условия необходимы при дискретизации всякий раз, когда значение в центре грани относится к грани ячейки, которая является частью границы расчётной сетки. Так называемые граничные грани не имеют ячеек-соседей, чьи значения участвовали бы в дискретизации. Вместо этого обычно задаётся одно из трёх:
значение — предписывается граничным условием Дирихле, или
условием фиксированного значения (fixed value);
градиент — предписывается граничным условием Неймана
(Neumann);
линейная комбинация значения и градиента — предписывается
смешанным граничным условием, или условием Робина (Robin).
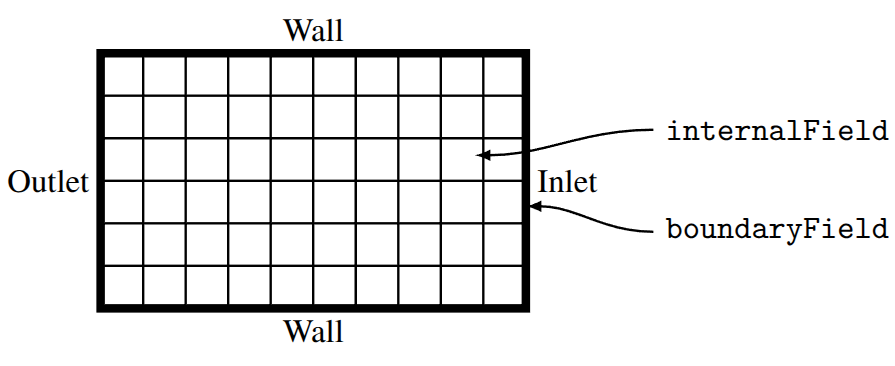 Рисунок 2.12: Пример простого двумерного течения
в канале: вход — справа, выход — слева. Оставшиеся две границы —
стенки.
Граничные условия необходимы на граничных гранях независимо от того, является ли дискретизация явной или неявной, от схемы интерполяции для \( \phi_{f} \) и от схемы дискретизации градиента для \( (\nabla\varphi)_{f} \). Граничные грани выделены жирной линией на 2.12.
Например, при сборке линейного алгебраического уравнения (2.50) с помощью (2.48) суммирование в дискретных операторах столкнётся с граничными гранями в некоторых ячейках. Рассмотрим адвективный оператор \( \nabla \cdot (U\phi) \) и предположим, что граничная грань помечена буквой b: тогда становится ясно, что слагаемое \( \phi^{n + 1}U_{b}S_{b} \)· должно быть добавлено к сумме в дискретизированном адвективном члене. Для внутренних граней это значение интерполировалось бы между значениями в центрах ячеек, соседних с гранью b. Однако рядом с граничной гранью находится только одна ячейка, и эта ячейка — по определению — является владельцем этой грани.
Для граничного условия fixedValue (фиксированное значение) процедура проста: граничное условие предписывает значение \( \phi_{b} \) для свойства \( \phi \), а также \( U_{b} \) для скорости U. Этого достаточно для условия фиксированного значения, однако это существенно усложняет реализацию граничных условий. Подавляющее большинство граней в сетке — внутренние, а не граничные. Поэтому не имело бы смысла держать внутренние и граничные грани как-то перемешанными и классифицированными, чтобы дискретизация могла «спрашивать каждую грань», принадлежит ли она границе и, если да, какое граничное условие на ней задано. Чтобы избежать этого усложнения, грани сетки \( \Omega_{D} \) разделены на внутренние и граничные. Граничные грани в OpenFOAM дополнительно сгруппированы в граничные патчи — подмножества граничной сетки, на которых применяются одинаковые граничные условия. Это осмысленно, поскольку моделируемые процессы обычно имеют поверхности, подверженные разным условиям. Например, в задачах теплопереноса: одни поверхности могут быть теплоизолированы, другие охлаждаются обдувом воздуха или распылением жидкости, третьи граничат с телами из другого материала. Соответственно, как показано на 2.12, поля в OpenFOAM разделены на внутренние (заданные в центрах ячеек) и граничные поля (заданные в центрах граней), которые, в свою очередь, разделены на поля патчей, соответствующие конкретным граничным патчам (граничным условиям). Дискретизация в OpenFOAM существенно упрощается за счёт разделения граней и полей соответственно на внутренние и граничные патчи и поля, поскольку вычисление сумм в дискретизированных операторах можно применять по отдельности к внутренней части области и к её границе.
Другое граничное условие — условие Неймана, или «естественное» граничное условие, которое предписывает нулевой градиент величины на границе области:
\( \nabla\phi_{b}^{n + 1} = 0 \) (2.51)
и это условие используется для вычисления значения величины на граничной грани b с помощью аппроксимации рядом Тейлора:
\( \phi_{c}^{n + 1} \approx \phi_{b}^{n + 1} + \nabla\phi(x)^{n + 1} \cdot b \) (2.52)
так что для граничного условия нулевого градиента значение на граничной грани принимает значение из центра ячейки, а именно:
\( \phi_{b}^{(n + 1)} \approx \phi_{c}^{(n + 1)} \) (2.53)
Вклад границы в алгебраическое уравнение (2.50) для условия нулевого градиента на граничной грани b в конечном счёте войдёт в коэффициент при значении в ячейке на новом временном шаге — в коэффициент \( a_{c} \)в уравнении (2.50). Иными словами, условие нулевого градиента будет влиять на диагональные коэффициенты системы линейных алгебраических уравнений для всех ячеек, соседних с граничным патчем, на котором задано это условие.
В OpenFOAM реализованы различные граничные условия, и все они задают либо значение на границе, либо градиент, либо комбинацию того и другого.
2.10.1. Комментарий инженера: к разделу 2.10#
2.10.1.1. Зачем нужны граничные условия?#
У граничной грани нет соседа снаружи — не от чего интерполировать значение на грань. А уравнение для приграничной ячейки требует поток через эту грань. Значит, его надо задать руками. Без граничных условий система уравнений не замкнута — неизвестных больше, чем уравнений. OpenFOAM в этом случае просто не запустится, выдав ошибку.
2.10.1.2. Три типа граничных условий — три инженерные ситуации#
| Тип | Что задаём | Когда применять | Пример |
| fixedValue (Дирихле) | Само значение на грани | Знаем величину из физики | Температура стенки нагревателя 500 K; скорость на входе 10 м/с |
| zeroGradient (Нейман) | Градиент = 0 | На границе «ничего не происходит» | Адиабатическая стенка; выход потока; плоскость симметрии |
| mixed (Робин) | Комбинация значения и градиента | Поток зависит от значения на грани | Теплоотдача: q = h·(T_стенки – T_воздуха) |
2.10.1.3. Патчи — почему это удобно#
Все граничные грани сгруппированы в патчи (inlet, outlet, walls и т.д.). Это сделано для скорости и удобства:
Программа не проверяет тип каждой грани по отдельности — проходит
циклом по патчу и применяет одно условие ко всем граням сразу.
Пользователь задаёт условия в файлах один раз на патч, а не на
каждую грань.
При построении сетки давайте патчам осмысленные имена — потом в
OpenFOAM просто пишете для каждого патча его тип.
2.10.1.4. Как это прописывается в кейсе#
Файл 0/U (скорость) или 0/T (температура):
boundaryField{
inlet
{
type fixedValue;
value uniform (10 0 0); // 10 м/с вдоль X
}
outlet
{ type zeroGradient; } // свободный выход
walls
{ type noSlip; } // прилипание для U
}
uniform означает «одно значение на весь патч». Можно задать и неоднородное поле, но для начала достаточно uniform.
2.10.1.5. zeroGradient и устойчивость решателя#
Когда ставите zeroGradient, OpenFOAM просто копирует значение из центра приграничной ячейки на грань. Этот вклад садится в диагональ матрицы (\( a_{c} \)), делая её «диагонально доминантнее». Для итерационных решателей это подарок: чем сильнее диагональ, тем быстрее и надёжнее сходимость. Поэтому на выходе, где физика позволяет, всегда ставьте zeroGradient — счёт пойдёт быстрее.
2.10.1.6. Полезные типы граничных условий в OpenFOAM#
| Тип условия | Что делает | Где применять |
| fixedValue | Жёстко задаёт значение | Вход, нагреватель, изотермическая стенка |
| zeroGradient | Градиент = 0 | Выход, адиабатическая стенка, симметрия |
| inLetOutlet | zeroGradient на выходе, fixedValue при обратном токе | Выходы, где возможен подсос |
| totalPressure | Фиксирует p₀ = p + ½ρU² | Вход в компрессорах, турбинах |
| noSlip | Скорость = 0 на стенке | Твёрдые стенки |
| slip | Нормальная скорость = 0, касательная — свободно | Стенки без трения |
| symmetry | Зеркальная симметрия | Половина симметричной области |
| cyclic | Периодика: выход = вход | Повторяющиеся решётки, сектора |
| wedge | Осевая симметрия | 2D-осесимметричные задачи |
| wallHeatTransfer | Теплоотдача через коэффициент | Охлаждаемые/нагреваемые стенки |
2.10.1.7. Типовые настройки для стандартных задач#
| Поверхность | U (скорость) | p (давление) | T (температура) |
| Вход | fixedValue | zeroGradient | fixedValue |
| Выход | zeroGradient / inletOutlet | fixedValue (обычно 0) | zeroGradient / inletOutlet |
| Стенки | noSlip (0 0 0) | zeroGradient | fixedValue или zeroGradient |
| Симметрия | symmetry | symmetry | symmetry |
fixedValue на выходе скорости. Если задали скорость на входе и
жёстко фиксируете её на выходе, а они не совпадают по расходу — давление мгновенно уходит в бесконечность. Для скорости на выходе всегда zeroGradient или inletOutlet.
Путаница между zeroGradient и fixedValue 0. zeroGradient —
градиент ноль (значение «плывёт» свободно), fixedValue 0 — прибили к нулю жёстко. Для температуры это разница между адиабатической стенкой и стенкой при 0 K.
Забытый defaultFaces. Если в сетке есть патч defaultFaces, а в
файле 0 вы про него не написали — OpenFOAM упадёт при запуске. Всегда проверяйте список патчей через checkMesh или boundary файл и прописывайте условие для каждого.
Несогласованные единицы. Задали скорость в см/с, а геометрия в
метрах — получите число Рейнольдса в 100 раз меньше реального. Всегда держите одну систему единиц (СИ — безопасный выбор).
Стенки без прилипания для вязкого течения. Если забыли noSlip, а
поставили slip — трение о стенку исчезнет, профиль скорости будет нефизичным.
2.10.1.9. Алгоритм проверки при расходимости#
Открыть файлы 0/U, 0/p, 0/T.
Убедиться, что для каждого патча прописан type.
Проверить: на входе скорость fixedValue, на выходе — zeroGradient.
Проверить: давление на входе zeroGradient, на выходе fixedValue.
Убедиться, что нет fixedValue на выходе скорости.
Проверить размерность значений (СИ: м/с, Па, К).
Если есть подозрительный патч (defaultFaces), дописать для него условие.
2.10.1.10. Практический минимум для старта#
Для простого течения в трубе хватит трёх патчей:
inlet: fixedValue для U и T, zeroGradient для p.
outlet: zeroGradient для U и T, fixedValue 0 для p.
walls: noSlip для U, zeroGradient для p и T.
Это базовая конфигурация, которая физически непротиворечива и почти гарантированно запустится. Дальше усложняйте под свою физику.
2.11. Решение системы линейных алгебраических уравнений#
Решение системы линейных алгебраических уравнений (линейной системы), порождаемой неструктурированным МКО, часто требует значительных вычислительных затрат, поскольку её размер составляет \( \left| \Omega_{D} \right|^{d} \),где \( \left| \Omega_{D} \right| \) — количество ячеек в сетке \( \Omega_{D} \), а \( d \) — размерность пространства. Коэффициенты при \( \phi_{c}^{n + 1} \)и \( \phi_{N}^{n + 1} \) в уравнении (2.50) являются, таким образом, коэффициентами в разреженной матрице размером \( \left| \Omega_{D} \right|^{d} \)
OpenFOAM использует специфический формат представления матрицы, а также набор линейных решателей, тесно связанных с матричным форматом OpenFOAM. Стоит отметить, что редко возникает необходимость вносить существенные изменения или доработки в конфигурацию линейных решателей в OpenFOAM сверх того, что уже настроено во многих туториалах.
2.11.1. Комментарий инженера к разделу 2.11#
2.11.1.1. О каком размере системы речь?#
В тексте сказано: размер системы \( \left| \Omega_{D} \right|^{d} \)где, \( d \) — размерность пространства. Авторы, скорее всего, имели в виду не степень, а умножение: для трёхмерной задачи каждая ячейка даёт d уравнений (по одному на каждую компоненту скорости, если это уравнение импульса). Итоговый размер матрицы: (d × \( \left| \Omega_{D} \right|^{d} \)) × (d × \( \left| \Omega_{D} \right| \)).
Для скаляра (одна переменная на ячейку):
1 миллион ячеек → 1 000 000 неизвестных → матрица 1 000 000 × 1 000
000 элементов.
Но она разреженная: в каждой строке ~7–15 ненулевых коэффициентов
(по числу соседей-граней), а не миллион.
Для векторной величины (скорость, 3 компоненты):
- 1 миллион ячеек × 3 компоненты = 3 000 000 неизвестных → матрица 3
000 000 × 3 000 000 элементов.
Ключевое: матрица квадратная, число строк = числу столбцов = числу неизвестных. Никто не хранит и не обрабатывает её как полную — работают только с ненулевыми элементами. Надо помнить, что размер матрицы — это не общее количество элементов (3·10⁶ × 3·10⁶ = 9·10¹² — это полное число ячеек в матрице, если бы она была плотной). Говоря «размер матрицы», имеют в виду порядок системы: сколько строк и сколько столбцов.
2.11.1.2. Что значит «специфический формат матрицы»?#
OpenFOAM использует формат CSR (Compressed Sparse Row) или его вариацию: три массива — значения, индексы столбцов, указатели на начало строк. Это стандартный промышленный подход. Для пользователя это скрыто: вы с матрицей напрямую не работаете.
2.11.1.3. Надо ли лезть в настройки решателей?#
В 95% случаев — нет. Стандартные настройки из туториалов (PCG/DIC для давления, PBiCGStab/DILU для скорости/температуры) работают нормально. Менять решатель или предобусловливатель стоит, только если расчёт упорно не сходится или идёт подозрительно долго.
Практический вывод: если решатель сходится и результаты физичны — не трогайте настройки fvSolution без необходимости. Это зона, где «работает — не лезь» вполне оправдано
2.12. Структура верхнего уровня OpenFOAM#
OpenFOAM состоит из множества различных библиотек, приложений-решателей и утилит. Чтобы хоть как-то сориентироваться в этой огромной и зачастую пугающей кодовой базе, взглянем на содержимое корневого каталога OpenFOAM.
Содержимое каталога OpenFOAM:
applications — Исходный код решателей, утилит и
вспомогательных тестовых функций. Код решателей организован по назначению, например: /incompressible, /lagrangian, /combustion. Утилиты организованы аналогичным образом по категориям: сеточные, препроцессинг, постпроцессинг и другие.
bin — Bash-скрипты (не скомпилированные бинарники C++) с
широким набором функций: проверка установки (foamInstallationTest), запуск параллельного расчёта в отладочном режиме (mpirunDebug), создание пустого шаблона исходного кода (foamNew) или расчётного кейса (foamNewCase) и т.д.
doc — Руководство пользователя (User's Guide), руководство
программиста (Programmer's Guide) и файлы для генерации документации Doxygen.
etc — Управляющие флаги этапа компиляции и этапа выполнения,
настраиваемые для всей библиотеки. Многочисленные установочные настройки задаются в /etc/bashrc, включая: какой компилятор использовать, под какую библиотеку MPI компилировать и где будет размещена установка (пользовательская локальная или общесистемная).
platforms — Скомпилированные бинарные файлы, хранящиеся с
учётом точности, отладочных флагов и архитектуры процессора. Большинство установок содержит лишь одну-две подпапки, названные в соответствии с типом компиляции. Например, linux64GccDPOpt можно расшифровать так:
linux — тип операционной системы,
64 — архитектура процессора,
Gcc — используемый компилятор (Gcc, Icc, CLang),
DP — точность чисел с плавающей запятой (DP — двойная
точность, SP — одинарная),
Opt — флаг оптимизации компилятора (Opt —
оптимизированная сборка, Debug — отладочная, Prof — профилировочная).
src — Основная масса исходного кода инструментария. Содержит
все исходники библиотек CFD, включая дискретизацию методом конечных объёмов, транспортные модели и самые базовые примитивные структуры, такие как скаляры, векторы, списки и т.д. Основные CFD-решатели из папки applications используют содержимое этих библиотек для своей работы.
tutorials — Заранее сконфигурированные расчётные кейсы для
различных доступных решателей. Туториалы полезны для понимания того, как настраиваются кейсы для каждого решателя. Некоторые кейсы иллюстрируют более сложные операции препроцессинга, такие как многообластная декомпозиция для сопряжённого теплообмена твёрдое тело–жидкость или настройка интерфейса произвольной сетки (Arbitrary Mesh Interface, AMI).
wmake — Утилита на основе bash-скрипта wmake, которая
настраивает и вызывает компилятор C++. При компиляции решателя или библиотеки с помощью wmake информация из файлов Make/files и Make/options используется для подключения заголовочных файлов и линковки других вспомогательных библиотек. Папка Make необходима для использования wmake и, следовательно, для компиляции большинства кода OpenFOAM.
Библиотека OpenFOAM подробно описана с точки зрения архитектуры программного обеспечения в следующих главах. Там объясняются различные парадигмы языка программирования C++ и то, как они используются для того, чтобы сделать OpenFOAM столь модульной и мощной платформой для CFD.
2.12.1. Комментарий инженера к 2.12: что изменилось к 2026 году#
Описанная структура — от версий OpenFOAM 2.x–4.x (примерно 2012–2016 гг.). С тех пор многое поменялось, особенно в организации кода и установке. Ниже — основные отличия актуальных версий (OpenFOAM 10–12 и ветки от OpenFOAM Foundation / ESI).
2.12.1.1. Установка и расположение#
Раньше ставили из исходников в /opt/openfoam... со структурой выше. Сейчас:
Стандартный путь для готовых пакетов (Foundation):
/usr/lib/openfoam/openfoam<версия>.
Можно установить через apt-get (Ubuntu) или dnf (Fedora) — тогда
папки src, applications могут лежать не в одной корневой директории, а в системных путях типа /usr/include/openfoam, /usr/lib/openfoam.
Контейнеризация (Docker/Singularity/Apptainer): многие используют
готовые образы, где всё уже собрано и структура может отличаться от классической «корневой папки».
2.12.1.2. Метки (labels): Int32 vs Int64#
Раньше все индексы ячеек/граней были 32-битными (максимум ~2 миллиарда ячеек). Сейчас можно собрать OpenFOAM с 64-битными метками (WM_LABEL_SIZE=64), что позволяет работать с сетками > 2·10⁹ ячеек. Это отражается в названии платформы (например, linux64GccDPInt64Opt).
2.12.1.3. Папка platforms, tutorials, bin и doc#
В современных версиях (OpenFOAM-v2306 и новее, сборка через CMake) скомпилированные бинарники и библиотеки часто кладутся в build/ внутри исходников или в отдельную platforms/, но структура имён стала сложнее из-за поддержки новых архитектур (ARM64, Apple Silicon M1/M2/M3). Например: linux64ClangDPInt32Opt — добавился суффикс Int32/Int64 (размер целочисленных меток, о чём ниже).
Папка tutorials существенно разрослась. Появились туториалы для новых решателей и модулей: multiphaseEulerFoam, chtMultiRegionFoam, reactingParcelFoam, sixDofRigidBodyMotion и многие другие. Добавились примеры для snappyHexMesh с усложнённой геометрией, примеры для динамических сеток (overset), электромагнетизма, акустики.
Помимо старых скриптов в папке bin появились новые утилиты: foamDictionary (редактирование словарей из командной строки), foamListTimes (просмотр списка сохранённых шагов по времени), foamSequence (просмотр последовательности кадров), foamMonitor (отслеживание сходимости по логам). Скрипты стали более активно использовать Python.
Папка doc/ с Doxygen-генерацией осталась, но качество и полнота документирования API сильно выросло. Онлайн-документация доступна на cpp.openfoam.org (Foundation) и develop.openfoam.com (ESI).
2.12.1.4. Модульная структура кода#
Ветка ESI (OpenCFD Ltd.) с версий 1706+ и далее перевела многие компоненты в подмодули (git submodules). Теперь src/ содержит не всё подряд, а группирует код по крупным модулям: src/finiteVolume/, src/thermophysicalModels/, src/turbulenceModels/ и т.д. Каждый модуль может собираться отдельно.
2.12.1.5. Сборка: от wmake к CMake (частично)#
Классический wmake всё ещё используется для пользовательских решателей и библиотек. Но сама система OpenFOAM (особенно ESI-ветка) постепенно переходит на CMake для внутренней сборки. Внешне для пользователя это почти незаметно, но структура сборочных файлов усложнилась.
2.12.1.6. Чувствительность к регистру в названиях папок#
В тексте 2012 года имена папок написаны не всегда так, как сейчас. Исторически использовался и нижний регистр (lagrangian), и смешанный (Lagrangian). В современных версиях: applications/solvers/incompressible/, src/lagrangian/ и т.п.
2.12.1.7. Что осталось неизменным#
Деление на src/, applications/, tutorials/ — концептуально то же
самое.
etc/bashrc — по-прежнему главный файл настройки окружения.
wmake — всё ещё основной инструмент сборки пользовательского кода.
Формат кейса (system/, constant/, временные папки 0/, 1/...) — не
изменился.
2.12.1.8. OpenFOAM Foundation vs ESI: ключевые различия#
| Аспект | OpenFOAM Foundation (openfoam.org) | OpenFOAM ESI (openfoam.com) |
| Кто развивает | Сообщество вокруг Генри Уэллера (Henry Weller), одного из создателей OpenFOAM | Компания ESI Group (бывшая OpenCFD Ltd.), которая также исторически владеет торговой маркой OpenFOAM |
| Нумерация версий | v1, v2, ..., v11, v12 (простая, последовательная) | v1706, v1812, v1912, ..., v2306, v2312 (год + месяц выпуска: 23.12 = декабрь 2023) |
| Периодичность релизов | 1–2 раза в год, консервативно | 2 раза в год (июнь, декабрь), регулярно, как часы |
| Философия | Стабильность, минимальные изменения ядра, проверенные методы | Инновации, быстрый выход новых функций, эксперименты |
| Структура исходного кода | Монолитная: один репозиторий, ближе к классической структуре | Модульная: git-подмодули для разных компонентов (finiteVolume, thermophysics и т.д.) |
| Сборка | Классический wmake | wmake + постепенный переход на CMake |
| Новые функции | Внедряются медленно, тщательно тестируются | Быстрее появляются, могут быть экспериментальными |
Любая. Различия на уровне решателей для стандартных задач (простая гидродинамика, теплообмен) минимальны. Берите ту, которую рекомендуют в вашем учебном курсе.
Для промышленной стабильной работы
Foundation (openfoam.org). Меньше сюрпризов при обновлении. Хорошо для долгосрочных проектов, где критична воспроизводимость результатов.
Для научных исследований, сложной физики:
ESI (openfoam.com). Новые модели турбулентности, improved multiphase, overset-сетки, сопряжённый теплообмен — многое появляется раньше. Плюс регулярные релизы позволяют планировать обновления.
Для работы с overset-сетками, движущимися телами:
Однозначно ESI. Там это развивается активнее всего.
Если не знаете, с чего начать — ставьте Foundation v11 или v12: стабильно, предсказуемо, большая база ответов на форумах. Когда упрётесь в ограничение (например, нужен overset), перейдёте на ESI — это не больно, синтаксис похож, перенос кейсов занимает час-два.
3. Определение геометрии, построение сетки и конвертация сеток#
Прежде чем углубляться в детали этой главы, необходимо прояснить несколько понятий. Геометрия в контексте CFD — это, по существу, трёхмерное представление области течения. Сетка, в свою очередь, может иметь несколько значений, но обычно здесь подразумевается трёхмерная объёмная сетка. Существуют небольшие вариации: например, поверхностная сетка — это дискретизация поверхности. Как и следует ожидать, для дискретизации поверхности используются плоские элементы, в отличие от объёмных элементов для объёмной сетки. Для сложных геометрий правильное построение поверхностной сетки может иметь решающее значение.
С точки зрения CFD интерес представляет та геометрия, которая важна для конкретной задачи обтекания. Если представить аэродинамический расчёт обтекания автомобиля, то внутренняя часть салона, как правило, не представляет интереса, поскольку она не вносит существенного вклада в общую картину течения. Следовательно, важны только детали внешней поверхности кузова, и именно их необходимо достаточно хорошо разрешить при пространственной дискретизации.
В этой главе описывается, как создать сетку с нуля, как конвертировать сетки между различными форматами, а также рассматриваются различные утилиты для обработки сетки после её создания.
3.1. Определение геометрии#
Важно различать собственно геометрию сетки и геометрию, созданную программой автоматизированного проектирования (CAD). Хотя несколько слов об общей связности сетки было сказано в предыдущей главе, здесь даётся обзор того, как сама сетка хранится в файловой системе.
В стандартном расчётном кейсе OpenFOAM есть три основных каталога: 0, constant и system. Первый (0) хранит начальные условия для полей, которые, как правило, не нужны на этапе построения сетки. Последний каталог (system) хранит настройки, связанные с численным решением и общим ходом расчёта. В этой главе рассматривается каталог constant, поскольку в нём хранится сетка со всеми данными о пространственном положении и связности.
Пока используются статические сетки, расчётная сетка всегда хранится в каталоге constant/polyMesh. Статические сетки — это сетки, которые не изменяются в ходе расчёта ни за счёт перемещения узлов, ни за счёт изменения связности. Данные сетки естественным образом находятся здесь, потому что предполагается, что они постоянны (constant). С точки зрения программирования сетка описывается как polyMesh — общее описание сетки OpenFOAM со всеми её особенностями и ограничениями. Для кейса с заданной статической сеткой данные сетки хранятся в constant/polyMesh. Типичные файлы с данными сетки, находящиеся здесь, включают: points, faces, owner, neighbour и boundary. Разумеется, содержащиеся в них данные должны быть корректными, чтобы правильно определить сетку.
Туториал pitzDaily решателя potentialFoam служит примером в последующем обсуждении. Найти его можно, выполнив следующие команды:
?> tut
?> cd ./potentialFoam/pitzDaily
Обратите внимание, что сетка больше не «постоянная» часть кейса — она продукт скрипта. Allrun/Allclean — обязательный элемент каждого туториала. Скопируйте кейс к себе в домашнюю папку, что бы не было проблем с правами и запускайте ./Allrun
cd ~
mkdir -p OpenFOAM/runs
cp -r /opt/openfoam11/tutorials/potentialFoam/pitzDaily OpenFOAM/runs/
cd OpenFOAM/runs/pitzDaily
./Allrun
Проверив содержимое каталога polyMesh, становится ясно, что он пока не содержит требуемых данных сетки. В этом туториале присутствует только файл blockMeshDict. Однако выполнение команды blockMesh в каталоге кейса генерирует сетку и связанные с ней данные о связности:
?> ls constant/polyMesh
blockMeshDict boundary
?> blockMesh
?> ls constant/polyMesh
blockMeshDict boundary faces neighbour owner points
Следующий список поясняет назначение каждого файла в constant/polyMesh:
points — определяет все точки сетки в виде vectorField, где их
положение в пространстве задано в метрах. Эти точки — не центры ячеек C, а вершины ячеек. Чтобы переместить сетку на 1 м в положительном направлении оси X, необходимо соответствующим образом изменить каждую точку. Изменения каких-либо других структур в подкаталоге polyMesh для этой цели не требуется.
Рассмотреть точки поближе можно, открыв соответствующий файл в текстовом редакторе. Чтобы вывод был ограничен, заголовок опущен и показаны лишь первые несколько строк:
?> head -25 constant/polyMesh/points | tail -10
25012 // Количество точек
(
(-0.0206 0 -0.0005) // Точка 0
(-0.01901716308 0 -0.0005) // Точка 1
(-0.01749756573 0 -0.0005)
(-0.01603868134 0 -0.0005)
(-0.01463808421 0 -0.0005)
Точки содержат не что иное, как список из 25012 точек. Этот список не обязан быть упорядоченным каким-либо образом, хотя и может быть. Кроме того, все элементы списка уникальны, то есть координаты точек не могут повторяться. Доступ и адресация к этим точкам осуществляются по позиции в vectorField (класс), начиная с 0. Позиция хранится как label.
faces — составляет грани из точек по их позиции в vectorField
точек и хранит их в labelListList. Это вложенный список, содержащий по одному элементу на каждую грань. Каждый из этих элементов, в свою очередь, является собственным labelList, хранящим метки точек, использованных для построения грани. Рисунок 2.1: Непрерывная и дискретизированная области показывает визуализацию конструкции labelListList.
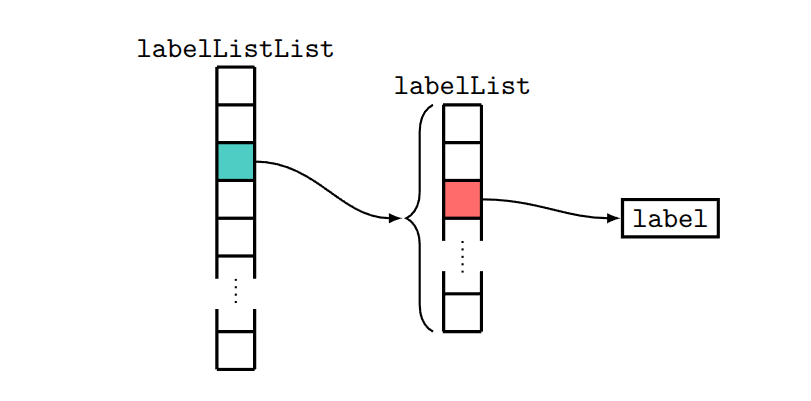 Рисунок 3.1: Графическое представление
структуры labelListList, используемой для хранения граней.
Каждая грань должна состоять как минимум из трёх точек; за её размером следует список меток точек. На грани каждая точка соединена прямым ребром со своими соседями. Используя точки, определяющие грань, можно вычислить вектор нормальной площади \( S_{f} \), причём направление определяется по правилу правой руки.
Опять же, для краткости показаны лишь первые несколько строк файла faces:
?> head -25 constant/polyMesh/faces | tail -10
49180 // Количество граней в виде labelListList
(
4(1 20 172 153) // Грань 0 с четырьмя метками точек в виде labelList
4(19 171 172 20)
4(2 21 173 154)
4(20 172 173 21)
4(3 22 174 155)
)
Как видно из первой строки вывода, сетка состоит из 49180 граней, из которых выше показана лишь часть. Аналогично длине списка граней (49180), длина каждого labelList указывается перед началом списка. Следовательно, все показанные здесь грани построены из 4 точек, адресуемых по их позиции в списке points.
owner — это снова labelList той же размерности, что и список,
хранящий грани. Поскольку грани уже построены и сохранены в списке faces, необходимо определить их принадлежность к объёмным ячейкам. По определению, грань может быть общей только для двух соседних ячеек. Список owner хранит информацию о том, какая грань какой ячейке принадлежит, что, в свою очередь, определяется на основе метки ячейки. Ячейка с меньшей меткой владеет гранью, а оставшаяся ячейка считается соседом (neighbour). Это указывает коду, что первая грань (индекс 0 в списке) принадлежит ячейке с меткой, хранящейся в этой позиции.
Более внимательный взгляд на файл owner показывает, что первые две грани принадлежат ячейке 0, а следующие две — ячейке 1:
?> head -25 constant/polyMesh/owner | tail -7
49180
(
0
0
1
1
Упорядочение этого списка — результат адресации «владелец-сосед», которая была подробно представлена в предыдущей главе.
neighbour — должен рассматриваться в связке со списком owner,
так как он выполняет противоположную функцию. Вместо того чтобы определять, какая ячейка владеет каждой конкретной гранью, он хранит её соседнюю ячейку. Сравнение файлов owner и neighbour выявляет существенное различие: список neighbour значительно короче. Это связано с тем, что граничные грани не имеют соседней ячейки:
?> head -25 constant/polyMesh/neighbour | tail -7
24170
(
1
18
2
19
Опять же, принцип работы адресации «владелец-сосед» объяснён в предыдущей главе.
boundary — содержит всю информацию о границах сетки в виде
списка вложенных подсловарей. Границы часто называют патчами или граничными патчами. Как и для предыдущих компонентов сетки, показаны лишь некоторые значимые строки:
?> head -25 constant/polyMesh/boundary | tail -9
5
(
inlet // имя патча
{
type patch;
nFaces 30;
startFace 24170;
}
Для используемого в этом разделе примера pitzDaily файл boundary содержит список из 5 патчей. Каждый патч представлен словарём, возглавляемым именем патча. Информация, содержащаяся в словаре, включает: тип патча, количество граней и начальную грань (startFace). Благодаря сортировке списка граней грани, принадлежащие определённому патчу, можно адресовать быстро и легко, используя это соглашение.
Метод адресации граничных граней проиллюстрирован на 3.2. По построению, все грани, не имеющие соседа, собираются в конце списка граней и сортируются в соответствии с патчем-владельцем. Все грани, являющиеся граничными, должны быть охвачены описанием boundary.
С точки зрения пользователя, ни points, ни faces, ни owner с neighbour не нужно трогать или редактировать вручную. Ручное изменение этих файлов почти наверняка разрушит сетку. Файл boundary, однако, возможно, потребуется изменить при определённых настройках — в зависимости от вашего рабочего процесса. Наиболее вероятная причина изменения файла boundary — смена имени или типа патча. Возможно, внести такое изменение здесь будет значительно проще, чем перезапускать соответствующий генератор сетки.
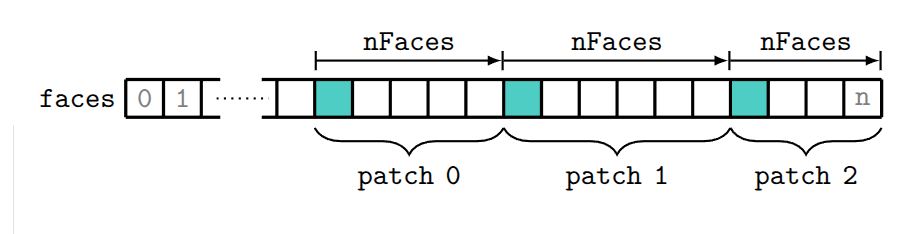
Рисунок 3.2: Принцип адресации границ в OpenFOAM для сетки с тремя патчами и n граней. Зеленым цветом выделены элементы, соответствующие startFace для каждого патча
Теперь, когда базовая структура сетки OpenFOAM объяснена, рассмотрим типы граничных патчей. Существует несколько типов патчей, которые могут быть назначены границе; одни из них встречаются чаще других. Важно различать границу (или патч) и граничные условия (см. 3.3).
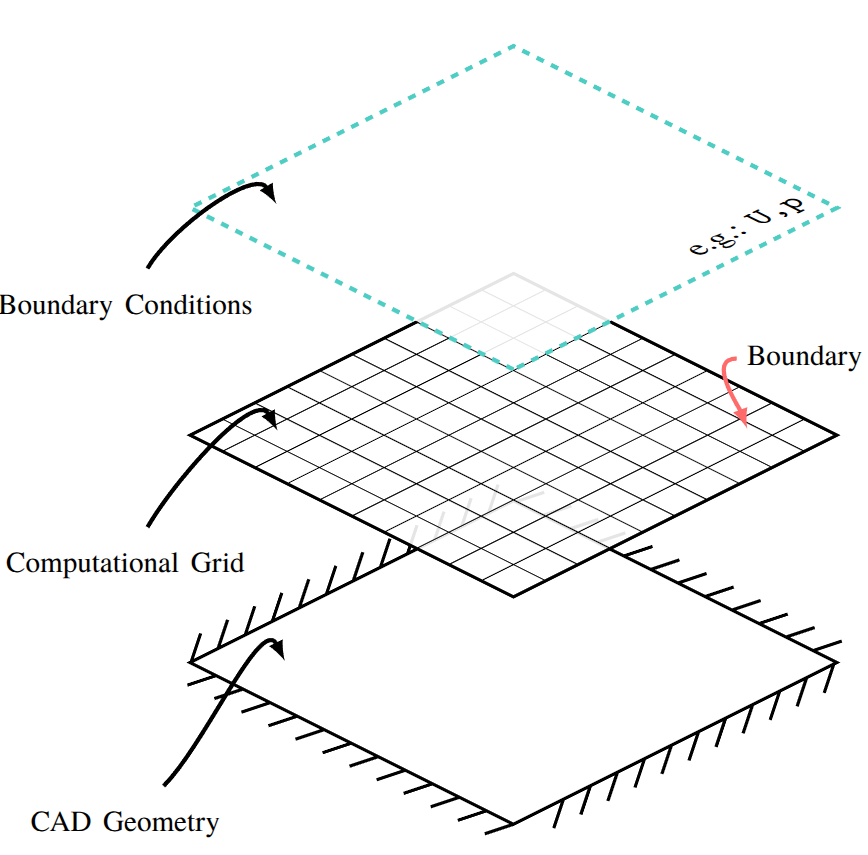 Рисунок 3.3: Иллюстрация различий и взаимосвязей
между CAD-геометрией, расчётной сеткой и её границами, а также
граничными условиями, применяемыми к этим границам.
Патч — это внешняя граница расчётной области, и он задаётся в файле boundary, являясь, следовательно, топологическим свойством. Логическая связь между границами и CAD-геометрией состоит в том, что поверхности обоих должны быть максимально идентичны. В терминах топологии сетки патч — это набор граней, имеющих только ячейку-владельца и не имеющих ячейки-соседа. В отличие от патча, граничные условия применяются к патчам для каждого из полей (\( U \),\( p \) и т.д.) по отдельности.
Типы патчей:
patch — Большинство патчей (границ) можно описать типом patch,
поскольку это наиболее общее описание. К граничным патчам этого типа можно применить любое граничное условие: Неймана, Дирихле или Коши.
wall — Если патч определён как wall, это не означает, что
поток через этот патч отсутствует. Это лишь позволяет моделям турбулентности корректно применять пристеночные функции к данному патчу. Предотвращение потока через патч типа wall всё равно должно быть явно задано через граничное условие для скорости.
symmetryPlane — Установка типа патча symmetryPlane объявляет
его действующим как плоскость симметрии. К нему не могут применяться никакие другие граничные условия, кроме symmetryPlane, и это условие должно быть применено ко всем полям.
empty — В случае двумерного расчёта этот тип следует применить
к патчам, лежащим «в плоскости». Аналогично типу symmetryPlane, граничные условия этих патчей также должны быть установлены в empty для всех полей. Никакие другие граничные условия к этим патчам применяться не будут. Крайне важно, чтобы все рёбра ячеек между обеими empty-патчами были параллельны, иначе точный двумерный расчёт невозможен.
cyclic — Если геометрия состоит из нескольких идентичных
компонентов (например, лопасть пропеллера или турбинная лопатка), достаточно продискретизировать только один компонент и рассматривать его так, как если бы он находился между идентичными компонентами. Для четырёхлопастного пропеллера это означает, что сетка строится только для одной лопасти (сетка в 90°), а патчам с нормалями в тангенциальном направлении назначается тип cyclic. Эти патчи будут вести себя как физически связанные.
wedge — Этот тип границы аналогичен циклическому патчу, но
специально предназначен для циклических патчей, образующих малый (например, ≤ 5°) клин.
С точки зрения выполнения и совместимости не имеет значения, каким образом создана структура polyMesh, — до тех пор, пока сами данные сетки корректны. Хотя в комплекте с OpenFOAM поставляются различные инструменты для построения сеток, можно использовать и внешние сторонние генераторы сеток, если они обеспечивают корректную конвертацию или вывод.
В дополнение к вышеупомянутым основным базовым компонентам сетки OpenFOAM существуют различные опциональные сеточные конструкции, которые могут использоваться только в определённых приложениях. Поскольку они опциональны, они могут присутствовать независимо от настройки кейса. Приложение OpenFOAM читает их по мере необходимости и сообщит пользователю, если они отсутствуют.
3.1.1. Наборы (Sets) и Зоны (Zones)#
Пользователю довольно легко запутаться в том, что в OpenFOAM существуют и зоны (zones), и наборы (sets), и оба выполняют довольно схожие функции с точки зрения пользователя: они выделяют подобласти сетки. Самый короткий ответ на вопрос «что использовать?» таков: используйте зоны, как кратко пояснил Хрвое Ясак в Твиттере (см. 3.4).
Однако это актуально, по существу, только для приложений-решателей. Если приложение предназначено для пре- или постпроцессинга, подходит и то, и другое.
Наборы (sets), по сути, являются labelHashSet, тогда как зоны (zones) наследуются от labelList. И те, и другие могут хранить любые элементы сетки (точки, грани или ячейки) в структуре данных, в некоторой степени похожей на список. Главное различие заключается во внутренней обработке элементов сетки, особенно в случае параллельного расчёта с топологическими изменениями сетки. В этом случае адресация в списке должна соответствующим образом обновляться, и только зона предоставляет такой метод.
Выделение подобластей обычно выполняется утилитами setSet или topoSet, каждая из которых может выбирать подмножества сетки и выполнять над ними булевы операции. Обе утилиты, вообще говоря, могут преобразовывать зоны в наборы и обратно.
Набор или зона могут быть созданы для любых элементов сетки (ячеек, точек или граней), но cellSet и cellZone используются чаще всего. Зоны хранятся как обычные словари внутри constant/polyMesh, тогда как наборы хранятся в подкаталоге sets внутри constant/polyMesh. Зоны и наборы хранятся на файловой системе одинаково: в виде длинного списка меток соответствующих элементов сетки.
3.1.2. Импорт CAD-геометрии#
Импорт геометрии, созданной во внешнем CAD-пакете, — рядовая задача для любого CFD-инженера. В OpenFOAM это обычно выполняется с помощью snappyHexMesh, однако использование этого генератора сеток будет объяснено позже. Сейчас важно понять лишь то, что этот раздел касается только импорта файлов в формате стереолитографии (STL). Поддерживаются и другие типы файлов, работа с которыми ведётся схожим образом.
STL — это формат файла, который может хранить поверхности геометрий в триангулированном виде. Возможны как бинарные, так и ASCII-кодированные файлы, но для простоты мы будем работать с ASCII-кодировкой.
В качестве примера STL-файла ниже показан фрагмент, описывающий STL-поверхность, состоящую всего из одного треугольника:
solid TRIANGLE
facet normal -8.55322e-19 -0.950743 0.30998
outer loop
vertex -0.439394 1.29391e-18 -0.0625
vertex -0.442762 0.00226415 -0.0555556
vertex -0.442762 1.29694e-18 -0.0625
endloop
endfacet
endsolid TRIANGLE
В этом примере определён только один solid с именем TRIANGLE. STL-файл может содержать несколько solid'ов, которые определяются один за другим. Каждый из треугольников, составляющих поверхность, имеет вектор нормали и три точки.
Недостатком использования ASCII STL-файлов является то, что их размер имеет тенденцию быстро расти с увеличением разрешения поверхности. Рёбра не включены явно, поскольку в файле хранятся только треугольники. Из-за этого выявление и извлечение характерных рёбер (feature edges) из STL иногда оказывается непростой задачей.
Преимуществом использования STL в качестве формата файла является то, что вы получаете триангулированную поверхностную сетку, которая по определению всегда будет иметь плоские компоненты поверхности (треугольники).
3.1.3. Комментарий инженера к 3 и 3.1#
3.1.3.1. Геометрия vs сетка — в чём разница?#
Геометрия — это «гладкая» CAD-модель области течения (например, STEP-файл из SolidWorks или CATIA). Сетка — это уже нарезанная на ячейки версия этой геометрии, с которой работает решатель. Геометрия — чертёж, сетка — то, что «видит» OpenFOAM.
3.1.3.2. Поверхностная сетка — зачем о ней говорить отдельно?#
Потому что у сложной геометрии (машина, самолёт, трубопровод с арматурой) сначала строится качественная поверхностная сетка (STL-файл), а потом уже на её основе «выращивается» объёмная. Мусор на поверхности → мусор в объёме. Это частая проблема: плохая STL-геометрия (дырки, пересечения, щели) приводит к кривой объёмной сетке или вообще к невозможности её построить.
3.1.3.3. «Нутро машины не считаем» — наш инженерный подход#
В CFD считается только то, что влияет на результат. Воздух внутри салона стоит на месте и на аэродинамику снаружи не влияет — его исключают из расчётной области. Это экономит ячейки (ресурсы) и упрощает сетку. Аналогично: при расчёте трубопровода считают внутренний объём трубы, а не толщу металла стенок (если только это не задача сопряжённого теплообмена).
3.1.3.4. Типичный workflow#
Получили CAD-геометрию (STEP/IGES).
Построили поверхностную сетку (STL) — в Salome, Gmsh, ANSA, или вытащили из CAD-пакета.
Загнали STL в OpenFOAM, построили объёмную сетку (snappyHexMesh).
Проверили качество (checkMesh), при необходимости поправили патчи.
3.1.3.5. Запустили расчёт.Типы патчей: что добавилось#
Список из текста (patch, wall, symmetryPlane, empty, cyclic, wedge) — это базовые типы, они никуда не делись. В современных версиях добавились:
symmetry — замена старому symmetryPlane. Более общий тип, работает
и для плоскостей, и для криволинейных поверхностей симметрии. symmetryPlane до сих пор поддерживается, но считается устаревшим.
mappedPatch — для неконформных интерфейсов (передача данных между
несогласованными сетками).
cyclicAMI — Arbitrary Mesh Interface, позволяет стыковать патчи с
разной сеткой, включая скользящие интерфейсы.
overset — для наложенных (химерных) сеток. Фундаментально новый
тип связности.
3.1.3.6. Файлы в polyMesh#
Базовые файлы (points, faces, owner, neighbour, boundary) — без изменений. Часто добавляется файл cellZones (и связанные с ним faceZones, pointZones) — они использовались и раньше, но в 2012 году редко упоминались в базовых руководствах. Сейчас зоны — стандартный инструмент для выделения областей (пористые вставки, вращающиеся зоны, MRF, начальные условия).
3.1.3.7. Параллельная работа#
В 2012 году при декомпозиции сетки создавались подкаталоги processor0/, processor1/ и т.д., каждый со своим polyMesh. Сейчас это тоже так, но появилась поддержка распределённой декомпозиции без записи на диск (в некоторых версиях), и формат взаимодействия с параллельной сеткой через MPI стал более оптимизированным.
3.1.3.8. Формат данных#
В старых версиях всё было в текстовом (ASCII) формате. Сейчас можно хранить сетку и поля в бинарном формате (компактнее, быстрее читается/пишется). Управляется через system/controlDict: writeFormat ascii; или writeFormat binary;.
3.1.3.9. Метки: 32 vs 64 бита#
Как упоминалось в комментарии к 1.4, сейчас можно собрать OpenFOAM с 64-битными метками (WM_LABEL_SIZE=64). Это меняет размер файлов owner, neighbour, faces (метки становятся вдвое «жирнее»), но для пользователя прозрачно. Важно знать, что сетки, созданные в 32-битной версии, не всегда читаются в 64-битной (и наоборот).
3.1.3.10. Зачем нужны sets и zones?#
Представьте, что в большой сетке нужно выделить группу ячеек: например, пористую вставку в трубе, вращающуюся область вентилятора или просто зону, где в начальный момент задана другая температура. Sets и zones — это два инструмента, которые позволяют «пометить» такие ячейки (или грани, или точки) и потом обращаться к ним по имени. Оба хранят списки меток (индексов) элементов сетки. Разница — в том, как эти списки «живут» внутри кода.
3.1.3.11. Когда что использовать? (правило Ясака)#
Хрвое Ясак (один из ключевых разработчиков) сказал просто: в решателях — zones, в утилитах — без разницы. Почему? Потому что зоны умеют автоматически обновлять свои списки при изменении топологии сетки (например, при динамической перестройке или добавлении/удалении ячеек). Наборы (sets) этого не умеют — их список «застывает» на момент создания. В пре- и постпроцессинге топология обычно не меняется, поэтому там сойдёт и то, и другое.
3.1.3.12. Техническая разница: labelHashSet vs labelList#
Set внутри — это labelHashSet (хеш-таблица). Быстрый поиск
(«принадлежит ли ячейка №12345 этому набору?»), но порядок не гарантирован.
Zone внутри — это labelList (упорядоченный список). Порядок
сохраняется, и есть механизм синхронизации при топологических изменениях.
Инженеру это знание полезно, только если вы пишете свой код. При использовании готовых утилит (topoSet, setSet) разница почти незаметна.
3.1.3.13. Чем создавать: setSet или topoSet?#
Обе утилиты умеют выделять ячейки/грани/точки по разным критериям (по координатам, по патчу, по размеру, по нормали и т.д.) и делать над ними булевы операции (объединение, вычитание, пересечение). topoSet считается более современной и гибкой. setSet — более старая, но до сих пор встречается в туториалах. Для новых задач рекомендую topoSet.
3.1.3.14. Где это лежит в кейсе?#
Зоны: constant/polyMesh/cellZones, faceZones, pointZones —
словари внутри polyMesh.
Наборы: constant/polyMesh/sets/ — отдельная папка.
На диске выглядят одинаково: длинный список целых чисел (меток). Разница — в программной «обвязке» при чтении.
3.1.3.15. Типичные применения на практике#
| Задача | Что использовать | Зачем |
| Пористая вставка | cellZone | Решатель ищет зону по имени и применяет модель пористой среды |
| Вращающаяся область (MRF) | cellZone | Зона с именем rotor — решатель добавляет центробежные/кориолисовы силы |
| Начальное условие в пятне | cellSet или cellZone | setFields задаёт начальную концентрацию/температуру в выделенной области |
| Динамическая сетка | Только cellZone или faceZone | Наборы не обновляются при движении/деформации сетки |
| Постпроцессинг (отбор проб) | cellSet | sample или probes могут работать с наборами |
| Выделение проблемных ячеек | cellSet | checkMesh может сохранить ячейки с плохим качеством в набор для визуализации |
3.1.3.16. Практический минимум#
Не хотите заморачиваться — используйте topoSet с выводом в
cellZone (или faceZone). Это работает везде: и в решателях, и в утилитах.
cellSet хорош для одноразовых операций: выделить, посмотреть в
ParaView, забыть.
Если в задаче есть динамическая сетка (движущиеся тела, скользящие
интерфейсы) — только зоны.
3.1.3.17. Что делать, если в туториале встретился setSet?#
Спокойно заменяйте на topoSet. Синтаксис чуть разный, но идея та же. В современных версиях OpenFOAM (v10+) topoSet — основной инструмент, setSet оставлен для обратной совместимости. 3.1.2
3.1.3.18. Что такое STL и почему именно он?#
STL (стереолитография) — это дедушка форматов 3D-поверхностей. Он не хранит ни кривых, ни цилиндров, ни параметрических поверхностей — только голые треугольники. Для CFD это одновременно и плюс (всегда плоские грани, легко считать пересечения), и минус (криволинейная поверхность аппроксимируется «гранёной», теряется гладкость). Но поскольку все современные CAD-пакеты умеют экспортировать в STL, а OpenFOAM умеет его «есть», этот формат стал стандартом де-факто для передачи геометрии в snappyHexMesh.
3.1.3.19. ASCII vs Binary STL#
ASCII-файл читается глазами (как в примере выше), но весит в 3–5 раз больше бинарного. Для тестового треугольника это неважно, для поверхности автомобиля с миллионом треугольников — критично. Всегда просите CAD-инженеров экспортировать в бинарный STL: файл меньше, читается быстрее. snappyHexMesh работает с обоими форматами.
3.1.3.20. Что в примере: solid, facet, vertex#
Один solid — это один «объект» (например, крыло, труба, корпус). Внутри solid'а — список треугольников (facet). Каждый треугольник: вектор нормали и три точки (vertex). Нормаль нужна, чтобы различать «внутреннюю» и «внешнюю» сторону поверхности. Если нормали в STL вывернуты наизнанку, snappyHexMesh запутается, какая сторона — расчётная область, а какая — «снаружи».
3.1.3.21. Почему feature edges — это проблема?#
Представьте острую кромку крыла. В CAD это линия пересечения двух гладких поверхностей. В STL это просто цепочка рёбер треугольников, и нигде явно не сказано: «вот здесь был острый край». snappyHexMesh пытается восстановить такие кромки сам (через параметр featureEdges в snappyHexMeshDict), но это не всегда срабатывает идеально. Если геометрия содержит острые кромки (например, входная кромка лопатки), проверяйте качество их воспроизведения после построения сетки.
3.1.3.22. Практические советы по импорту#
Попросите CAD-инженера экспортировать геометрию в STL с максимальной
точностью (мелкие треугольники). «Замыливание» геометрии крупными треугольниками — частая причина плохой сетки.
Если поверхность получилась «гранёной» — увеличьте разрешение STL
при экспорте из CAD.
Если в STL несколько solid'ов — они станут разными патчами в
snappyHexMesh, что удобно для назначения разных граничных условий (стенка, вход, выход).
Проверить STL перед построением сетки можно утилитой surfaceCheck:
она покажет количество треугольников, наличие дырок, пересечений и вывернутых нормалей.
Не редактируйте ASCII STL вручную, кроме как для отладки. Для
реальной работы используйте бинарный формат — быстрее и компактнее.
3.1.3.23. Альтернативы STL#
OpenFOAM поддерживает и другие форматы поверхностных сеток: OBJ, VTK, GTS, Nastran. Но STL — самый распространённый и наименее проблемный при обмене между разными программами. Если есть выбор — берите STL.
3.2. Генерация сетки#
Существует несколько генераторов сеток с открытым исходным кодом, разработанных специально для OpenFOAM и распределённых между двумя основными ветками разработки (vanilla OpenFOAM и foam-extend). К ним относятся blockMesh, snappyHexMesh, foamyHexMesh, foamyQuadMesh и cfMesh. Есть ещё несколько инструментов, таких как extrudeMesh и extrude2DMesh, но они не рассматриваются в этом разделе, поскольку не используются большинством пользователей OpenFOAM. Более того, они относятся скорее к утилитам для работы с сеткой, нежели к основным генераторам сеток, которые обсуждаются в этой главе.
blockMesh и snappyHexMesh будут кратко рассмотрены в этом разделе с обзором их использования и принципов работы. В общем смысле назначение генераторов сеток состоит в том, чтобы создать структуру данных polyMesh, описанную в предыдущем разделе, удобным для пользователя способом. Оба генератора сеток имеют схожие входные и выходные данные: они читают файл-словарь и записывают готовую сетку в constant/polyMesh.
3.2.1. blockMesh#
При вызове исполняемого файла blockMesh словарь blockMeshDict автоматически считывается из каталога constant/polyMesh, где он должен находиться. blockMesh генерирует блочно-структурированные гексаэдральные сетки, которые затем преобразуются в произвольный неструктурированный формат OpenFOAM. Создание сеток с помощью blockMesh для сложной геометрии — зачастую очень утомительная и трудная задача, а иногда и вовсе невозможная. Усилия, которые пользователь должен затратить на создание blockMeshDict, колоссально возрастают для сложной геометрии. Поэтому с помощью blockMesh обычно генерируют только простые сетки, а дискретизацию собственно геометрии затем перекладывают на snappyHexMesh. Это делает blockMesh отличным инструментом для создания сеток либо для достаточно простой геометрии, либо для фоновых сеток под snappyHexMesh.
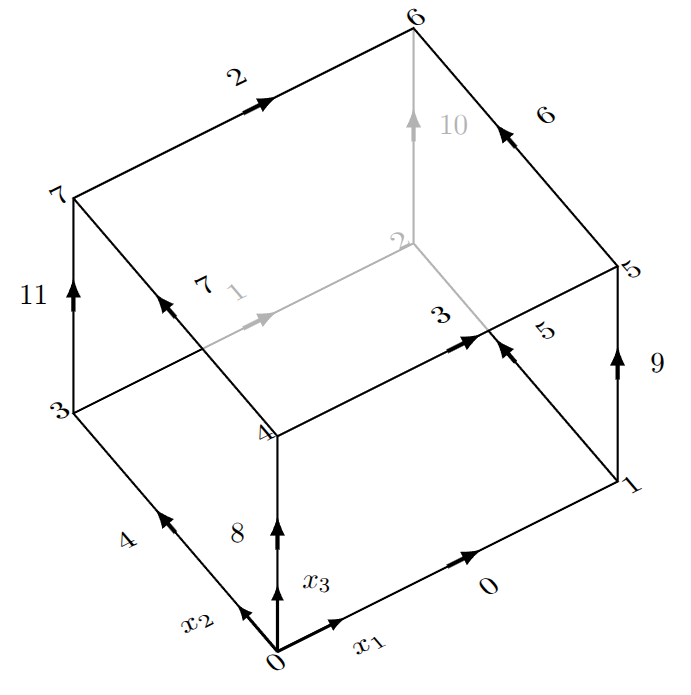
Рисунок 3.5: Базовый блок blockMesh с обозначением вершин и соглашением об именовании рёбер
Пример блока, который blockMesh использует для построения сетки, показан на 3.5. Каждый блок состоит из 8 углов, называемых вершинами (vertices). Из этих вершин строится гексаэдральный блок. Рёбра (edges), как показано на 3.5, соединяют вершины друг с другом. Наконец, поверхность блока определяется патчами, однако явно их нужно задавать только для границ блока, не имеющих соседнего блока. Границы между двумя блоками не должны перечисляться в определении патчей, поскольку они — по определению — не являются патчами.
Длина и количество узлов на соответствующих рёбрах должны совпадать для сохранения топологической согласованности. Граничные условия для самого расчёта будут позже применены к этим патчам. Следует отметить, что можно создавать блоки с количеством вершин менее 8 и иметь несогласованные узлы на патчах, однако это не рассматривается в данном руководстве.
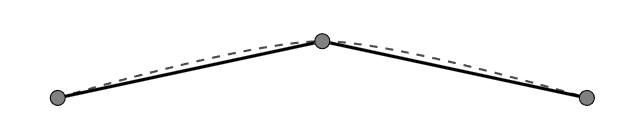
Рисунок 3.6: Серая пунктирная дуга представляет ребро блока, чёрная линия обозначает результирующие рёбра ячеек, а серые точки показывают три узла на этом ребре.
Рёбра блока по умолчанию являются прямыми линиями, но могут быть заменены на линии другого типа, такие как дуга (arc), полилиния (polyline) или сплайн (spline). Выбор, например, дуги влияет на форму топологии ребра блока, но соединения между конечными точками сетки на этом ребре остаются прямыми линиями (см. 3.6).
3.2.2. Системы координат#
Итоговая сетка строится в глобальной (правосторонней) системе координат, которая является декартовой и ориентирована по главным координатным осям: x, y и z. Это создаёт проблему, когда блоки необходимо ориентировать и располагать в пространстве произвольным образом. Чтобы обойти эту проблему, каждому блоку назначается собственная правосторонняя система координат, которая по определению не требует ортогональности трёх осей. Три оси обозначаются x₁, x₂, x₃ (3.5). Определение локальной системы координат выполняется на основе обозначений, показанных на 3.5: вершина 0 задаёт начало координат, пара вершин (0, 1) представляет ось x₁, а оси x₂ и x₃ задаются парами вершин (0, 3) и (0, 4) соответственно.
3.2.3. Распределение узлов#
В процессе построения сетки каждый блок подразделяется на ячейки. Ячейки определяются узлами на рёбрах в каждом из трёх координатных направлений системы координат блока и подчиняются соотношению:
\( n_{cells} \)=\( n_{nodes} \)−1 (3.1)
Пользователь должен определить в blockMeshDict, сколько ячеек будет размещено на том или ином ребре. Ячейки на ребре могут быть распределены либо равномерно, либо неравномерно — на основе сгущения (grading). Существует два типа сгущений: на основе simpleGrading и на основе edgeGrading. simpleGrading описывает сгущение на ребре через отношение размера последней ячейки к размеру первой ячейки на этом конкретном ребре (см. 3.7):
\( e_{r} = \frac{\delta_{e}}{\delta_{s}} \) (3.2)
Если \( e_{r} \)=1, все узлы распределены на данном ребре равномерно, сгущение отсутствует. При коэффициенте растяжения \( e_{r} > 1 \) расстояние между узлами увеличивается от начала к концу ребра.
Рисунок 3.7: Иллюстрация коэффициента растяжения на примере ребра 3.
Из исходного кода blockMesh на C++ можно узнать, что коэффициент растяжения, задаваемый пользователем (\( e_{r} \)), масштабируется следующим соотношением:
\( r = e_{r}^{\frac{1}{1 - n}} \) (3.3)
где n — количество узлов на данном ребре. Подстановкой уравнения (3.3) в уравнение (3.4) можно вычислить относительное положение i-го узла на ребре:
\( \lambda(r,i) = \frac{1 - r^{i}}{1 - r^{n}}\ with\ \lambda \in \lbrack 0,1\rbrack \) (3.4)
Хотя это может показаться слишком трудоёмким для выполнения для всех блоков в blockMeshDict, такой подход оказывается полезным, когда требуется обеспечить плавный переход размеров ячеек между двумя соседними блоками. Во многих случаях достаточно простого метода проб и ошибок.
3.2.4. Определение словаря для минимального примера#
В качестве небольшого примера того, как правильно составить blockMeshDict, продискретизируем куб объёмом 1 м³. Подготовленный кейс можно найти в каталоге $HOME/ofprimer/cases/chapter02/blockMesh репозитория с примерами. Сам словарь состоит из одного ключевого слова и четырёх подсловарей.
Первое ключевое слово — convertToMeters, которое обычно равно 1. Все координаты точек масштабируются на этот коэффициент, что удобно, если геометрия очень большая или очень маленькая. В любом из этих случаев нам пришлось бы набирать много ведущих или замыкающих нулей, что утомительно. Установив convertToMeters соответствующим образом, мы экономим время на вводе. Первая значимая строка blockMeshDict:
convertToMeters 1;Во-вторых, должны быть определены вершины (vertices). Важно помнить, что вершины в blockMesh отличаются от точек (points) создаваемого polyMesh, хотя их определение довольно схоже. Для примера с единичным кубом определение вершин таково:
vertices
(
(0 0 0)
(1 0 0)
(1 1 0)
(0 1 0)
(0 0 1)
(1 0 1)
(1 1 1)
(0 1 1)
);
Бросив взгляд на приведённое выше определение, ясно, что синтаксис представляет собой список и похож на список точек в определении polyMesh. Это обусловлено тем, что круглые скобки в OpenFOAM обозначают список, тогда как фигурные скобки определяли бы словарь. Первые четыре строки задают все четыре вершины в плоскости x₃ = 0, а следующие строки делают то же самое для плоскости x₃ = 1. Как и в случае с точками в polyMesh, доступ к каждому элементу осуществляется по его позиции в списке, а не по координатам. Обратите внимание: каждая вершина должна быть уникальной и, следовательно, встречаться в списке только один раз.
Следующим шагом необходимо определить блоки (blocks). 3.5 можно использовать как справочный. Пример определения блока для единичного куба может выглядеть так:
blocks
(hex (0 1 2 3 4 5 6 7) (10 10 10) simpleGrading (1 1 1););
Опять же, это список, содержащий блоки, а не словарь — из-за круглых скобок. Определение может показаться странным на первый взгляд, но на самом деле оно довольно прямолинейно. Первое слово hex и первый набор круглых скобок с восемью числами указывают blockMesh сгенерировать гексаэдр из вершин от 0 до 7. Это ровно те вершины, которые были заданы в секции vertices выше, и доступ к ним осуществляется по их меткам. Их порядок не произволен, а определяется локальной системой координат блока следующим образом:
Для локальной плоскости x₃ = 0 перечислите все четыре метки вершин,
начиная с начала координат и двигаясь согласно правосторонней системе координат.
Сделайте то же самое для локальной плоскости x₃ ≠ 0.
Можно получить формально корректное определение блока, перепутав порядок списка вершин в этом конкретном определении. Результирующий блок будет выглядеть либо перекрученным, либо использовать некорректную ориентацию в глобальной системе координат. Как только blockMesh и checkMesh будут выполнены, а сетка проанализирована в постпроцессоре (например, ParaView), это обнаружится. checkMesh — это нативный инструмент OpenFOAM для проверки целостности и качества сетки по различным критериям. Если вывод checkMesh сообщает, что сетка не в порядке (not ok), её необходимо улучшить.
Второй набор круглых скобок определяет, сколько ячеек распределено в каждом конкретном направлении блока. В данном случае блок содержит по 10 ячеек в каждом направлении. Если изменить количество ячеек на 2 ячейки по x₁, 20 ячеек по x₂ и 1337 ячеек по x₃, определение блока будет выглядеть так:
hex (0 1 2 3 4 5 6 7) (2 20 1337) simpleGrading (1 1 1);Последняя оставшаяся часть — это часть simpleGrading в совокупности с последним набором чисел в круглых скобках. Это самый простой способ задания сгущения (или коэффициента растяжения), как было описано ранее. Ключевое слово simpleGrading в данном случае определяет сгущение одинаковым для всех четырёх рёбер в каждом из трёх координатных направлений локальной системы координат. Таким образом, каждое из трёх чисел, указанных в скобках после simpleGrading, задаёт сгущение для направлений x₁, x₂ и x₃ соответственно. Однако иногда этого недостаточно. Здесь можно использовать edgeGrading. Этот более продвинутый подход к сгущению, по существу, аналогичен simpleGrading, но сгущение для каждого из 12 рёбер гексаэдра может быть задано явно. В этом случае последний набор скобок содержал бы не 3 числа, а 3 раза по 4. Теперь каждое ребро можно настроить индивидуально.
Сохранение blockMeshDict и последующий запуск blockMesh дают корректную сетку, которая выглядит похожей на то, что определено в blockMeshDict. Однако blockMesh выдаёт предупреждение о неопределённых патчах, которые по умолчанию все помещаются в патч defaultFaces. Ручное указание патчей выполняется путём их определения внутри списка с именем patches. Для примера — патч 0:
boundary
(XMIN
{
faces
(
(
4
7
3
0
)
);
type patch;
Это предписывает blockMesh создать патч типа patch с именем XMIN на основе грани, построенной из вершин 4, 7, 3 и 0. Внутренне имя патча определяется как word, и этот тип данных регулярно появляется в сообщениях об ошибках. Способ упорядочения вершин, однако, не произволен. Их необходимо указывать в ориентации по часовой стрелке, если смотреть изнутри блока.
Изображение единичного куба из нашего минимального примера, состоящего из 1000 маленьких кубиков, показано на 3.8, с выделенными патчами XMIN, YMIN и ZMAX. Файлы, использованные для создания этой сетки, можно найти в репозитории примеров в каталоге chapter2/blockMesh.
 Рисунок 3.8: Единичный куб, покрытый сеткой с
помощью blockMesh с разрешением 10 ячеек в каждом направлении.
Как было сказано ранее, рёбра блока по умолчанию являются прямыми линиями, и поэтому список, содержащий определения рёбер, является необязательным. Аналогично определённым выше блокам и патчам, соединение двух вершин дугой вместо прямой линии по умолчанию выглядело бы так:
edges
(arc 0 1 (0.5 -0.5 0));
Каждый элемент списка, содержащего определения рёбер, начинается с ключевого слова, указывающего тип ребра, за которым следуют метки начальной и конечной вершин. В этом примере строка замыкается третьей точкой, которая необходима для построения дуги. Для любой другой формы ребра (например, polyLine или spline) эта точка была бы заменена списком опорных точек.
Пример того, как вставка приведённого выше кода изменяет форму единичного куба (см. 3.8), представлен на 3.9
Чтобы перейти к разделу о snappyHexMesh, вам необходимо сгенерировать единичный куб, состоящий из 50 ячеек в каждом направлении.
 Рисунок 3.9: Единичный куб, покрытый сеткой с
помощью blockMesh, с дугой на одном из рёбер.
3.2.5. snappyHexMesh#
По сравнению с blockMesh, snappyHexMesh может не требовать столь утомительной работы, такой как добавление и соединение блоков. С другой стороны, пользователь имеет меньше контроля над конечной сеткой. С помощью snappyHexMesh можно легко генерировать сетки с преобладанием гексаэдров, нуждаясь лишь в двух вещах: фоновой гексаэдральной сетке и одной или нескольких геометриях в совместимом поверхностном формате. snappyHexMesh поддерживает локальные измельчения сетки, задаваемые различными объёмными фигурами (см. таблицу 2.1), нанесение ячеек пограничного слоя (призм и многогранников) и параллельное выполнение.
snappyHexMesh — сложная программа и управляется множеством параметров. Подробное описание всех их выходит за рамки этой книги. Пожалуйста, читайте официальное руководство https://www.openfoam.com/documentation/user-guide/snappyHexMesh.php Дополнительную информацию можно найти на YouTube, напрмер на каналах - Tobias Holzmann (Holzmann CFD, József Nagy (FluidMechanics 101).
Поток выполнения snappyHexMesh можно разделить на три основных этапа, которые выполняются последовательно. Каждый из этих этапов может быть отключён установкой соответствующих ключевых слов в false в начале snappyHexMeshDict. Эти три этапа можно кратко описать следующим образом:
castellatedMesh — Это первый этап, и он выполняет две основные
операции. Во-первых, он добавляет геометрию в сетку и удаляет ячейки, не находящиеся внутри расчётной области. Во-вторых, существующие ячейки разбиваются и измельчаются в соответствии с указаниями пользователя. Результатом является сетка, состоящая только из гексаэдров, которая более или менее напоминает геометрию. Однако большинство узлов сетки, которые должны находиться на поверхности геометрии, пока с ней не совмещены. Скриншот более позднего примера на этом этапе процесса построения сетки показан на 3.10.
snap — На этапе притягивания (snapping) узлы сетки вблизи
поверхности перемещаются на поверхность. Это можно увидеть на 3.11. В ходе этого процесса топология этих ячеек может измениться с гексаэдров на многогранники. Ячейки вблизи поверхности могут быть удалены или объединены.
addLayers — Наконец, на поверхности геометрии вводятся
дополнительные ячейки, которые обычно используются для измельчения пристеночного течения (см. 3.11). Существующие ячейки отодвигаются от геометрии, чтобы освободить место для дополнительных ячеек. Эти ячейки, скорее всего, будут призмами.
Все вышеперечисленные настройки и многие другие определяются в system/snappyHexMeshDict — словаре, который содержит все параметры, необходимые snappyHexMesh. Несколько полезных туториалов можно найти в каталоге туториалов OpenFOAM в разделе meshing/snappyHexMesh.
По сравнению с другими словарями OpenFOAM, snappyHexMeshDict очень длинный и состоит из множества уровней иерархии, представленных вложенными подсловарями. Для каждого из вышеупомянутых этапов в каталог кейса записывается один временной шаг (при стандартной конфигурации). Каждый из трёх этапов будет рассмотрен по отдельности в следующем разделе.
 Рисунок 3.10: Сфера (диаметром 0,25 м) в формате
STL, покрытая сеткой с помощью snappyHexMesh после первого этапа
построения сетки. Гексаэдры пока ещё не совмещены с поверхностью тела.
 Рисунок 3.11: Та же сфера, что и выше, но после
этапа притягивания (snapping). Все узлы совмещены с поверхностью тела.
Рисунок 3.12: Призматические слои нанесены на поверхность сферы путём выдавливания поверхности.
3.2.6. Уровни ячеек (Cell levels)#
Уровни ячеек используются для описания статуса измельчения ячейки фоновой сетки. При запуске snappyHexMesh фоновая сетка считывается, и всем ячейкам присваивается уровень 0 (синие ячейки на 3.12). Если ячейка измельчается на один уровень, каждое из её рёбер делится пополам, что порождает восемь ячеек из одной исходной («родительской») ячейки. Этот метод измельчения основан на октодеревьях (octrees) и применим только к гексаэдрам, поэтому для snappyHexMesh необходима гексаэдральная фоновая сетка. С помощью snappyHexMesh невозможно измельчить ячейки только в одном направлении, поскольку это не предусмотрено октодеревьями. Поэтому ячейки измельчаются — по определению — равномерно во всех трёх пространственных направлениях.
3.2.7. Определение геометрии#
Перед началом процесса построения сетки геометрия должна быть определена в подсловаре geometry файла snappyHexMeshDict. Без необходимости что-либо определять в snappyHexMeshDict, существующая сетка в constant/polyMesh считывается автоматически и служит фоновой сеткой. Если такая сетка отсутствует или если она не состоит исключительно из гексаэдров, snappyHexMesh не запустится.
Для задач внешнего обтекания внешние границы, заданные фоновой сеткой, не так важны, как для внутренних течений. Поэтому их можно оставить такими, какими их определила фоновая сетка, не тратя на них дополнительных усилий. Для задач внутреннего течения, напротив, внешняя форма фоновой сетки не представляет интереса, поскольку она определяется собственно геометрией.
STL-геометрии могут быть созданы практически в любой CAD-программе. ParaView можно использовать для создания STL-представления базовых фигур, таких как цилиндры, сферы или конусы. В меню Sources доступны различные фигуры, которые можно экспортировать через пункт Save Data в меню File. Для реальных геометрий существуют, разумеется, различные методы создания поверхностной сетки и сохранения её в STL. Однако помните, что качество поверхностной сетки критически важно для получения хорошей объёмной сетки.
В качестве простого примера повторно используется сетка единичного куба, подготовленная в предыдущем разделе, и в неё вставляется сфера. Сфера создаётся с помощью STL-файла, а не фигур, перечисленных в таблице 2.1.
Загрузка STL-геометрии выполняется простым образом: достаточно скопировать геометрию в constant/triSurface расчётного кейса и добавить следующий подсловарь geometry в snappyHexMeshDict. Пример выглядит так:
geometry
{
sphere.stl
{
type triSurfaceMesh;
name SPHERE;
}
smallerBox
{
type searchableBox;
min (0.2 0.2 0.2);
max (0.8 0.8 0.8);
}
};
Приведённые выше строки предписывают snappyHexMesh прочитать sphere.stl из constant/triSurface как triSurfaceMesh и обращаться к геометрии, содержащейся в этом STL, по имени SPHERE.
Некоторые простые геометрические объекты можно создавать без необходимости открывать какую-либо CAD-программу — прямо внутри snappyHexMesh. Список этих геометрических фигур собран в 3.2
| Название фигуры | Тип в OpenFOAM | Параметры |
| Коробка (Box) | searchableBox | min, max |
| Цилиндр (Cylinder) | searchablecylinder | point1, point2, radius |
| Диск (Disk) | searchableDisk | origin, normal, radius |
| Плоскость (Plane) | searchablePlane | point, normal |
| Пластина (Plate) | searchablePlate | origin, span |
| Сфера (Sphere) | searchableSphere | centre, radius |
| Коллекция (Collection) | searchableSurfaceCollection | geometries |
| Поверхность с зазорами | searchableSurfaceWithGaps | gap, geometries |
Любую из фигур, перечисленных в 3.2, можно создать в подсловаре geometry, просто добавив её к существующему подсловарю. В качестве примера добавим коробку, которая строится по минимальной и максимальной точкам. При использовании этого подхода обратите внимание, что коробку невозможно повернуть напрямую — она всегда будет ориентирована по координатным осям.
smallerBox
{
type searchableBox;
min (0.2 0.2 0.2);
max (0.8 0.8 0.8);
}
Как и в случае с определением STL, ведущая строка подсловаря, определяющего searchableBox, — это имя, которое используется для доступа к данной геометрии в дальнейшем.
Иногда желательно скомпоновать геометрию из фигур, перечисленных в 3.2, но рассматривать её как одну единую геометрию, а не как множество отдельных. Для этого используется searchableSurfaceCollection. С помощью этого подхода уже существующие компоненты геометрии можно объединять, поворачивать, перемещать и масштабировать. Например, объединение SPHERE и smallerBox в один объект с именем fancyBox и масштабирование его в 2 раза выглядело бы так:
geometry
{
...
fancyBox
{
type searchableSurfaceCollection;
mergeSubRegions true;
SPHERE2
{
surface SPHERE;
scale (1 1 1);
}
smallerBox2
{
surface smallerBox;
scale (2 2 2);
}
}
}
Рисунок 3.13: Схема действий, выполняемых на этапе castellatedMesh
3.2.8. Настройка этапа castellatedMesh#
Это первый из трёх этапов выполнения snappyHexMesh. Он включает в себя два основных шага: разбиение ячеек в соответствии с указаниями пользователя и удаление ячеек, находящихся за пределами расчётной области. Схема этого процесса приведена на 3.13.
Существующая фоновая сетка (чёрная на 3.13) считывается из constant/polyMesh. На основе параметров в подсловаре castellatedMeshControls файла snappyHexMeshDict сетка измельчается. Важно различать измельчения, задаваемые поверхностями геометрии, и объёмные измельчения. Поверхностное измельчение обеспечивает, чтобы граничные грани, представляющие геометрию, были измельчены до заданного уровня. Важно отметить, что это затрагивает не только ячейки, владеющие конкретными гранями, но и соседние ячейки. Поэтому поверхностное измельчение может отчасти напоминать объёмное, однако оно принципиально отличается от него.
Применение такого поверхностного измельчения к SPHERE управляется записями в castellatedMeshControls, которые могут выглядеть следующим образом:
castellatedMeshControls
{
...
refinementSurfaces
{
SPHERE // Имя поверхности
{
level (1 1); // Мин. и макс. уровень измельчения
}
}
...
}
Это измельчает поверхность SPHERE до уровня 1. Два числа в круглых скобках задают минимальный и максимальный уровень измельчения для данной поверхности. snappyHexMesh выбирает между ними в зависимости от кривизны поверхности: сильно искривлённые участки измельчаются до более высокого уровня, менее искривлённые — до более низкого.
Измельчения в snappyHexMesh не ограничиваются поверхностными определениями. Любая геометрия, определённая в подсловаре geometry, может служить задающей формой также и для объёмного измельчения. Эти объёмные измельчения называются refinementRegions и определяются в одноимённом подсловаре внутри castellatedMeshControls. По сравнению с refinementSurfaces, refinementRegions предлагают более высокую степень универсальности и поэтому требуют указания большего числа параметров.
Параметр mode имеет три варианта: inside, outside и distance. Как следует из названий, inside затрагивает только ячейки внутри выбранной геометрии, тогда как outside делает прямо противоположное. Третий вариант, distance, является комбинацией обоих и рассчитывается в направлении внешней и внутренней нормали к поверхности.
В дополнение к режимам (mode) имеется параметр levels, который сложнее, чем для refinementSurfaces. Как можно догадаться из названия, он поддерживает произвольное количество уровней. Каждый уровень должен быть определён в связке с расстоянием. С увеличением позиции в списке уровни должны уменьшаться, а расстояния — увеличиваться.
Измельчение всего, что находится внутри smallerBox, до уровня 1 может быть выполнено добавлением следующих строк в castellatedMeshControls:
castellatedMeshControls
{
...
refinementRegions
{
smallerBox // Имя геометрии
{
mode inside; // inside, outside, distance
levels ((1E15 1)); // расстояние и уровень
}
}
...
}
Приведённый выше код использует расстояние в 1×10¹⁵ м, чтобы гарантированно выбрать все ячейки внутри геометрии.
Без указания точки, расположенной внутри объёма итоговой сетки, snappyHexMesh не сможет решить, какую сторону сферы пользователь хочет дискретизировать. Вот почему ключевое слово locationInMesh также должно быть определено в подсловаре castellatedMeshControls. Эта точка не должна находиться на грани фоновой сетки. Для примера с единичным кубом эта точка определяется как:
locationInMesh (0.987654 0.987654 0.987654);Следующий шаг — настройка параметров подсловаря snap в snappyHexMeshDict.
3.2.9. Настройка этапа snapping#
По сравнению с двумя другими этапами snappyHexMesh, этот не требует обширного пользовательского ввода. Данный этап отвечает за совмещение чисто гексаэдральных граней сетки с геометрией путём введения в сетку новых узлов и их смещения (см. 3.11). Это в высшей степени итеративный процесс, и именно поэтому от пользователя не требуется большого объёма настроек.
Пример подсловаря snapControls файла snappyHexMeshDict:
snapControls
{
nSmoothPatch 3;
tolerance 2.0;
nSolveIter 30;
nRelaxIter 5;
// Feature snapping
nFeatureSnapIter 10;
implicitFeatureSnap false;
explicitFeatureSnap true;
multiRegionFeatureSnap false;
}
Здесь определены только счётчики итераций, допуски и флаги. Половина параметров относится к притягиванию к рёбрам геометрии, что не входит в данное описание.
В зависимости от специфики задачи увеличение счётчиков итераций обычно приводит к повышению качества сетки, но также значительно увеличивает время построения сетки.
ИНФОРМАЦИЯ. Все параметры более подробно описаны в snappyHexMeshDict, поставляемом вместе с OpenFOAM.
3.2.10. Настройка этапа addLayers#
Все настройки для этапа addLayers определяются в подсловаре addLayersControls файла snappyHexMeshDict. Любая поверхность может быть использована для выдавливания призматических слоёв, независимо от её типа.
Прежде всего, количество слоёв ячеек, выдавливаемых на каждой границе, должно быть указано через подсловарь layers. Пример записи выглядит следующим образом:
addLayersControls
{
...
layers
{
"SPHERE.*" // Имя патча с регулярным выражением
{
nSurfaceLayers 3; // Количество слоёв ячеек
}
}
...
}
За каждым именем патча следует подсловарь, содержащий ключевое слово nSurfaceLayers. Это ключевое слово задаёт количество выдавливаемых слоёв ячеек, и за ним следует целое число, обозначающее количество слоёв. В приведённом выше примере не используются регулярные выражения, чтобы сопоставить любые имена патчей, начинающиеся с SPHERE. В данном случае это только сама сфера, однако возможно использование подстановочных символов таким образом может значительно сократить время настройки.
Поперечное сечение итоговой сетки показано на 3.12. Различные параметры snappyHexMesh, особенно относящиеся к выдавливанию слоёв, требуют настройки для получения сетки, отвечающей вашим требованиям. Некоторые из них кратко поясняются ниже.
expansionRatio — задаёт коэффициент растяжения от одного слоя
ячеек к следующему.
finalLayerThickness — толщина последнего слоя ячеек (наиболее
удалённого от стенки) по отношению к следующей ячейке сетки или в абсолютных метрах, в зависимости от вашего выбора параметра relativeSizes.
minThickness — если слой не может быть толще, чем
minThickness, он не выдавливается.
В примере использовались следующие настройки:
expansionRatio 1.0;
finalLayerThickness 0.5;
minThickness 0.25;
Наконец, snappyHexMesh должен быть запущен в каталоге кейса, чтобы начать процесс построения сетки. Каждый этап создаёт новую временную директорию, содержащую сетку на данной конкретной стадии. Если вы решите внести изменения в сетку путём корректировки параметров в snappyHexMeshDict, не забудьте удалить старые временные шаги перед повторным запуском snappyHexMesh.
ИНФОРМАЦИЯ. Другим высококачественным генератором сеток для OpenFOAM является enGrid, который можно свободно получить с https://github.com/engits/engrid
3.2.11. Комментарий инженера к 3.2#
3.2.11.1. Какие бывают генераторы сеток и что выбрать#
В тексте перечислены пять генераторов: blockMesh, snappyHexMesh, foamyHexMesh, foamyQuadMesh и cfMesh. На практике сегодня (2026 год) реально используются два: blockMesh для простых и фоновых сеток, snappyHexMesh для сложной геометрии. foamyHexMesh и foamyQuadMesh остались экспериментальными и в промышленной работе не встречаются. extrudeMesh и extrude2DMesh — не генераторы, а утилиты для модификации уже существующей сетки (выдавливание 2D в 3D, экструзия поверхностей). cfMesh будет рассмотрен отдельно в разделе об альтернативных генераторах.
3.2.11.2. blockMesh — не для сложной геометрии#
blockMesh требует ручного описания каждого блока: его вершин, рёбер, разбиения. Для канала или обтекания цилиндра — отлично. Для капота автомобиля — нереально. Поэтому blockMesh сегодня — это либо учебные задачи, либо создание фоновой прямоугольной сетки, в которую snappyHexMesh потом «врежет» реальную геометрию.
3.2.11.3. Что такое блок в blockMesh#
Блок — это кирпичик, из которых складывается сетка. У каждого блока 8 вершин, пронумерованных по жёсткой схеме. Порядок нумерации важен: ошибётесь — получите вывернутые ячейки или отрицательные объёмы. Между вершинами — рёбра, которые могут быть не только прямыми, но и дугами или сплайнами (для криволинейных границ).
3.2.11.4. Правосторонняя и левосторонняя система координат: почему это важно#
OpenFOAM, как и большинство инженерных пакетов (ANSYS, STAR-CCM+, CATIA, SolidWorks), использует правостороннюю систему координат. Проверяется это правилом правой руки: направьте большой палец вдоль оси X (x₁), указательный вдоль Y (x₂), средний палец отогните перпендикулярно ладони — он укажет направление оси Z (x₃). Если средний палец смотрит в противоположную сторону — вы пытаетесь применить левую руку, и система координат левосторонняя (так принято, например, в некоторых игровых движках и DirectX, но не в OpenFOAM).
Почему это критично для blockMesh. Порядок вершин в блоке должен соответствовать правосторонней ориентации. Если перепутать номера вершин, блок может получиться вывернутым — checkMesh выдаст ошибку «отрицательный объём». То же касается порядка вершин при определении граней патча: обход вершин должен давать нормаль, направленную наружу блока. Правило: глядя изнутри блока, обходите вершины грани по часовой стрелке — тогда нормаль будет смотреть наружу, и граничные условия применятся корректно.
Типичная ошибка при импорте из CAD. В разных CAD-пакетах оси могут быть направлены по-разному: например, в SolidWorks ось Y направлена вверх, а в OpenFOAM вертикальной осью обычно служит Z. Это не меняет правосторонности системы, но требует внимательности при переносе координат. Если в CAD было (X — длина, Y — высота, Z — глубина), а в OpenFOAM нужно (X — длина, Y — глубина, Z — высота), просто поменяйте координаты вершин в blockMeshDict или поверните STL при экспорте. Игнорирование этого приводит к тому, что сила тяжести, заданная в OpenFOAM как (0 0 -9.81), будет действовать не вниз, а вбок.
3.2.11.5. Дуги, сплайны и «гранёность»#
Важный момент, который многих удивляет: если вы задали ребро как дугу (arc), блок «изогнётся», но ячейки вдоль этого ребра всё равно будут с прямыми гранями. Дуга только задаёт положение промежуточных точек — сами грани ячеек остаются плоскими. Это та же история, что с STL: кривая поверхность аппроксимируется ломаной. Чем больше точек на дуге — тем ближе к гладкой кривой.
3.2.11.6. Патчи в blockMesh#
Патчами назначаются только внешние границы блока, у которых нет соседа. Если два блока прилегают друг к другу, их общая грань автоматически становится внутренней — патчем её объявлять не надо (и нельзя). Это логично: патч — это граница расчётной области, а не внутренняя стенка.
3.2.11.7. Согласование узлов между блоками#
Если у двух соседних блоков на общей грани разное количество узлов, сетка не сойдётся — OpenFOAM выдаст ошибку. Количество узлов на противоположных рёбрах блока должно совпадать. Это ограничение структурированных сеток, и именно оно делает blockMesh непригодным для сложной геометрии (где такое согласование трудно выдержать).
3.2.11.8. blockMesh как фоновый генератор для snappyHexMesh#
Самый частый сценарий: создаёте в blockMesh простую прямоугольную коробку (фоновую сетку), а потом запускаете snappyHexMesh, который «вырезает» в ней вашу сложную геометрию из STL-файла. Коробка должна быть достаточно большой, чтобы вместить всю геометрию, и достаточно мелкой, чтобы snappyHexMesh мог хорошо разрешить детали. Это стандартный workflow для 80% задач.
3.2.11.9. snappyHexMesh: что это и зачем#
snappyHexMesh — основной генератор сеток для реальной работы. Вы даёте ему грубую фоновую сетку (обычно созданную в blockMesh) и STL-файл с геометрией, а он сам вырезает геометрию из фона и подгоняет ячейки под поверхность. Физическая аналогия: взять прямоугольный брусок пенопласта и вырезать из него скульптуру горячей проволокой. Для работы нужны две вещи: фоновая гексаэдральная сетка и STL-файл. Качество STL критично: дырки, пересечения, вывернутые нормали испортят сетку. Проверять STL перед запуском утилитой surfaceCheck.
3.2.11.10. Три этапа snappyHexMesh#
Первый этап (castellatedMesh) — грубая нарезка: программа удаляет ячейки снаружи геометрии и дробит ячейки вблизи поверхности. Результат — «зубчатая» аппроксимация ступеньками из кубиков. Второй этап (snap) — притягивание: узлы сетки вблизи поверхности перемещаются прямо на неё, сетка становится гладкой, но ячейки перестают быть чистыми гексаэдрами. Третий этап (addLayers) — добавление призматических слоёв у стенок для правильного расчёта пограничного слоя.
3.2.11.11. Уровни ячеек#
Уровень — это сколько раз ячейку разделили. Уровень 0 — исходная ячейка фона. Уровень 1 — разделили пополам по всем рёбрам, получилось 8 ячеек. Уровень 2 — ещё раз разделили, 64 ячейки из одной. Из-за октодерева (octree) ячейки делятся всегда равномерно во всех трёх направлениях — нельзя измельчить ячейку только вдоль одного ребра. Это ограничение snappyHexMesh, которое нужно учитывать: мелкие детали геометрии могут вызвать избыточное измельчение во всех направлениях.
3.2.11.12. Что нужно для запуска (практический минимум)#
Построить фоновую сетку в blockMesh (куб или параллелепипед, охватывающий геометрию), скопировать STL в constant/triSurface, взять snappyHexMeshDict из туториала (из папки tutorials/mesh/snappyHexMesh), прописать в нём путь к STL и уровни refinement, указать locationInMesh (точку внутри расчётной области), запустить snappyHexMesh, затем проверить качество checkMesh. Для addLayers указать nSurfaceLayers для каждого патча (начните с 2–3), настроить firstLayerThickness и finalLayerThickness в метрах, запустить. Если слои не появились — уменьшить minThickness.
3.2.11.13. Что делать со старыми временными шагами#
snappyHexMesh создаёт папки 1/, 2/, 3/ для каждого этапа. При изменении настроек и повторном запуске старые папки нужно удалять (rm -r 1 2 3), иначе программа может запутаться. В параллельном режиме то же самое для processor*.
3.2.11.14. Полезные утилиты#
checkMesh — проверка качества сетки (запускать после каждого построения). surfaceCheck — проверка STL-файла на дырки и проблемы с нормалями (запускать до snappyHexMesh). foamListTimes — список сохранённых временных шагов.
3.3. cfMesh#
На момент написания книги (2014 г.) cfMesh активно развивался. По состоянию на 2026 год бесплатная версия не обновляется, рекомендуется использовать альтернативы cfMesh на 2026 год:
snappyHexMesh — основной бесплатный генератор. Для 90% задач его
достаточно.
blockMesh — для простых/фоновых сеток.
Gmsh (https://gmsh.info) — бесплатный
внешний генератор, хорошо работает с OpenFOAM через экспорт в формат .msh или через gmshToFoam.
Salome
(https://www.salome-platform.org) — бесплатная CAD/сеточная платформа, может генерировать сетки и экспортировать в OpenFOAM (форматы UNV, MED).
ANSA, Pointwise, STAR-CCM+ — коммерческие генераторы с отличным
экспортом в OpenFOAM, но платные.
3.4. Конвертация сеток из других источников#
Хотя blockMesh и snappyHexMesh являются мощными инструментами для построения сеток, пользователи часто применяют сторонние сеточные пакеты для определения и дискретизации более сложной расчётной области.
3.4.1. Конвертация из сторонних сеточных пакетов#
Многие продвинутые внешние утилиты для построения сеток предлагают пользователю дополнительные уровни контроля в процессе генерации сетки. К ним относятся: выбор типов элементов, встроенные сетки пограничного слоя, контроль масштаба длины и многое другое. Некоторые генераторы сеток могут экспортировать сетку непосредственно в рабочий формат OpenFOAM. Ниже приведён перечень форматов сеток, поддерживаемых для конвертации в OpenFOAM 3.0:
- Ansys, CFX, Fluent, GMSH, Gambit, Ideas, Kiva, Netgen, Plot3D, Star-CD, tetgen, KIVA
Возможности утилит импорта сильно различаются, как и используемая ими номенклатура. Утилита импорта Fluent преобразует внутренние границы в \( faceSet \), тогда как другие инструменты полностью игнорируют такие особенности.
ИНФОРМАЦИЯ. Из-за лицензионных проблем утилиту для импорта сеток из Star-CCM+ и связанные с ней библиотеки необходимо загружать и компилировать вручную, а не через скрипт \( Allrun \).
Если ваше конкретное сеточное программное обеспечение не упомянуто в приведённом выше списке, весьма вероятно, что оно способно экспортировать сетку в поддерживаемый промежуточный формат.
ИНФОРМАЦИЯ. Исходный код всех вышеупомянутых утилит конвертации находится здесь:
$WM_PROJECT_DIR/applications/utilities/mesh/conversion/.Пользователи также имеют возможность конвертировать сетки OpenFOAM в форматы Fluent или Star-CD с помощью утилит \( foamMeshToFluent \) и \( foamToStarMesh \). Это может быть особенно полезно для экспорта сеток, созданных упомянутой ранее утилитой \( snappyHexMesh \).
Процесс конвертации сетки, как правило, очень прост, с минимальными различиями в синтаксисе между разными утилитами конвертации. По этой причине будет приведён только один пример, основанный на утилите \( fluentMeshToFoam \).
Чтобы начать процесс, скопируйте кейс из туториала в выбранный каталог. Данный туториал основан на существующем туториале по конвертации сетки для решателя \( icoFoam. \)
cp -r $FOAM_TUTORIALS/legacy/incompressible/icoFoam/elbow/ $FOAM_RUN/meshConversionTest
cd $FOAM_RUN/meshConversionTest
Конвертация сетки выполняется простым запуском утилиты конвертации с передачей файла сетки в качестве аргумента; файл должен находиться в текущем каталоге. В процессе конвертации утилита выводит в консоль имена патчей и статистику сетки. Файлы, содержащиеся в каталоге \( polyMesh \), будут соответствующим образом обновлены.
fluentMeshToFoam elbow.mshВажно помнить, что импортированная сетка настолько же хороша, насколько хороша экспортированная. В случае сетки Fluent импорт двумерных сеток невозможен, поскольку OpenFOAM поддерживает только трёхмерные сетки.
После завершения импорта кейс необходимо обновить, чтобы отразить новые имена патчей в файлах начальных и граничных условий. Все существующие патчи можно либо собрать из вывода утилиты импорта, либо посмотреть вручную, открыв \( \frac{\frac{constant}{polyMesh}}{boundary} \) в редакторе. Для этого туториала поля U и p были заранее сконфигурированы под данную конкретную сетку.
Масштабирование сетки при импорте выполняется простым добавлением опции и масштабного коэффициента к команде. В рамках данного туториала сетку следует уменьшить на порядок:
fluentMeshToFoam -scale 0.1 elbow.mshПри построении сетки во многих сторонних сеточных утилитах пользователи часто могут назначать типы граничных условий, такие как inlet, outlet, wall и т.д., каждому конкретному патчу. Процесс конвертации попытается сопоставить определённые форматы граничных условий с соответствующим форматом OpenFOAM, но успех или точность преобразования граничных условий не гарантируется. Крайне важно проверить, что конвертация корректно распознала информацию о течении. Чтобы это проверить, просмотрите \( \frac{\frac{constant}{polyMesh}}{boundary} \) и запустите \( checkMesh \) на только что сконвертированной сетке.
3.4.2. Комментарий инженера к 3.4#
3.4.2.1. Зачем нужна конвертация из сторонних программ#
Не все сетки строятся встроенными средствами OpenFOAM. Если ваша компания использует коммерческие сеточные пакеты (Ansys Meshing, Fluent Meshing, Pointwise, ANSA, ICEM CFD), вы строите сетку там, а потом конвертируете её в формат OpenFOAM. Это стандартная практика в промышленности: геометрию дали в CAD, сетку сделали в том пакете, который лучше знают, а расчёт — в OpenFOAM.
3.4.2.2. Список форматов: что изменилось с версии 3.0 до 11#
В книге приведён список для OpenFOAM 3.0 (2015 год). К 2026 году (OpenFOAM 11) многое изменилось:
Ansys, Fluent, CFX — по-прежнему поддерживаются, утилиты обновляются.
GMSH — активно поддерживается, формат .msh версии 2 (ASCII) читается утилитой `gmshToFoam`.
Gambit — мёртв (последняя версия вышла в 2000-х, заменён на Ansys Meshing).
Ideas — мёртв (заменён на NX).
Kiva — мёртв (специализированный код для ДВС, не обновляется).
Netgen — жив, но утилита `netgenNeutralToFoam` всё ещё существует.
Plot3D — узкоспециализированный аэродинамический формат, используется редко.
Star-CD — мёртв (заменён на Star-CCM+), утилита `starToFoam` оставлена для обратной совместимости.
tetgen — жив, формат до сих пор поддерживается.
Star-CCM+ — требует ручной компиляции утилиты из-за лицензионных ограничений (до сих пор актуально).
**Добавлены:** форматы CGNS (через `cgusToFoam`), OpenFOAM может читать сетки из Code_Saturne, SU2, и некоторых других кодов через промежуточные форматы.
Практический совет: если ваша программа не в списке — ищите экспорт в Fluent .msh, GMSH .msh v2, или CGNS. Эти три формата — «золотой стандарт» для передачи сеток между разными CFD-пакетами.
3.4.2.3. Двумерные сетки и OpenFOAM#
OpenFOAM — трёхмерный код. Даже если задача двумерная, сетка должна иметь одно ячейковое измерение в третьем направлении (обычно 1 ячейка толщиной). При импорте 2D-сетки из Fluent она не сконвертируется — нужно либо выдавить её во Fluent до экспорта, либо использовать `extrudeMesh` после импорта.
3.4.2.4. Граничные условия при конвертации#
Не надейтесь, что импорт автоматически правильно назначит типы патчей. Fluent, CFX, Star-CCM+ имеют свои названия типов границ, и конвертер пытается их угадать, но часто ошибается. После импорта всегда открывайте \( \frac{\frac{constant}{polyMesh}}{boundary} \), смотрите имена и типы патчей, и вручную обновляйте файлы в 0/ (U, p и т.д.). Самое опасное: если конвертер неправильно понял, какой патч — стенка, а какой — выход, и вы этого не заметили, расчёт даст физически неверный результат.
3.4.2.5. checkMesh после конвертации — обязательно#
Импортированная сетка может иметь незамкнутые грани, пересекающиеся ячейки, несоответствия нормалей и другие дефекты. Запустите \( checkMesh \) сразу после конвертации. Если есть ошибки — ищите проблему в экспорте из исходной программы (не все сеточные пакеты выдают «чистую» сетку для OpenFOAM).
3.4.2.6. Экспорт из OpenFOAM в другие форматы#
Утилиты \( foamMeshToFluent \) и \( foamToStarMesh \) позволяют выгрузить сетку, созданную в OpenFOAM (например, через snappyHexMesh), обратно в формат Fluent или Star-CD. Это полезно, если нужно передать сетку коллегам, использующим другой решатель, или сравнить результаты OpenFOAM и Fluent на идентичной сетке.
3.4.2.7. Практический алгоритм импорта сетки#
Экспортируйте сетку из вашего пакета в формат .msh (Fluent) или .cgns.
Скопируйте файл в чистый кейс OpenFOAM (или в кейс из ближайшего туториала).
Запустите утилиту конвертации (например, \( fluentMeshToFoamfile.msh \)).
Проверьте вывод на консоль — там будут имена патчей и статистика.
Откройте \( \frac{\frac{constant}{polyMesh}}{boundary}, \) сверьте имена патчей.
Обновите файлы начальных условий в `0/` под новые имена патчей.
Запустите \( checkMesh \).
Если есть ошибки — вернитесь к пункту 1 и проверьте настройки экспорта.
3.4.2.8. Масштабирование: миллиметры vs метры#
OpenFOAM работает в СИ (метры, секунды, килограммы). Если сетка построена в миллиметрах, команда \( fluentMeshToFoam - scale0.001file.msh \) приведёт её к метрам. Если забыли отмасштабировать при импорте, можно потом: \( transformPoints - scale0.001 \). Характерные признаки забытого масштабирования: геометрия в ParaView выглядит в 1000 раз больше ожидаемого, числа Рейнольдса не бьются с аналитикой, сила сопротивления на порядки отличается от эксперимента.
3.4.3. Конвертация из двумерной сетки в осесимметричную#
Чтобы преобразовать сетку в осесимметричную, должны быть выполнены следующие требования. Сетка уже должна быть корректной сеткой OpenFOAM и должна иметь толщину ровно в одну ячейку. Последнее требование справедливо для всех двумерных сеток в OpenFOAM. Поскольку пример каверны из icoFoam удовлетворяет всем этим требованиям, он используется для данного туториала. Он находится по адресу $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity.
Благодаря тому, что сетка имеет форму прямоугольника и состоит всего из одной ячейки по толщине, можно создать очень простую геометрию. В OpenFOAM осесимметричная сетка обладает следующими свойствами: сетка имеет толщину в одну ячейку и повёрнута вокруг оси симметрии, образуя клин в 5°. Две наклонные границы клина считаются отдельными патчами типа wedge.
Исходный код makeAxialMesh доступен на вики OpenFOAM: http://openfoamwiki.net/index.php/Contrib_MakeAxialMesh. Следуйте инструкциям там, чтобы загрузить и скомпилировать утилиту.
Следующие шаги: создать копию папки кейса в выбранный рабочий каталог, переименовать каталог, чтобы избежать путаницы в будущем, и создать двумерную базовую сетку.
cp -r $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity/ . $FOAM_RUN/ axiSymCavity
cd $FOAM_RUN/axiSymCavity
blockMesh
Для осесимметричной сетки патч movingWall используется в качестве оси симметрии (см. 3.14). Кроме того, единственный патч frontAndBack будет разделён и станет двумя границами клина (frontAndBack_neg и frontAndBack_pos). Параметры, вводимые в командную строку, отражают это:
makeAxialMesh -axis movingWall -wedge frontAndBackУтилита создаёт новую временную директорию (в данном случае 0.005) для хранения преобразованной сетки. Если создание прошло не так, как ожидалось, достаточно удалить только эту директорию — и базовая сетка снова восстановлена.
Теперь каталог кейса должен содержать следующие папки:
0 0.005 constant systemНа этом этапе сетка была изогнута в форму клина в 5°, как показано на рисунке 2.25. Однако грани патча movingWall всё ещё присутствуют, но теперь они стянуты в грани с почти нулевой площадью. makeAxialMesh преобразует положения точек, но не изменяет связность сетки. Из-за этого патч симметрии не имеет назначенных ему граней (nFaces = 0) и должен быть удалён. В этом случае рекомендуется использовать инструмент collapseEdges. Он принимает два обязательных аргумента командной строки: длину ребра и угол слияния:
collapseEdges <длина ребра [м]> <угол слияния [градусы]>Для многих приложений длина ребра 1×10⁻⁸ м и угол слияния 179° корректно определят и удалят только что стянутые грани. В некоторых случаях, когда масштаб длины рёбер сетки чрезвычайно мал, может потребоваться меньшая длина ребра, чтобы избежать ложных срабатываний и непреднамеренного удаления корректных рёбер. Выполнение collapseEdges с указанными параметрами работает без проблем для этого примера:
collapseEdges -latestTime 1e-8 179Для окончательной «уборки» рекомендуется удалить теперь уже пустые патчи из списка границ. Откройте constant/polyMesh/boundary и удалите записи movingWall и frontAndBack. Обратите внимание, что они указаны как содержащие ноль граней: nFaces 0;. Измените размер списка границ на 3, чтобы отразить эти два удаления. Файл boundary теперь должен выглядеть примерно так:
3
(
fixedWalls
{
type wall;
nFaces 60;
startFace 760;
}
frontAndBack_pos
{
type wedge;
nFaces 400;
startFace 820;
}
frontAndBack_neg
{
type wedge;
nFaces 400;
startFace 1220;
}
)
На этом этапе патч fixedWalls можно разделить на 3 отдельных патча с помощью утилиты autoPatch. Она просматривает непрерывный патч и пытается определить подходящие места для его разделения на основе заданного угла излома. В данном случае любые рёбра патча, образующие угол более 30°, могут быть разделены для формирования нового патча. Это даёт больше гибкости при назначении граничных условий.
autoPatch -latestTime 30Патчи будут переименованы после разделения. Флаг -latestTime указывает читать только последний доступный временной шаг. Вместо перезаписи временного шага разделённая сетка сохраняется в ещё одной новой временной директории.
Наконец, сетку следует проверить на ошибки с помощью инструмента checkMesh, что следует считать общим правилом надлежащей практики: всегда запускайте checkMesh при изменении сетки.
3.4.4. Комментарий инженера к 3.4.3#
3.4.4.1. Зачем нужна осесимметричная сетка#
Если геометрия и течение симметричны относительно оси (труба, сопло, бак, цилиндр в осевом потоке), нет смысла считать всю трёхмерную область. Вместо этого считают сектор в несколько градусов (обычно 1–5°) вокруг оси симметрии. Это сокращает число ячеек в десятки раз и ускоряет расчёт. Плата: течение должно быть действительно осесимметричным (никаких винтовых течений, боковых сил).
3.4.4.2. Требование «одна ячейка по толщине»#
Все 2D-сетки в OpenFOAM — это «псевдо-3D»: они имеют ровно один слой ячеек в третьем направлении. Для плоской геометрии этот слой объявляется empty, для осесимметричной — wedge. Если у вас больше одной ячейки в тангенциальном направлении, makeAxialMesh не сработает.
3.4.4.3. Где взять makeAxialMesh в 2026 году#
Оригинальная ссылка openfoamwiki.net потребуем обязательно OpenFOAM не старше версии 2.2, наверное нет смысла специально ставить такой древний OF. Я использовал: https://github.com/johanespelund/makeAxialMesh.
3.4.4.4. Что делает makeAxialMesh (физический смысл)#
Программа берёт плоскую сетку (прямоугольник), «изгибает» её в клин и поворачивает вокруг оси, создавая две новые границы — frontAndBack_pos и frontAndBack_neg. Эти границы становятся патчами типа wedge. Физически это означает, что течение на одной стороне клина полностью идентично течению на другой стороне — как если бы клин был вырезан из полного цилиндра.
3.4.4.5. Альтернативы makeAxialMesh#
В современных версиях OpenFOAM можно создать осесимметричную сетку сразу в blockMesh или snappyHexMesh, без пост-обработки. Для простых форм (цилиндр, сопло) проще написать blockMeshDict с сектором в 5° с нуля. Для сложных — использовать snappyHexMesh с последующей обрезкой до клина.
3.4.4.6. checkMesh в конце — обязательно#
После всей цепочки преобразований (makeAxialMesh → collapseEdges → autoPatch) всегда запускайте checkMesh. Возможные проблемы: незакрытые патчи, отрицательные объёмы из-за схлопнутых ячеек, неправильная ориентация нормалей на wedge-патчах. Если checkMesh ругается — не продолжайте расчёт, ищите ошибку на предыдущем шаге.
Рисунок 3.14: Упрощённый эскиз примера каверны (cavity).
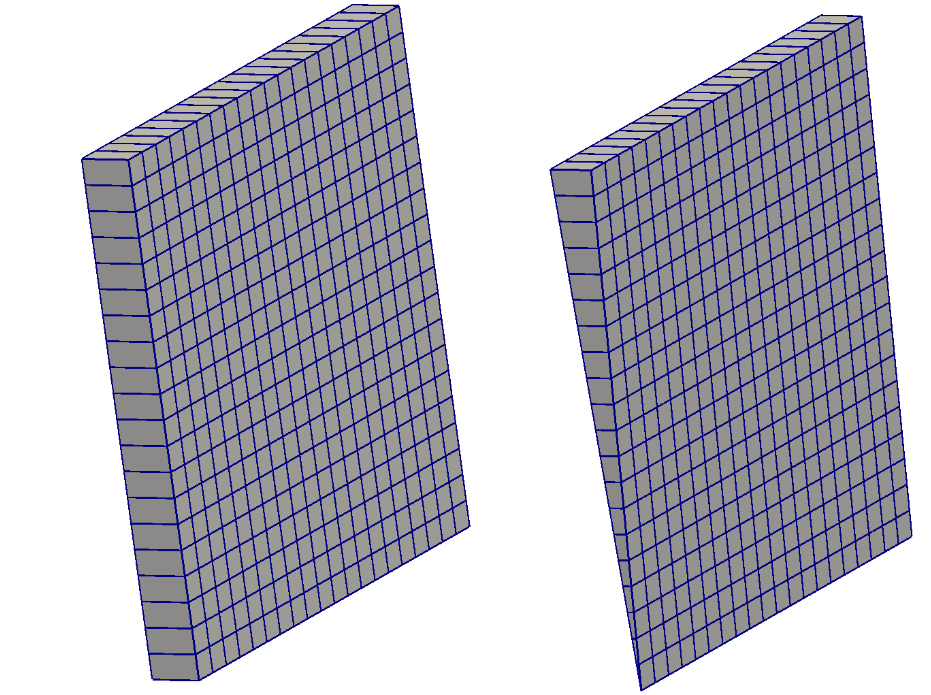 Рисунок 3.15: Двумерная сетка каверны до и после
преобразования в клин
3.4.5. Утилиты для работы с сеткой в OpenFOAM#
Утилиты (или просто «утилиты»), которые выполняют операции с сеткой, находятся в каталоге $WM_PROJECT_DIR/applications/utilities/mesh. Утилиты для работы с сеткой сгруппированы по следующим категориям: генерация (generation), манипулирование (manipulation), продвинутые (advanced) и конвертация (conversion). Эта категоризация не менялась на протяжении последних версий.
Генерация сетки и её конвертация из различных форматов в формат OpenFOAM были описаны ранее. Данный раздел охватывает манипулирование сеткой, а также продвинутые операции, такие как измельчение сетки, после того как базовая сетка уже создана.
3.4.6. Измельчение сетки по заданному критерию#
В этом примере утилита измельчения сетки refineHexMesh используется для измельчения сетки туториала damBreak решателя interFoam. Цель состоит в том, чтобы измельчить область вокруг начальной свободной поверхности, где градиент поля маркера двух фаз (\( \alpha_{water} \)) больше нуля (\( \nabla\left( \alpha_{water} \right) > 0 \)).
Для начала необходимо создать локальную копию туториала damBreak в выбранном рабочем каталоге. Все утилиты, запускаемые скриптом Allrun, должны быть выполнены, не запускается только сам решатель. Это генерирует сетку и инициализирует поле \( \alpha_{water}. \)
cd $FOAM_RUN
cp -r $FOAM_TUTORIALS/incompressibleVoF/damBreak/damBreak .
cd damBreak
blockMesh
setFields
Сетка сгенерирована с помощью blockMesh, а поле α_water задано с помощью препроцессинговой утилиты setFields.
Базовая утилита-калькулятор postProcess может быть использована для вычисления и сохранения градиента поля α_water.
postProcess -func "grad(alpha.water)" # Сначала вычисляем векторное поле градиента
postProcess -func "mag(grad(alpha.water))" # Затем вычисляем его магнитуду (скалярное поле)
Это сохранит скалярное поле величины градиента в центрах ячеек в начальной временной директории 0 под именем magGradalphaWater.
Чтобы измельчить сетку на основе величины градиента с помощью утилиты refineMesh, конфигурационный файл-словарь для этой утилиты должен быть скопирован в каталог system кейса damBreak.
cp /opt/openfoam11/etc/caseDicts/annotated/refineMeshDict system/
cat system/refineMeshDict # Проверяем содержимое
В конфигурации, теперь доступной в каталоге system, refineHexMesh измельчает все ячейки в определённом cellSet. Должно быть:
set c0; // Ячейки для измельчения; имя cell setЭтот cellSet, когда он будет создан, сохранится в constant/polyMesh, и refineHexMesh использует его для измельчения ячеек. В данном случае topoSet используется для генерации cellSet. Для этого требуется, чтобы topoSetDict присутствовал в каталоге system и был правильно настроен.
nano system/topoSetDict
FoamFile
{
version 2.0;
format ascii;
class dictionary;
object topoSetDict;
}
// * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * //
actions
(
{
name c0;
type cellSet;
action new;
source fieldToCell;
sourceInfo
{
field "mag(grad(alpha.water))";
min 20;
max 100;
}
}
);
Теперь cellSet может быть сгенерирован на основе определений в system/topoSetDict:
topoSet
refineHexMesh
При просмотре сетки в ParaView область свободной поверхности теперь должна иметь дополнительное разрешение.
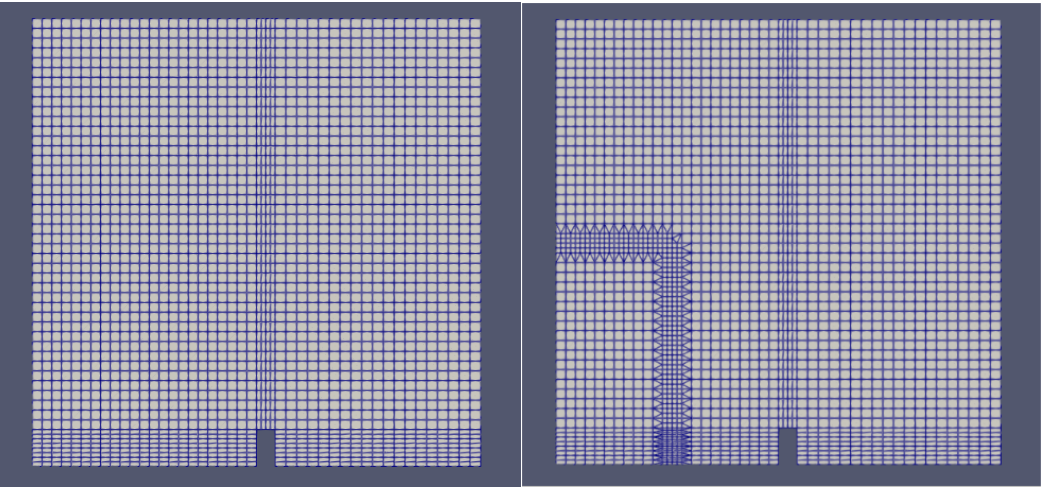
Рисунок 3.16: Исходная и результирующие сетки в Paraview
3.4.7. transformPoints#
В формате сетки OpenFOAM единственной информацией, относящейся к масштабу и положению сетки, являются векторы положения точек. Вся остальная хранимая информация о сетке основана исключительно на связности, как обсуждалось ранее. Исходя из этого, размер, положение и ориентацию сетки можно изменить, преобразуя только положения точек. Для этой цели в OpenFOAM имеется утилита transformPoints.
Поскольку эта утилита относительно проста, показан только необходимый синтаксис. Наиболее часто используемые опции при преобразовании сетки: -rotate, -translate и -scale. Также можно использовать двойные кавычки вместо одинарных вокруг скобок. Порядок выполнения операций жёстко закодирован и не может быть изменён пользователем. Если вы хотите убедиться, что масштабирование выполняется до перемещения, запустите transformPoints дважды.
scale — масштабирует точки сетки в любом или во всех
координатных направлениях на заданную скалярную величину. -scale '(1.0 1.0 1.0)' не изменяет положения точек, тогда как -scale '(2.0 2.0 2.0)' удваивает положения точек во всех направлениях равномерно. Любое неравномерное масштабирование растянет или сожмёт вашу сетку в заданном направлении(ях).
translate — перемещает сетку на заданный вектор, фактически
добавляя этот вектор к каждому вектору положения точки в сетке.
rotate — поворачивает сетку. Поворот задаётся входными
векторами. Сетка будет повёрнута так, чтобы совместить первый вектор со вторым. При повороте сетки любые начальные или граничные векторные и тензорные значения также могут быть повёрнуты путём добавления опции -rotateFields.
Синтаксис для этих трёх преобразований точек показан ниже:
transformPoints -scale '(x y z)'
transformPoints -translate '(x y z)'
transformPoints -rotateFields -rotate '( (x0 y0 z0) (x1 y1 z1) )'
3.4.8. Использование утилиты mirrorMesh#
Во многих задачах удобнее построить только часть расчётной области, используя плоскости симметрии, а затем восстановить полную геометрию с помощью отражения сетки. Для этого в OpenFOAM предназначена утилита mirrorMesh, параметры которой задаются в файле system/mirrorMeshDict.
В качестве примера рассмотрим задачу plateHole, представляющую собой четверть пластины с отверстием. В OpenFOAM 11 кейс можно подготовить следующим образом:
cd $FOAM_RUN
cp -r $FOAM_TUTORIALS/solidDisplacement/plateHole plateHoleMirror
cd plateHoleMirror
Первоначальная сетка создаётся запуском сценария:
./AllrunПосле выполнения сценария в каталоге constant/polyMesh будет создана четверть расчётной области.
Для выполнения первого отражения необходимо создать файл system/mirrorMeshDict со следующим содержимым:
FoamFile
{
format ascii;
class dictionary;
object mirrorMeshDict;
}
planeType pointAndNormal;
pointAndNormalDict
{
basePoint (0 0 0);
normalVector (0 1 0);
}
planeTolerance 1e-6;
После этого выполняется отражение:
mirrorMesh -overwriteВ результате четверть модели преобразуется в половину пластины.
Для получения полной геометрии необходимо изменить направление нормали зеркальной плоскости:
pointAndNormalDict
{
basePoint (0 0 0);
normalVector (1 0 0);}
и повторно выполнить утилиту:
mirrorMesh -overwriteПосле второго отражения получается полная пластина с центральным отверстием.
Корректность сетки рекомендуется проверять после каждого отражения:
checkMeshа визуализацию результата выполнять в ParaView:
paraFoamВ OpenFOAM 11 данная последовательность операций успешно формирует полную геометрию из четверти исходной модели и может использоваться для быстрого построения симметричных расчётных областей.
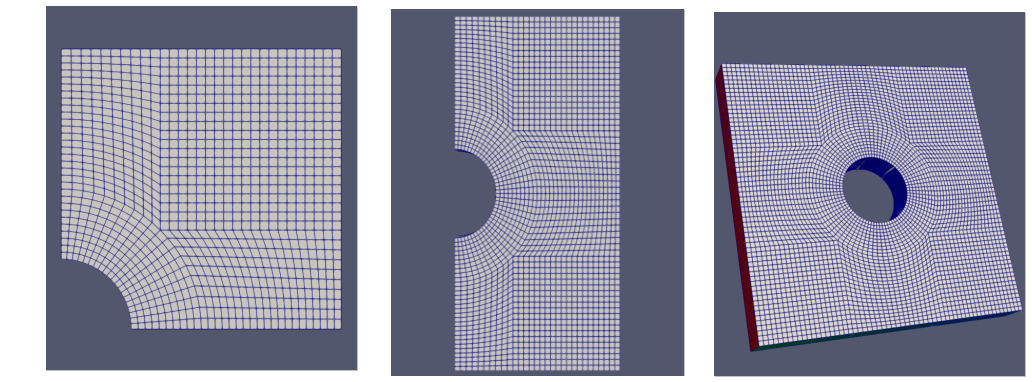 Рисунок 3.17: Исходная сетка, один раз и два
разаповернутая сетка
3.4.9. Комментарий инженера#
3.4.9.1. Утилиты mesh: где искать и что изменилось#
В OpenFOAM 11 путь к утилитам сетки: $FOAM_UTILITIES/mesh/. Категории (generation, manipulation, advanced, conversion) не изменились. Добавились новые утилиты: createPatch, subsetMesh, splitMeshRegions. Некоторые старые (foamCalc) заменены на postProcess -func.
3.4.9.2. refineHexMesh vs refineMesh: что использовать#
В книге упоминаются оба имени. В современных версиях используется refineMesh (она работает с любыми ячейками, не только с гексаэдрами). refineHexMesh — устаревшее название. Команда refineMesh с аргументом c0 (имя cellSet) делает то же самое.
3.4.9.3. topoSet: как создавать наборы ячеек#
topoSet — основной инструмент для выделения ячеек по критериям. В примере используется fieldToCell: выбираются ячейки, где значение поля magGradalpha1 попадает в диапазон [20, 100]. Это удобно: не нужно вручную указывать координаты, программа сама находит ячейки с большим градиентом. После создания cellSet сохраняется в constant/polyMesh/sets/ и используется refineMesh.
3.4.9.4. foamCalc vs postProcess#
foamCalc — старая утилита, в OpenFOAM 11 заменена на postProcess:
postProcess -func "magGrad(alpha.water)"Результат тот же, но синтаксис современный. Если foamCalc не найдена, используйте postProcess.
3.4.9.5. transformPoints: практические советы#
Масштабирование: если сетка в мм, а нужны метры — transformPoints -scale '(0.001 0.001 0.001)'.
Перенос: transformPoints -translate '(10 0 0)' сдвинет всю сетку на 10 м по X.
Поворот: transformPoints -rotate '( (1 0 0) (0 1 0) )' повернёт ось X в ось Y (на 90° вокруг Z).
Порядок операций жёсткий: сначала поворот, потом масштабирование, потом перенос. Если нужно сначала отмасштабировать, а потом повернуть — запускайте дважды.
После трансформации всегда checkMesh: при сильных искажениях качество ячеек может ухудшиться.
3.4.9.6. mirrorMesh: когда и зачем#
Полезна, когда геометрия симметрична. Строите четверть или половину сетки, а потом отражаете. Экономит время на построении сетки и уменьшает размер файлов до расчёта (хотя расчёт всё равно будет на полной сетке). Важно: плоскость отражения должна быть плоской, и патчи на плоскости отражения должны быть типа symmetry или patch — они автоматически удалятся после отражения.
3.4.9.7. Что изменилось в путях к словарям утилит#
В книге: $FOAM_APP/utilities/mesh/.../dict. В OpenFOAM 11: словари утилит часто лежат прямо в туториалах или в $FOAM_ETC/caseDicts/. Если путь из книги не работает, ищите:
find $FOAM_TUTORIALS -name "topoSetDict"
find $FOAM_TUTORIALS -name "mirrorMeshDict"
И копируйте оттуда.
3.4.9.8. Практический минимум для refineMesh#
Сгенерируйте базовую сетку и начальные поля.
Создайте cellSet через topoSet с нужным критерием (fieldToCell, boxToCell, surfaceToCell).
Убедитесь, что refineMeshDict в system/ указывает имя вашего cellSet.
Запустите refineMesh <имя_cellSet>.
checkMesh после измельчения обязателен: появление hanging nodes (висячих узлов) на стыках разного уровня измельчения — частая проблема.
4. Настройка модели(кейса) в OpenFOAM#
4.1. Структура расчётного кейса OpenFOAM#
Расчётный кейс OpenFOAM — это каталог с набором файлов, хранящихся в различных подкаталогах. Одни файлы используются для настройки и управления расчётом, другие — для хранения результирующих данных. В целом, файловая организация расчётного кейса OpenFOAM относительно проста в использовании: конфигурационные файлы можно легко редактировать в текстовом редакторе. Файловая организация даёт ещё одно преимущество: возможность легко параметризировать расчёты.
Рисунок 4.1: Схема задачи cavity (полость с движущейся стенкой).
Стандартный состав кейса OpenFOAM поясняется на примере туториала cavity, использующего решатель icoFoam для несжимаемых уравнений Навье-Стокса. Рисунок 4.1 показывает эскиз постановки кейса cavity. В каталоге кейса присутствуют и другие входные файлы, которые не требуются icoFoam, но используются утилитами препроцессинга. Как правило, количество необходимых входных словарей растёт с увеличением сложности решателя.
Вывод списка подкаталогов кейса cavity показывает способ организации файлов расчёта:
cd $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity/cavity
ls *
0:
p U
constant:
polyMesh transportProperties
system:
controlDict fvSchemes fvSolution
Каталоги 0, constant и system являются стандартными каталогами расчётных кейсов OpenFOAM, которые должны присутствовать обязательно.
Каталог 0 содержит начальные и граничные условия, применяемые к полям. Каждое поле, используемое конкретным решателем, представлено текстовым файлом, названным по имени поля. Для туториала cavity полями, используемыми в расчёте, являются поле давления p и поле скорости U. Как определяются эти поля, показано ниже.
По мере выполнения расчёта приложение-решатель записывает результирующие данные в новые подкаталоги каталога кейса. Эти каталоги являются так называемыми каталогами временных шагов, и они именуются на основе значений модельного времени. Они содержат не только те поля, которые уже определены в каталоге 0/, но и вспомогательные поля решателя, такие как объёмный поток phi. Хотя решатель icoFoam начинает расчёт с начальных значений для полей давления p и скорости U, МКО использует поля объёмного потока phi в процессе дискретизации уравнений. В результате каталоги временных шагов будут содержать поле объёмного потока phi, вычисленное решателем.
В дополнение к каталогам временных шагов могут записываться и другие данные:
приложением-решателем (например, объёмный поток phi),
функциональным объектом, работающим параллельно с решателем,
после завершения расчёта, в результате постобработки.
Каталог constant хранит данные расчёта, которые остаются постоянными на протяжении всего моделирования. Обычно сюда входят данные сетки в подкаталоге polyMesh, а также различные конфигурационные файлы:
transportProperties — транспортные свойства,
turbulenceProperties — моделирование турбулентности,
dynamicMeshDict — управление динамической сеткой,
и другие.
Не все вышеперечисленные конфигурационные файлы присутствуют в каталоге constant кейса cavity. Один из отсутствующих — словарь turbulenceProperties, который не требуется решателю icoFoam. Какие дополнительные словари должны присутствовать, зависит от выбранного приложения-решателя. Если решатель запущен в каталоге кейса без доступных необходимых входных данных, пользователь получает информативное сообщение об ошибке, уведомляющее о том, какой словарь, параметр словаря или поле отсутствует или некорректно определено.
Каталог system содержит все словари, относящиеся к численной методологии и управлению итерационными решателями. Он также может содержать словари, используемые для настройки различных приложений пре- и постобработки, таких как setFields. Самый важный словарь, содержащийся в каталоге system, — это controlDict. Он управляет всеми параметрами, относящимися к времени выполнения решателя и частоте, с которой данные решения записываются в каталог кейса. Все параметры, определённые в controlDict, не зависят от решателя, используемого для расчёта.
Если приложение-решатель использует функцию динамической сетки, где положения точек или топология сетки изменяются, новая папка polyMesh также записывается в каждый каталог временного шага.
4.1.1. Комментарий инженера к 4.1#
4.1.1.1. Три священных каталога:0,constant,system#
Это фундамент, который не изменился с первых версий. Запомните мнемонику: 0 — «начало» (начальные условия), constant — «неизменное» (сетка и физические константы), system — «управление» (настройки расчёта). Если кейс не содержит хотя бы один из этих трёх каталогов, OpenFOAM не запустится.
4.1.1.2. Что изменилось в структуре кейса к 2026 году#
В книге используется icoFoam и путь incompressible/icoFoam/cavity. В OpenFOAM 11 icoFoam перенесён в legacy/incompressible/icoFoam/. Для новых задач лучше использовать pisoFoam или pimpleFoam. В современных кейсах часто добавляется файл system/snappyHexMeshDict (для построения сетки), а в constant/ может находиться подкаталог triSurface/ с STL-файлами. В остальном структура кейса жёстко стандартизирована и обратно совместима.
4.1.1.3. Каталоги временных шагов: что это и зачем#
Решатель пишет результаты не в один файл, а создаёт новые папки с именами, соответствующими модельному времени: 0.1/, 0.2/, ..., 1.0/. В каждой папке — полный набор полей на этот момент времени. Это позволяет в любой момент остановить расчёт, посмотреть промежуточный результат и продолжить с того же места. Не удаляйте эти папки во время расчёта. После завершения их можно архивировать или удалить, оставив только последний шаг.
4.1.1.4. Поле phi: зачем оно нужно#
phi — это объёмный поток через грани ячеек (velocity × face area). Вы не задаёте его в 0/, решатель вычисляет его сам на каждом шаге. Он нужен для дискретизации конвективного члена. Если вы видите phi в каталогах временных шагов — это нормально, не ошибка.
4.1.1.5. controlDict — главный пульт управления#
В этом файле задаётся: время старта и остановки, шаг по времени, как часто сохранять результаты, формат записи. Параметры не зависят от конкретного решателя, поэтому, научившись настраивать controlDict один раз, вы сможете применять эти знания к любому кейсу.
4.1.1.6. Что бывает, если словарь отсутствует#
OpenFOAM не падает молча. Если решателю не хватает файла (например, turbulenceProperties для турбулентного расчёта), он выдаст конкретное сообщение: «Cannot find dictionary turbulenceProperties». Это удобно для отладки.
4.1.1.7. Динамическая сетка и polyMesh во временных шагах#
Если сетка движется (вращение, деформация), решатель сохраняет новую сетку на каждом временном шаге в папку с этим шагом. Это увеличивает объём данных на диске в разы. Для статических сеток polyMesh лежит только в constant/.
4.1.1.8. Практический совет по структуре кейса#
Создавая новый кейс, не пишите файлы с нуля. Скопируйте ближайший туториал из $FOAM_TUTORIALS и замените в нём сетку, граничные условия и параметры под свою задачу. Это убережёт от пропуска обязательных файлов и опечаток в заголовках FoamFile.
4.2. Граничные и начальные условия#
Расчётный кейс OpenFOAM представляет собой каталог, содержащий различные подкаталоги и файлы, используемые для настройки расчёта. Такая файловая структура делает задание как граничных, так и начальных условий очень простым. Каждая физическая величина (давление, температура, поле скорости и т.д.), важная для расчёта, имеет свой файл, хранящийся в каталоге 0 — каталоге, который относится к первому временному шагу расчёта. В этом разделе рассматривается, как граничные и начальные условия из раздела 2.1 применяются на практике в этих файлах.
В зависимости от тензорного ранга поля (скаляр, вектор, тензор) их соответствующие значения задаются с использованием немного различающегося синтаксиса. Данное обсуждение будет ограничено настройкой кейса; численные и проектные детали граничных условий обсуждаются далее.
Граничные условия, как следует из их названия, определяют значения полей на границах сетки. Начальные условия относятся к начальным значениям внутреннего поля. Различие между внутренними и граничными значениями показано на рисунке 1.12.
Прежде чем подробно рассмотреть, как определяются файлы граничных условий, кейс cavity, предназначенный для расчёта с помощью icoFoam, необходимо скопировать в выбранное место. Чтобы задать базовое граничное условие для расчётного кейса каверны, каталог кейса нужно скопировать и переименовать:
cp -r $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity/cavity cavityOscillatingU
cd cavityOscillatingU
Просмотр каталога 0/ показывает, что определены два различных поля: p и U. Оба файла можно редактировать с помощью любого текстового редактора прямо из командной строки. Соответствующие строки файла граничных условий для давления можно вывести на экран следующей командой:
cat 0/p | tail -n 23 | head -21
dimensions [0 2 -2 0 0 0 0];
internalField uniform 0;
boundaryField
{
movingWall
{
type zeroGradient;
}
fixedWalls
{
type zeroGradient;
}
frontAndBack
{
type empty;
}
}
Это показывает три записи верхнего уровня файла граничных условий: dimensions, internalField и boundaryField.
Первая запись — это набор скалярных размерностей (dimensionSet), который используется для определения размерности поля. Каждый скаляр соответствует показателю степени конкретной единицы СИ, как определено в исходном файле объявления размерного набора (dimensionSet.H):
//- Определение перечисления для имён показателей размерности
enum dimensionType
{
MASS, // килограмм kg
LENGTH, // метр m
TIME, // секунда s
TEMPERATURE, // Кельвин K
MOLES, // моль mol
CURRENT, // Ампер A
LUMINOUS_INTENSITY // Кандела Cd
};
Следующая запись — internalField, которая определяет начальные условия для поля. Обратите внимание, что сюда не входят границы, которые определяются последним подсловарём: boundaryField. В данном примере всем значениям в ячейках присвоено значение 0. Также возможно задавать начальные значения для каждой ячейки отдельно, что требует от пользователя составления списка с желаемым значением для каждой ячейки. Этот список должен содержать столько же элементов, сколько ячеек присутствует в сетке.
Наконец, внутри подсловаря boundaryField определяются граничные условия. Граничные условия должны быть указаны для каждого патча и для каждого поля. Таким образом, граничное условие для каждого патча определяется в подсловаре словаря boundaryField.
4.2.1. Комментарий инженера к 4.2#
4.2.1.1. Ранг — это "уровень сложности" величины#
| Ранг | Инженерный смысл | Пример | Инженерный перевод | Тип в OpenFOAM |
|---|---|---|---|---|
| 0 (скаляр) | «У меня есть значение в каждой точке (например, температура)» | Температура T, давление p | «Одно число — одна точка» | scalarField |
| 1 (вектор) | «У меня есть значение и направление (например, ветер дует с силой X в сторону Y)» | Скорость , сила | «Стрелка: длина + направление» | vectorField |
| 2 (тензор) | «У меня есть связь между направлениями: как давление в направлении X влияет на деформацию в направлении Y» Таблица 3×3 | Напряжения , деформации , градиент скорости ∇U | как одно направление влияет на другое», три стрелки | TensorField, symmTensorField |
4.2.1.2. Тензор математически#
Тензор — это многомерная таблица чисел, которая преобразуется по определённому закону при смене системы координат. Например тензор напряжений:
\( \sigma = \begin{bmatrix} \sigma_{xx}\sigma_{xy}\sigma_{xz} \\ \sigma_{yx}\sigma_{yy}\sigma_{yz} \\ \sigma_{zx}\sigma_{zy}\sigma_{zz} \end{bmatrix} \)Где σxy — это сила в направлении y, действующая на площадку, нормальную к x. Формальное определение: Тензор — это объект, который при повороте системы координат преобразуется по правилу:
\( U'_{i} = \sum_{}^{}R_{ij}U_{j} \) для вектора (ранг 1)
\( T'_{ij} = \sum_{}^{}{\sum_{}^{}R_{ik}}R_{jl}T_{kl} \) для тензора (ранг 2), где R — матрица поворота
4.2.1.3. Три обязательных элемента файла поля#
Каждый файл в 0/ (будь то p, U, T) имеет три секции: dimensions, internalField, boundaryField. Это жёсткая структура, без которой OpenFOAM не прочитает файл. Порядок секций не важен, но их наличие обязательно. Если забыли dimensions — получите ошибку размерностей при запуске. Если забыли boundaryField для какого-то патча — решатель упадёт.
4.2.1.4. Размерности: что означают эти семь чисел#
[0 2 -2 0 0 0 0] — это показатели степени для семи базовых единиц СИ в порядке: кг, м, с, К, моль, А, кд. Для давления: \( {кг}^{0} \times м^{2} \times с^{( - 2)} = \frac{m^{2}}{c^{2}} \) . В СИ это Па/ρ (давление, делённое на плотность). В OpenFOAM для несжимаемых течений давление хранится как P/ρ, отсюда такие размерности. Если вы используете сжимаемый решатель, размерности будут [1 -1 -2 0 0 0 0] (\( {кг}^{1} \cdot м^{- 1} \cdot с^{- 2} \) = Па). Всегда проверяйте размерности в туториале для вашего решателя — ошибка на этом этапе даёт физически бессмысленный результат.
4.2.1.5. internalField: как задать начальное поле#
uniform 0 означает «одинаковое значение 0 во всех ячейках». Это самый частый вариант для начала расчёта. Альтернативы: nonuniform List<scalar> — список значений для каждой ячейки (громоздко, используется редко, обычно через утилиту setFields). Для векторных полей (U): uniform (0 0 0).
4.2.1.6. boundaryField: каждый патч обязан быть описан#
Если в сетке есть патч inlet, а в 0/U вы про него забыли — ошибка. Имена патчей должны совпадать с именами в constant/polyMesh/boundary. Регистр важен: Inlet и inlet — разные патчи. После построения или конвертации сетки всегда проверяйте имена патчей командой checkMesh или cat constant/polyMesh/boundary.
4.2.1.7. Типы граничных условий на практике#
В примере выше: zeroGradient означает «градиент равен нулю на границе» (для давления на стенках — нормально), empty означает «этот патч не учитывается в расчёте» (используется для передней и задней стенок в 2D-задачах). Другие частые типы: fixedValue (задать конкретное значение), noSlip (скорость = 0 на стенке), symmetry (плоскость симметрии), wedge (осесимметричный клин).
4.2.1.8. Что изменилось к 2026 году#
В книге используется icoFoam и путь incompressible/icoFoam/cavity. В OpenFOAM 11 icoFoam перенесён в legacy/. Современные кейсы используют pisoFoam или pimpleFoam. Тип патча symmetryPlane заменён на symmetry. Добавлены новые типы: inletOutlet (переключается между fixedValue и zeroGradient в зависимости от направления потока), cyclicAMI (для неконформных интерфейсов), overset (для химерных сеток). Для старта сойдут и базовые типы из книги — они поддерживаются полностью.
Практический минимум при настройке 0/
Скопируйте файлы из туториала, похожего на вашу задачу.
Проверьте имена патчей через cat constant/polyMesh/boundary.
Для каждого патча пропишите граничное условие в 0/U, 0/p и других полях.
Убедитесь, что dimensions соответствуют вашему решателю (несжимаемый/сжимаемый).
Запустите решатель. Если ругается на отсутствующий патч или поле — добавьте недостающее.
4.2.2. Задание граничных условий#
Официальный релиз OpenFOAM поставляется с множеством граничных условий. В OpenFOAM 11 вместо foamHelp используется утилита foamInfo, которая показывает информацию о конкретном граничном условии. Чтобы получить список всех доступных граничных условий, совместимых с конкретным полем, проще всего просмотреть каталог производных граничных условий:
ls $FOAM_SRC/finiteVolume/fields/fvPatchFields/derived/Для получения справки по конкретному граничному условию:
foamInfo codedFixedValueНекоторые из доступных условий очень общие, другие — узкоспециализированные.
В качестве примера используем кейс cavityOscillatingU. Заменим граничное условие на патче movingWall для поля скорости U на такое, которое обеспечивает колебания скорости во времени (рисунок 3.1).
Шаг 1: Копируем кейс
cd $FOAM_RUN
cp -r $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity cavityOscillatingU
cd cavityOscillatingU
Шаг 2: Проверяем имена патчей
cat constant/polyMesh/boundaryЕсли сетка ещё не сгенерирована, сначала выполните blockMesh.
Шаг 3: Правим 0/U
Откройте файл 0/U и замените блок movingWall:
movingWall
{
type fixedValue;
value uniform (1 0 0);
}
Замените его на:
movingWall
{
type codedFixedValue;
value uniform (0 0 0);
name oscillatingFixedValue;
code
#{
operator==(Foam::cos(this->db().time().value() * M_PI)*vector(1, 0, 0));
#};
}
Внимание: ключевое слово code перед #{ обязательно в OpenFOAM 11. Строки #{ и #} должны начинаться строго с первой позиции (без пробелов). Содержимое между ними — с отступом в 8 пробелов. После #} обязательна точка с запятой. Полный файл 0/U после правки (заголовок опущен):
FoamFile
{
version 2.0;
format ascii;
class volVectorField;
object U;
}
dimensions [0 1 -1 0 0 0 0];
internalField uniform (0 0 0);
boundaryField
{
movingWall
{
type codedFixedValue;
value uniform (0 0 0);
name oscillatingFixedValue;
code
#{
operator==(Foam::cos(this->db().time().value() * M_PI)*vector(1, 0, 0));
#};
}
fixedWalls
{type noSlip;}
frontAndBack
{type empty;}
}
Шаг 4: Увеличиваем время расчёта
Откройте system/controlDict и измените:
endTime 4.0;
deltaT 0.005;
Шаг 5: Генерируем сетку и запускаем расчёт
blockMesh
icoFoam
Шаг 6: Визуализация в ParaView
paraFoam[В ParaView:]{.underline} В левой панели Pipeline Browser выделите case.foam и нажмите кнопку Apply (зелёная кнопка в панели Properties). Включите отображение стрелок скорости: Выделите case.foam в Pipeline Browser, Меню Filters → Common → Glyph. В панели Properties установите: Glyph Type: Arrow, Orientation Array: U, Scale Array: U, Scale Factor: 0.01 и нажмите Apply. Запустите анимацию: На верхней панели нажмите кнопку Play Или переключайте временные шаги вручную через выпадающий список времени. Для наглядности добавьте цветовое отображение скорости: Выделите case.foam в Pipeline Browser. На верхней панели смените Solid Color на U. Нажмите кнопку Rescale to Data Range (две стрелки). На анимации будет видно: в начальный момент (t ≈ 0) стрелки на верхней стенке направлены вправо, к t ≈ 0.5 с они исчезают и появляются влево, к t ≈ 1 с снова направлены вправо. Внутренний поток подхватывает движение стенки и пульсирует.
В приведённом фрагменте кода на C++ перегружен оператор присваивания поля OpenFOAM: скорость устанавливается равной cos(π·t)·(1, 0, 0), что заставляет её менять направление раз в секунду. Код компилируется при первом запуске и сохраняется в папке dynamicCode/. При повторных запусках перекомпиляция не требуется.
Выбор граничного условия требует внимательности, особенно при сравнении с экспериментом (валидация) или точным решением (верификация). Примеры использования различных граничных условий можно найти в туториалах OpenFOAM:
ls $FOAM_TUTORIALS/incompressibleFluid/4.2.3. Комментарий инженера к 4.2.2.#
foamHelp → foamInfo. Утилита foamHelp заменена на foamInfo. Синтаксис изменился: теперь это поиск по имени граничного условия, а не фильтр по типу поля. Для быстрого просмотра всех доступных ГУ откройте $FOAM_SRC/finiteVolume/fields/fvPatchFields/derived/.
Ключевое слово code обязательно. В OpenFOAM 11 синтаксис codedFixedValue требует явного указания code перед блоком #{...#}. Без этого слова парсер не распознаёт граничное условие.
Имена патчей. В OpenFOAM 11 кейс cavity для icoFoam перенесён в legacy/. Имена патчей (movingWall, fixedWalls, frontAndBack) остались прежними, но перед правкой всегда проверяйте constant/polyMesh/boundary.
transportProperties → physicalProperties. Файл с вязкостью переименован в constant/physicalProperties. Содержимое то же: nu [0 2 -1 0 0 0 0] 0.01;.
Заголовок FoamFile обязателен. Если файлы не имеют заголовка FoamFile { ... }, OpenFOAM выдаст ошибку чтения. Добавьте заголовок в начало каждого файла.
Практический совет. Если codedFixedValue не работает — проверьте логи компиляции в dynamicCode/. Ошибка в C++ внутри словаря приводит к падению решателя с сообщением, указывающим на конкретную строку в 0/U.
4.2.4. Задание начальных условий#
В этом разделе даётся обзор того, как задавать начальные условия расчёта. Начальные условия определяют значения внутреннего поля в начале моделирования. Существует множество различных инструментов для инициализации полей в соответствии с требованиями пользователя. Задание начальных условий (НУ) относится к препроцессингу.
Начальные условия могут быть тривиальными, как в кейсе cavity: начальные значения скорости и давления во внутренних ячейках заданы однородным нулевым значением. Уже после первого временного шага рассчитанное решение обычно сильно отличается от начального. Для стационарного однофазного несжимаемого течения начальные условия можно рассматривать как начальное приближение, ускоряющее сходимость к установившемуся состоянию. Если это приближение слишком далеко от реального решения, решатель может разойтись.
В других ситуациях начальные условия критически важны, поскольку они определяют эволюцию поля во времени. Расчёты сжимаемых течений сильно зависят от начальных значений давления, температуры и плотности для корректного вычисления уравнения состояния. Несжимаемые многофазные расчёты требуют очень точных начальных значений поля-индикатора фаз, разделяющего жидкие фазы. Большие ошибки в начальном индикаторе фаз вызывают ещё большие ошибки в аппроксимации кривизны, что приводит к сильной численной неустойчивости и вероятному разрушению расчёта.
Пример каверны относительно терпим к определению начальных условий. Кейсом с особыми требованиями к начальным условиям является damBreak, моделируемый решателем interFoam. Это решатель двухфазного течения, использующий алгебраический метод Volume-of-Fluid (VOF) для различения двух несмешивающихся и несжимаемых жидких фаз. Для этой цели вводится скалярное поле alpha.water. Газовая и жидкая фазы в этом примере имеют значения 0 и 1 соответственно ( см. в коментариях к следующему разделу).
Добавим водяную каплю в кейс damBreak, как показано на рисунке 3.2.
Шаг 1: Копируем и переименовываем кейс
cd $FOAM_RUN
cp -r $FOAM_TUTORIALS/incompressibleVoF/damBreak/damBreak damBreakWithDrop
cd damBreakWithDrop
./Allrun
Шаг 2: Сохраняем оригинал поля alpha.water
Исходные значения полей обычно хранятся в подпапке 0 или в файлах *.orig. Копируем оригинал. Текущее состояние поля alpha.water — всё внутреннее поле имеет значение 0:
cp 0/alpha.water 0/alpha.water.orig
internalField uniform 0;
Шаг 3: Создаём setFieldsDict
Утилита setFields позволяет создавать неоднородные начальные значения полей. Она управляется словарём system/setFieldsDict. Если этого файла нет в кейсе, скопируйте его из туториала:
cp $FOAM_TUTORIALS/incompressibleVoF/damBreak/damBreak/system/setFieldsDict system/Отредактируйте system/setFieldsDict, добавив sphereToCell для создания капли:
defaultFieldValues
(
volScalarFieldValue alpha.water 0
);
regions
(
boxToCell
{
box (0 0 -1) (0.1461 0.292 1);
fieldValues
(
volScalarFieldValue alpha.water 1
);
}
sphereToCell
{
centre (0.4 0.4 0);
radius 0.05;
fieldValues
(
volScalarFieldValue alpha.water 1
volVectorFieldValue U (-1 0 0)
);
}
);
defaultFieldValues устанавливает всему внутреннему полю значение 0, затем обрабатывается словарь regions. Синтаксис setFieldsDict интуитивно понятен: для каждого объёма все ячейки, центр которых попадает внутрь, получают указанные значения. sphereToCell выбирает ячейки внутри сферы с заданным центром и радиусом, устанавливает α_water = 1 и U = −1, 0, 0
Шаг 4: Препроцессинг и запуск расчёта
blockMesh
setFields
interFoam
Шаг 5: Визуализация начальных условий
paraFoam
Рисунок 4.2: Начальные условия до и после добавления капли.
4.2.5. Комментарий инженера к 4.2.4.#
Путь к кейсу damBreak. В книге: $FOAM_TUTORIALS/multiphase/interFoam/laminar/damBreak/damBreak. В OpenFOAM 11: $FOAM_TUTORIALS/incompressibleVoF/damBreak/damBreak. Многофазные течения переехали в отдельные категории.
setFields — синтаксис без изменений. Словарь setFieldsDict полностью обратно совместим. Поддерживаются примитивы: boxToCell, sphereToCell, cylinderToCell, surfaceToCell и другие.
Практическая опасность. Если две области в regions перекрываются, применяется последняя по порядку. Координаты всегда в метрах. После setFields обязательно проверяйте поле в ParaView — опечатка в координатах может привести к тому, что капля окажется за пределами сетки, и расчёт пойдёт без неё.
Начальные условия для interFoam. Для VOF-решателей поле alpha.water должно быть строго 0 или 1 в начальный момент. Размазанные значения (0.3, 0.7) приведут к развалу расчёта на первых шагах. Всегда используйте setFields для задания резкого интерфейса
4.3. Схемы дискретизации и управление решателем#
Выбор схемы дискретизации, равно как и настройка управляющих параметров для линейных решателей, так же важен, как и задание граничных условий. Схемы дискретизации определяются в system/fvSchemes, а решатель управляется словарём system/fvSolution.
4.3.1. Численные схемы (fvSchemes)#
С точки зрения пользователя, все определения, связанные с дискретизацией неструктурированным методом конечных объёмов и интерполяцией, задаются в словаре system/fvSchemes. Требуемые настройки различаются от решателя к решателю и зависят от формулировки конкретных членов математической модели. Схемы дискретизации и интерполяции используются в рамках МКО для дискретизации членов математической модели.
В OpenFOAM математическая модель определяется в приложении-решателе с использованием предметно-ориентированного языка (Domain Specific Language, DSL). DSL был разработан по мере того, как уровень абстракции алгоритмической реализации со временем становился всё выше. В других источниках информации об OpenFOAM DSL часто называют «уравне-подражанием» (equation mimicking). Использование алгоритмов на более высоком уровне абстракции с уравне-подражанием позволяет получить очень читаемое для человека определение математических моделей, а также тривиальную модификацию математической модели.
Например, следующий фрагмент исходного кода из приложения-решателя icoFoam показывает реализацию закона сохранения импульса в OpenFOAM:
fvVectorMatrix UEqn
(
fvm::ddt(U)
+ fvm::div(phi, U)
- fvm::laplacian(nu, U)
);
solve(UEqn == -fvc::grad(p));
Различные члены уравнения импульса легко узнаваемы, добавляемы, удаляемы или изменяемы. Для каждого из этих членов необходимо определить эквивалентную дискретизацию в system/fvSchemes.
Предметно-ориентированный язык (DSL) для одних приложений разрабатывается целенаправленно, а для других является естественным следствием разработки программного обеспечения с чётким разделением уровней абстракции. Мышление в терминах дискретизированных уравнений, матриц и источниковых членов, а не в терминах, скажем, итерационных циклов, указателей на переменные и функций, представляет собой основу уравне-подражания / DSL в OpenFOAM. Разделение уровней абстракции является признаком хорошей практики разработки программного обеспечения.
Схемы дискретизации и интерполяции являются строительными блоками операций, перечисленных в исходном коде выше. Они преобразуют дифференциальные локальные уравнения в алгебраические уравнения, со свойствами, осреднёнными по конечным объёмам. Те члены, которые участвуют в сборке алгебраической системы, называются неявными членами. Члены, которые вычисляются явно (расположенные в правой части уравнения), называются явными членами. Явные члены вычисляются с помощью дискретных операторов из пространства имён fvc (finite volume calculus), тогда как неявные члены вычисляются с помощью операторов из пространства имён fvm (finite volume method). Важно запомнить это различие, поскольку схема дискретизации, определённая для члена в файле словаря system/fvSchemes, будет затем использоваться по умолчанию как для операторов fvc::, так и для fvm:: в коде приложения.
Чтобы получить список поддерживаемых схем для конкретного члена, просто замените существующую схему в словаре fvSchemes на любое слово и запустите решатель. Ошибка, возвращаемая решателем, сообщит, что схемы с таким намеренно выбранным именем не существует. Но за этим последует большой список, показывающий все доступные схемы. Чтобы получить информацию о параметрах схемы (специфичные для схемы ключевые слова и значения), пользователю необходимо просмотреть исходные файлы, связанные с реализацией схемы.
Уравнения, реализованные в приложении-решателе, определяются на этапе компиляции. Однако выбор схем, используемых для дискретизации членов этих уравнений, выполняется на этапе выполнения. Это позволяет пользователю изменять способ дискретизации математической модели: выбирая различные схемы для разных кейсов, путём изменения записей в system/fvSchemes.
Схемы дискретизации и интерполяции являются обобщёнными алгоритмами в OpenFOAM. Чтобы различать неявные алгоритмы (сборка матрицы) и явные алгоритмы (источниковые члены), алгоритмы распределены по пространствам имён C++. Пространство имён — это конструкция языка программирования, используемая для предотвращения конфликтов поиска имён.
Словарь system/fvSchemes кейса cavityOscillating:
ddtSchemes
{
default Euler;
}
gradSchemes
{
default Gauss linear;
grad(p) Gauss linear;
}
divSchemes
{
default none;
div(phi,U) Gauss linear;
}
laplacianSchemes
{
default Gauss linear orthogonal;
}
interpolationSchemes
{
default linear;
}
snGradSchemes
{
default orthogonal;
}
Каждый словарь fvSchemes имеет одни и те же 7 подсловарей и, скорее всего, параметр default, определённый в начале каждого подсловаря. Сравнение фрагмента кода уравнения импульса в том виде, как оно реализовано в icoFoam, с приведённым выше листингом показывает, что в данной конфигурации div(phi,U) дискретизируется с использованием метода linear.
Далее представлен обзор различных категорий схем дискретизации и характеристик отдельных схем. Если последующее описание отдельных схем окажется неясным после первого прочтения, это не повлияет на понимание остальной части книги. Заинтересованные могут вернуться к этой части книги позже и перечитать её вместе с главой 1. Описание всех доступных схем в OpenFOAM выходит за рамки данной книги, поэтому рассматриваются лишь несколько избранных схем.
Схемы сортируются по категориям, которые соотносятся с членами математической модели, а также с записями в system/fvSchemes:
ddtSchemes
gradSchemes
divSchemes
laplacianSchemes
interpolationSchemes
snGradSchemes
Так называемый Run-Time Selection (RTS) в OpenFOAM позволяет выбирать различные схемы в system/fvSchemes. Этот модуль выводит список всех доступных схем, если запись в system/fvSchemes неверна. Это можно использовать для изучения доступных схем: ввод имени несуществующей схемы побуждает систему RTS предоставить список доступных схем.
4.3.1.1. ddtSchemes#
ddtSchemes — это схемы, используемые для временной дискретизации. Схема Эйлера первого порядка установлена по умолчанию для нестационарных задач; именно эта схема использовалась для демонстрации практики дискретизации МКО в главе 2. Альтернативные варианты схем временной дискретизации:
CoEuler,
CrankNicolson,
Euler,
SLTS,
backward,
bounded,
localEuler,
steadyState.
Из доступных схем временной дискретизации ниже более подробно поясняются CoEuler и backward.
4.3.1.1.1. Схема CoEuler#
Cхема временной дискретизации первого порядка, которая может использоваться как для неявной, так и для явной дискретизации. Она автоматически подстраивает временной шаг локально таким образом, чтобы локальное число Куранта ограничивалось заданным пользователем значением. Схема вычисляет поле локального временного шага, используя текущее значение шага и поле масштабного коэффициента, вычисленное из поля локального числа Куранта. Обратная величина локального временного шага с ограничением по числу Куранта вычисляется как:
\( \delta t_{fCo}^{- 1} = \max\left( \frac{{Co}_{f}}{maxCo},1 \right)\delta t^{- 1} \) (4.1)
где локальное число Куранта в центре грани вычисляется из объёмного потока \( F \), вектора нормали к грани \( S_{f} \) и расстояния между центрами ячеек, соединённых этой гранью, \( d \):
\( {Co}_{f} = \frac{\left\| F \right\|}{\left\| S_{f} \right\|\left\| d \right\|}\delta t \) (4.2)
Если предоставлен массовый поток, для вычисления локального числа Куранта в центре грани необходимо использовать поле плотности:
\( {Co}_{f} = \frac{\left\| F_{\rho} \right\|}{\rho_{f}\left\| S_{f} \right\|\left\| d \right\|}\delta t \) (4.3)
где \( F_{\rho} \) — массовый поток, сохранённый в центре грани.
После того как число Куранта в центре грани вычислено, обратная величина временного шага вычисляется по формуле (3.1). Для поля \( \phi_{f} \) в центре грани обратная величина временного шага в центре грани затем используется для вычисления производной первого порядка по времени:
\( \delta t_{fCo}^{- 1}\left( \phi_{f}^{n} - \phi_{f}^{o} \right) \) (4.4)
Поскольку временные схемы работают в основном с полями в центрах ячеек, значение обратной величины временного шага в центре ячейки вычисляется как максимум из значений на гранях, т.е.:
\( \delta t_{c}^{- 1} = \max_{f}\left( \delta t_{fCo}^{- 1} \right) \) (4.5)
которое затем используется для вычисления временной производной поля \( \phi_{c} \) в центре ячейки:
\( \delta t_{cCo}^{- 1}\left( \phi_{c}^{n} - \phi_{c}^{o} \right) \) (4.6)
Таким образом, используя локально вычисленное поле обратной величины временного шага \( {\delta t}^{- 1} \), временная производная вычисляется локально. Локальная оценка временной производной на основе локального числа Куранта позволяет применять более крупные временные шаги в тех частях расчётной области, где числа Куранта ниже. Тем самым скорость расчёта увеличивается (численное время искусственно идёт быстрее в этих частях области, поскольку ожидается, что течение там испытывает меньшие изменения). Ограничение накладывается на основе локального числа Куранта, поскольку таким образом обеспечивается численная устойчивость решения.
4.3.1.1.2. Схема backward#
Или обратная разностная схема второго порядка (BDS2), использует значения поля с текущего и двух предыдущих временных шагов для сборки временной производной, сходящейся со вторым порядком. Производная вычисляется с помощью разложения в ряд Тейлора, начиная с текущего момента времени и уходя на два шага назад:
\( \phi^{o} = \phi(t - \delta t) = \phi(t) - \phi'(t)\delta t + \frac{1}{2}\phi''\delta t^{2} - \frac{1}{6}\phi'''\delta t^{3} + ... \) (4.7)
\( \phi^{oo} = \phi(t - 2\delta t) = \phi(t) - 2\phi'(t)\delta t + \frac{1}{2}\phi''4\delta t^{2} - \frac{1}{6}\phi'''8\delta t^{3} + ... \) (4.8)
Умножая уравнение (4.7) на 4 и вычитая из него уравнение (4.8), получаем временную дискретизацию BDS2 поля \( \phi_{c} \)в центре ячейки:
\( \phi'_{c} \approx \frac{\frac{3}{2}\phi_{c} - 2\phi_{c}^{o} + \frac{1}{2}\phi_{c}^{oo}}{\delta t} \) (4.9)
Вычисление производной с использованием старых значений выполняется в OpenFOAM без необходимости хранения старых значений полей и сетки в клиентском коде. Все объёмные и граневые поля имеют возможность автоматически хранить значения с предыдущего (o) и позапрошлого (oo) временных шагов. Сама сетка также хранит информацию, необходимую для временной дискретизации более высокого порядка (например, старые и позапрошлые поля объёмов ячеек). Схема backward вычисляет временную производную второго порядка, которая может быть вычислена явно, поскольку значения полей o и oo известны. Фактическая реализация учитывает возможную корректировку временного шага, в результате чего производная поля в центре ячейки принимает вид:
\( \phi'_{c} \approx \frac{c_{t}\phi_{c} - 2c_{t}^{o} + c_{t}^{oo}\phi_{c}^{oo}}{\delta t} \)(4.10)
где коэффициенты c определяются следующим образом:
\( c_{t} = 1 + \frac{\delta t}{\delta t + \delta t^{o}} \) (4.11)
\( c_{t}^{oo} = \frac{\delta t^{2}}{\delta t^{o}\left( \delta t + \delta_{t}^{o} \right)} \) (4.12)
\( c_{t}^{o} = c_{t} + c_{t_{oo}} \) (4.13)
В случае равенства двух последовательных временных шагов коэффициенты c соответствуют дискретизации с постоянным шагом по времени, сравните с уравнением (4.9).
4.3.1.2. gradSchemes#
gradSchemes определяют, какие схемы вычисления градиента используются для членов, заданных в решателе. На практике существует множество примеров, когда выбор градиентной схемы может привести к лучшему решению. Например, градиент используется для вычисления силы поверхностного натяжения в расчётах двухфазных течений, поэтому он играет важную роль в течениях, движимых поверхностным натяжением. Всякий раз, когда присутствуют крутые градиенты или применяется другая топология сетки (например, тетраэдральные сетки), градиентная схема, использующая более широкий шаблон ячеек, может дать лучшие решения.
Доступные градиентные схемы в OpenFOAM:
Gauss
cellLimited
cellMDLimited
edgeCellsLeastSquares
faceLimited
faceMDLimited
fourth
leastSquares
pointCellsLeastSquares
Три из этих схем выбраны и описаны ниже: Gauss, cellLimited и pointCellsLeastSquares.
4.3.1.2.1. Gauss#
Наиболее часто используемая схема дискретизации для градиента, дивергентного (конвективного) и лапласовского (диффузионного) членов. Она также описана в главе 2. Эта схема ожидает значения в центрах граней для вычисления градиента в центре ячейки.
4.3.1.2.2. cellLimited#
Расширяет функциональность стандартной градиентной схемы. Она вычисляет ограничитель (limiter) для значения градиента в центре ячейки, вычисленного стандартным способом, а затем масштабирует значение градиента с помощью этого ограничителя (0 < l ≤ 1). Ограничитель вычисляется с использованием максимального и минимального значений (\( \phi_{cmax},\phi_{cmin} \)) свойства \( \phi_{c} \) в центре ячейки, найденных путём косвенного поиска по ячейкам, соседним через грани:
\( \phi_{cmax} = \max_{C}\left( \phi_{c} \right) \) (4.14)
\( \phi_{cmin} = \min_{C}\left( \phi_{c} \right) \) (4.15)
где \( \phi \) — свойство в центре ячейки, а \( C \) — множество всех соседних по граням ячеек для ячейки \( c \). После того как найдены минимальное и максимальное значения в шаблоне ячеек, соединённых гранями, максимальное и минимальное значения используются для вычисления разностей с исходным значением \( \phi_{c} \) в центре ячейки:
\( \Delta\phi_{\max} = \phi_{cmax} - \phi_{c} \) (4.16)
\( \Delta\phi_{\min} = \phi_{cmin} - \phi_{c} \) (4.17)
Затем разности увеличиваются с помощью заданного пользователем коэффициента (0 < k < 1):
\( \Delta\phi_{\max} = \Delta\phi_{\max} + \left( \frac{1}{k} - 1 \right)\left( \Delta\phi_{\max} - \Delta\phi_{\min} \right) \) (4.18)
\( \Delta\phi_{\min} = \Delta\phi_{\min} - \left( \frac{1}{k} - 1 \right)\left( \Delta\phi_{\max} - \Delta\phi_{\min} \right) \) (4.19)
Обратите внимание, что разности не увеличиваются, если заданный пользователем коэффициент \( k \) равен 1. Уравнения в этом разделе опираются на связность ячейка-к-ячейке, и они также используют шаблоны на основе ячеек. Фактическая реализация использует адресацию «владелец-сосед» по причинам, описанным в главе 1.
Ограничитель l изначально равен 1, но по мере того, как он вычисляется в цикле по граням сетки с использованием h, его значение будет обновляться. Вот почему функции min и max сравнивают отношение разности свойства, заданной минимальным и максимальным значениями, с экстраполированной разностью, заданной градиентом:
\( \Delta\left( \phi_{c} \right)_{grad} = \nabla(\phi)_{c}cf \) (4.20)
где \( cf \) — вектор, соединяющий центр ячейки и центр рассматриваемой грани. Увеличенные разности в сравнении с минимальным/максимальным значениями затем используются для вычисления ограничителя (\( l \)):
\( l = \left\{ \begin{array}{r} \min\left( l,\frac{\Delta\phi_{\max}}{\Delta\left( \phi_{c} \right)_{grad}} \right):\Delta\phi_{\max} < \Delta\left( \phi_{c} \right)_{grad} \\ \min\left( l,\frac{\Delta\left( \phi_{c} \right)_{grad}}{\Delta\phi_{\min}} \right):\Delta\phi_{\min} > \Delta\left( \phi_{c} \right)_{grad} \end{array} \right.\ \) (4.21)
При определении окончательного градиента в центре ячейки градиент, вычисленный стандартной схемой, масштабируется ограничителем:
\( \nabla(\phi)_{c} = \nabla(\phi)_{c} \cdot l \) (4.22)
4.3.1.2.3. pointCellsLeastSquares#
Предоставляет более широкий шаблон для вычисления градиента. Он включает соседние ячейки, примыкающие к рассматриваемой ячейке не только через грани, но и через точки. На неструктурированной гексаэдральной сетке такой шаблон содержал бы 33 ячейки. Хотя численные схемы, реализованные в OpenFOAM, сходятся со вторым порядком, при наличии резких скачков в расчётной области абсолютная точность становится ещё одним очень важным аспектом численной аппроксимации. Используя более широкий шаблон, эта схема даёт оценку градиента с меньшими абсолютными ошибками.
Если используется линейное разложение в ряд Тейлора для свойства φ вокруг центра ячейки c:
\( \phi(x) = \phi_{c} - \nabla(\phi)_{c} \cdot \left( x - x_{c} \right) + O\left( \left\| {x - x_{c}}^{2} \right\| \right) \) (4.23)
для вычисления трёх неизвестных переменных — компонент градиента \( \nabla(\phi)_{c} \) — необходимы три значения. Метод наименьших квадратов для градиента включает разложение ряда Тейлора (уравнение (4.23)) от центра ячейки, где вычисляется градиент, к соседним ячейкам. Количество разложений прямо пропорционально размеру шаблона ячеек. Для двумерных треугольных сеток градиент может быть вычислен непосредственно по трём окружающим ячейкам из шаблона соседей по граням. Однако включение большего числа ячеек в шаблон повышает абсолютную точность градиента.
Когда известно более трёх значений в точках, система становится переопределённой. Следовательно, градиент вычисляется с использованием минимизации квадратичной ошибки градиента, определяемой как:
\( E = \sum_{cc}^{}w_{cc}^{2}E_{cc}^{2} \) (4.24)
где \( cc \) — ячейки шаблона, \( w_{cc} \) — весовой коэффициент, связывающий рассматриваемую ячейку и ячейку шаблона. Обычно в качестве веса берётся обратное расстояние между двумя ячейками, а \( E²_{cc} \) — квадрат ошибки разложения Тейлора от ячейки, для которой вычисляется градиент, к ячейке шаблона:
\( E_{cc} = \frac{1}{2}\nabla\nabla(\phi)_{c}:(\Delta x\Delta x) \) (4.25)
После некоторых алгебраических преобразований минимизация квадратичной ошибки приводит к линейной алгебраической системе для компонент градиента. Линейная алгебраическая система размером 3×3 собирается и решается для каждой ячейки. Более того, решение получается прямым обращением матрицы коэффициентов для каждой ячейки, поскольку матрица коэффициентов будет симметричным тензором.
 Рисунок 4.3: Сравнение градиента поля объёмной
доли (круговое распределение).
В качестве мотивации для использования этой градиентной схемы рассмотрим рисунок 4.2.4, где градиент поля объёмной доли вычислен с использованием стандартной схемы Gauss linear и новой градиентной схемы pointCellsLeastSquares. Поле объёмной доли задано в виде круга радиусом R = 2 см с центром в области 6 × 6 см, дискретизированной сеткой 30 × 30 объёмов. pointCellsLeastSquares вычисляет более однородный градиент круглой капли по сравнению с Gauss linear, поскольку в вычислении градиента участвуют соседи по точкам. Вовлечение соседей по точкам повышает абсолютную точность для полей с резкими скачками. Градиент, вычисленный по Гауссу и показанный для примера поля на рисунке 4.2.4, является хрестоматийным примером сеточной анизотропии — расчёт сильно зависит от ориентации граней относительно координатных осей.
4.3.1.3. divSchemes#
divSchemes используются для дискретизации любого конвективного (дивергентного) члена в математической модели. Просмотр словаря system/fvSchemes кейса cavityOscillating показывает, что схемой пространственной дискретизации, наиболее часто встречающейся для дивергентных членов, является схема дискретизации Гаусса, использующая теорему Гаусса-Остроградского о дивергенции. Эта схема дискретизации представляет собой основу МКО, поскольку она создаёт систему алгебраических уравнений, что делает маловероятным её изменение в конфигурационном файле для неявных членов.
Дополнительно может быть предоставлена опция bounded для расчётов, включающих стационарные или частично сошедшиеся решения, где \( \nabla \cdot (U) = 0 \) не выполняется точно в ходе итераций алгоритма решения. В этом случае член \( \nabla \cdot (U) \) вычитается из матрицы коэффициентов для улучшения сходимости решения.
4.3.1.3.1. laplacianSchemes#
Лапласиан дискретизируется как Gauss <интерполяция> <snGradScheme>. Стандартная запись:
laplacianSchemes
{
default Gauss linear corrected;
}
Gauss — базовый метод дискретизации, linear — интерполяция, corrected — схема с коррекцией неортогональности.
4.3.1.3.2. interpolationSchemes#
Интерполяционные схемы определяют, как вычисляются значения на гранях. OpenFOAM предлагает множество вариантов: linear, cubic, downwind, blended, clippedLinear, CoBlended, biLinearFit, cubicUpwindFit и другие. Большинство ориентированы на конвективный член.
CDS (linear) даёт второй порядок точности, но склонен к осцилляциям на разрывах. UDS (upwind) монотонна, но имеет только первый порядок и сильно размазывает фронты. Компромиссные схемы (limitedLinear, linearUpwind, blended) сочетают точность CDS с устойчивостью UDS, вычисляя итоговое значение как комбинацию значений, полученных разными схемами.
4.3.2. Управление решателем (fvSolution)#
Дискретизация математической модели приводит к системе линейных алгебраических уравнений вида \( Ax = b \). Параметры решения этой системы и алгоритма связывания давления со скоростью задаются в system/fvSolution. Содержимое этого файла зависит от используемого решателя.
Для кейса cavity решателя icoFoam словарь fvSolution выглядит так:
solvers
{
p
{
solver PCG;
preconditioner DIC;
tolerance 1e-06;
relTol 0;
}
U
{
solver PBiCG;
preconditioner DILU;
tolerance 1e-05;
relTol 0;
}
}
PISO
{
nCorrectors 2;
nNonOrthogonalCorrectors 0;
pRefCell 0;
pRefValue 0;
}
Словарь содержит два основных подраздела: solvers и PISO.
Важно различать матричные решатели (linear solvers) и приложения-решатели (solver applications). Приложения-решатели — это программы, запускаемые пользователем для моделирования (icoFoam, interFoam, simpleFoam). Матричные решатели — алгоритмы, используемые внутри приложения-решателя для решения СЛАУ на каждом шаге.
4.3.2.1. Линейные решатели#
В примере выше для давления используется PCG (Preconditioned Conjugate Gradient) с предобусловливателем DIC (Diagonal-based Incomplete Cholesky) — для симметричных матриц. Для скорости — PBiCG (Preconditioned Bi-Conjugate Gradient) с DILU (Diagonal-based Incomplete LU) — для асимметричных.
Параметры линейных решателей:
tolerance — абсолютная невязка, при которой решатель останавливается. Если изменение от итерации к итерации становится меньше этого порога, процесс считается сошедшимся.
relTol — относительная невязка. Значение, отличное от 0, переопределяет tolerance. relTol 0.01 означает остановку при снижении невязки на два порядка (до 1% от начальной).
maxIter — опциональный параметр (по умолчанию 1000). Максимальное число итераций, после которого решатель останавливается принудительно.
Для стационарных задач tolerance должен быть достаточно малым (1e-8…1e-10) для точного решения. Для нестационарных задач стационарного решения не существует, поэтому tolerance можно задавать менее строгим..
4.3.2.2. Связывание давления и скорости (PISO)##
В зависимости от решателя реализован тот или иной алгоритм связывания давления и скорости. Решатель пытается прочитать соответствующий подсловарь в fvSolution.
nCorrectors — число коррекций давления внутри одного шага по времени (обычно 2).
nNonOrthogonalCorrectors — число циклов коррекции неортогональности. Необходимо при использовании тетраэдральных сеток или локального динамического измельчения гексаэдральных сеток. Коррекция явная, поэтому применяется несколько раз — каждое применение уменьшает ошибку, но не устраняет её полностью.
pRefPoint / pRefCell — точка или ячейка для фиксации опорного давления. pRefPoint принимает вектор в системе координат сетки, pRefCell — метку ячейки. Обязательны, если давление не закреплено граничными условиями. Для многофазных течений опорная точка всегда должна быть покрыта одной из фаз и не меняться.
pRefValue — значение опорного давления (обычно 0).
Другие алгоритмы (SIMPLE, PIMPLE) требуют собственных подсловарей с дополнительными параметрами. Чем сложнее решатель, тем больше опций обычно требуется в fvSolution. Туториалы к решателям, как правило, содержат достаточно информации для настройки кейса.
4.4. Запуск решателя и управление расчётом#
Запустить решатель так же просто, как выполнить любую другую команду в Linux: достаточно набрать имя команды и нажать Enter. Как общее правило, решатели и любые другие утилиты OpenFOAM следует запускать непосредственно внутри каталога кейса. Для запуска решателя из другого каталога необходимо передать параметр -case, за которым следует путь к кейсу.
Для кейса cavity, моделируемого решателем icoFoam, команда выглядит так:
icoFoamВ зависимости от размера сетки, временного шага и общего времени, которое необходимо промоделировать, эта команда занимает значительно больше времени, чем обычные команды ls или cp. Кроме того, информация, выводимая в терминал, огромна и теряется, как только терминал закрывается. Поэтому синтаксис запуска решателя следует расширить:
nohup icoFoam > log &
tail -f log
Команда nohup предписывает оболочке продолжать выполнение задания, даже если окно терминала закрыто или пользователь вышел из системы. Вместо вывода всего на экран результат перенаправляется в файл с именем log, а задание переводится в фоновый режим. Поскольку задание выполняется в фоне, а весь вывод направляется в файл log, команда tail используется для отображения последних строк файла на экране. С флагом -f вывод обновляется до тех пор, пока команда не будет прервана пользователем.
Другой способ оставаться в курсе выполняющегося задания — использовать pyFoamPlotWatcher, который разбирает любой лог-файл и создаёт на его основе окна gnuplot. Эти окна обновляются автоматически и включают графики невязок, что удобно для мониторинга расчёта.
Вместо ручного запуска решателя в фоновом режиме с перенаправлением вывода в лог-файл можно также использовать скрипт foamJob:
foamJob icoFoamСкрипт foamJob довольно мощный, поскольку предоставляет комплексное решение для запуска заданий OpenFOAM. Некоторые возможности foamJob рассматриваются в следующем разделе.
4.4.1. Настройка controlDict#
Каждый кейс должен содержать файл system/controlDict, который определяет все данные, связанные со временем выполнения. Включая время остановки решателя, ширину временного шага, интервал и способ записи данных временных шагов в каталог кейса. Содержимое этого словаря автоматически перечитывается во время выполнения решателя и, следовательно, позволяет вносить изменения, пока расчёт ещё выполняется.
Руководство пользователя OpenFOAM [11] содержит общее введение в параметры и их комбинации, поэтому эта информация здесь не повторяется. Два параметра объясняются здесь более подробно, поскольку на них ссылаются в остальной части книги.
4.4.1.1. WriteControl#
Указывает, когда данные записываются на диск. Наиболее популярные варианты: timeStep, runTime или adjustableRunTime. Фактический интервал определяется параметром writeInterval, который принимает только скалярные значения. Для простоты этот интервал далее обозначается как n. Если выбран timeStep, каждый n-й временной шаг записывается на диск. Выбор runTime записывает данные каждую n-ю секунду в каталог кейса. Последний часто используемый вариант — adjustableRunTime, который записывает данные каждую n-ю секунду на диск, но подстраивает временной шаг так, чтобы этот интервал был точно соблюдён. Благодаря этому в папке кейса появляются только «красиво» названные временные каталоги.
При настройках по умолчанию объём данных, записываемых на диск, не ограничивается OpenFOAM. Особенно в случаях, когда много пользователей используют одно и то же хранилище и расчёты идут долго, это мгновенно заполняет диски.
4.4.1.2. purgeWrite#
Может использоваться для обхода вышеупомянутой проблемы чрезмерного использования дискового пространства. По умолчанию он равен 0 и не ограничивает количество записываемых на диск временных срезов. Изменение этого значения на 2 предписывает OpenFOAM хранить на диске только 2 последних временных среза и удалять остальные при каждой записи данных на диск. Эта опция не может использоваться, если writeControl установлен в adjustableRunTime.
В дополнение к этим стандартным параметрам controlDict также содержит пользовательские библиотеки, которые подключаются к решателям во время выполнения, а также вызовы функциональных объектов. Функциональные объекты рассматриваются в Томе 2, посвященному програмированию в среде OpenFOAM.
4.4.2. Декомпозиция и параллельное выполнение#
В далеком прошлом все решатели запускались на одном процессоре. Структура CFD-алгоритмов делает их пригодными для параллелизма данных: расчётная область делится на несколько частей, и одна и та же задача выполняется параллельно на каждой части расчётной области. Каждый процесс обменивается данными со своими соседями. С современными многоядерными архитектурами и кластерами HPC распределение рабочей нагрузки по нескольким вычислительным блокам обычно приводит к ускорению выполнения по времени.
Декомпозиция расчётной области никогда не должна влиять на численные свойства метода: согласованность, ограниченность, устойчивость и консервативность. В OpenFOAM параллелизм данных достигается очень элегантным способом и тесно связан с лежащим в основе МКО. По сути, граничная грань, которая использовалась для пояснения дискретизации уравнений в главе 2, вполне могла бы быть гранью границы процесса (процессора).
Прежде чем расчёт может быть выполнен параллельно, расчётная область должна быть разделена на столько подобластей, сколько процессов используется для расчёта.
В качестве примера параллельного выполнения расчётный кейс cavity решателя icoFoam распределяется по четырем ядрам машины, на которой запущено задание. Это подразумевает, что машина имеет как минимум4 ядра, иначе расчёт займёт значительно больше времени, чем последовательный запуск.
Взаимодействие между межпроцессным обменом (IPC) и МКО на неструктурированных сетках в OpenFOAM обрабатывается автоматически для дискретных дифференциальных операторов; его детали относительно сложны и выходят за рамки этой книги.
Папка $FOAM_RUN может использоваться для запуска расчётов OpenFOAM в домашней папке, если её нет, то необходимо создать, далее копируем кейс и генерируем сетку.
mkdir -p $FOAM_RUN
cd $FOAM_RUN
cp -r $FOAM_TUTORIALS/legacy/incompressible/icoFoam/cavity cavityParallel
cd cavityParallel/cayity
blockMesh
В OpenFOAM существуют различные методы декомпозиции области. В этом туториале используется декомпозиция scotch. Конфигурация декомпозиции области хранится в файле словаря system/decomposeParDict. Найти доступные decomposeParDict и подобные файлы внутри туториалов OpenFOAM можно с помощью find. Далее копируем его.
cp $(find $FOAM_TUTORIALS -name "decomposeParDict" | head -1) system/Наиболее важные строки decomposeParDict:
nano system/decomposeParDict
numberOfSubdomains 4;
method sсotch;
Первая строка определяет, сколько подобластей (или MPI-процессов) будет использоваться, а вторая выбирает метод декомпозиции области. Использование метода simple — в целом плохой выбор для реальных задач, поскольку он делит область на пространственно равные части. Это происходит без минимизации размера границ межпроцессного обмена между подобластями. Если рассмотреть сетку, очень плотную с одной стороны и очень грубую с другой, метод simple разрезал бы её пополам, создав подобласти с очень неравномерным распределением конечных объёмов. Сетка с большим числом конечных объёмов требует больше вычислительных ресурсов, что делает расчёт несбалансированным. Увеличенное время межпроцессного обмена, вызванное неоправданно большими границами межпроцессного обмена, может серьёзно снизить эффективность параллельного выполнения.
Для оптимизации существуют различные автоматические методы декомпозиции, которые, например, оптимизируют процессорные границы для достижения минимальных накладных расходов на межпроцессный обмен. Изменив строки в system/decomposeParDict следующим образом, мы обеспечиваем декомпозицию области на две подобласти с использованием метода scotch.После генерации сетки выполняется декомпозиция области с помощью decomposePar:
decomposeParВ каталоге кейса создаются четыре новых каталога: processor0 и processor1….. Каждый из них содержит подобласть, включая сетку (в каталоге processor*/polyMesh) и поля (в каталоге processor*/0).
Фактическая команда для запуска расчёта в параллельном режиме немного длиннее, чем последовательная, поскольку для этого необходимо использовать MPI:
mpirun -np 4 icoFoam -parallel > log &
tail -f log
Это вызывает mpirun с 4 подпроцессами для запуска icoFoam параллельно и сохраняет вывод в log для последующего анализа. Параметр -parallel у mpirun действительно важен, поскольку он предписывает mpirun запускать каждый процесс со своей конкретной подобластью. Если бы этот параметр отсутствовал, запустились бы 4 процесса, но оба использовали бы всю область, что не только избыточно, но и является пустой тратой вычислительных ресурсов.
Когда расчёт завершён, подобласти могут быть восстановлены в одну единую область. Для этого используется инструмент reconstructPar, который — по умолчанию — берёт все временные срезы из каждого процессорного каталога и восстанавливает их. Можно выбрать только последний временной шаг, если вызвать reconstructPar с необязательным аргументом -latestTime. Он предписывает reconstructPar восстановить только последний временной срез. Это удобно, когда сетка довольно велика и восстановление занимает много времени и дискового пространства.
reconstructPar -latestTimeВосстановление подобластей процессов не является обязательным, поскольку ParaView может визуализировать декомпозированные кейсы OpenFOAM.
Хотя можно наблюдать хорошее масштабирование времени выполнения с увеличением числа процессоров, обычно не рекомендуется опускаться ниже определённого отношения общего числа ячеек к числу подобластей. Процессы замедляют сами себя, и узким местом тогда становится не доступная процессорная мощность, а обмен данными между процессами.
Выполнение расчёта в параллельном режиме даёт ускорение s, задаваемое как:
\( s = \frac{t_{s}}{t_{p}} \) (4.26)
где \( t_{s} \) и \( t_{p} \) — время последовательного и параллельного выполнения соответственно. Линейное (идеальное) ускорение равно числу используемых процессов \( N_{p} \). Обычно из-за межпроцессного обмена или узких мест, локальных для подобласти (упомянутые выше локальные вычисления), ускорение будет иметь значение меньше, чем число процессов: \( s < N_{p} \). При расчётах с более крупными сетками разница между \( N_{p} \) и оценённым s будет больше. Может, однако, случиться, что наблюдается сверхлинейное ускорение, когда \( s > N_{} \)p: причина этого обычно специфична для алгоритма и архитектуры, на которой выполняется расчёт.
4.4.3. Комментарии инженера к главе 4.3#
4.4.3.1. Зачем инженеру залезать в fvSchemes#
Большинство пользователей OpenFOAM годами не трогают fvSchemes, используя настройки из туториалов. Но когда расчёт расходится, даёт нефизичные осцилляции или считается неприемлемо долго — первым делом смотрят именно сюда. Замена одной строки в divSchemes может превратить «разваливающийся» расчёт в устойчивый. Базовое понимание схем — это как знание режимов сварки: можно варить на автомате, но когда шов трещит, нужно понимать, какой параметр крутить.
4.4.3.2. Алгоритмы связывания давления и скорости: PISO, SIMPLE и PIMPLE#
Уравнения Навье-Стокса для несжимаемой жидкости связывают скорость и давление, но давление не имеет собственного уравнения — оно определяется через условие неразрывности (\( \nabla \cdot U = 0 \)).
\( \frac{\partial U}{\partial t} + \nabla \cdot (U \otimes U) = - \frac{1}{\rho}\nabla p + \nabla \cdot (\nu\nabla U) + g \)Численное решение этой связанной системы требует специальных алгоритмов. В OpenFOAM таких алгоритмов три: SIMPLE, PISO и PIMPLE. Все они решают одну и ту же физическую задачу, но различаются по способу организации итераций.
4.4.3.2.1. SIMPLE (Semi-Implicit Method for Pressure-Linked Equations)#
Исторически первый алгоритм, разработанный в 1970-х годах для стационарных задач. Его идея: сделать предположение о поле давления, решить уравнение импульса, вычислить поправку давления из уравнения неразрывности, скорректировать скорость и давление, повторить до сходимости. В SIMPLE поправка давления вычисляется с заниженным коэффициентом (релаксацией), чтобы избежать расходимости. Это делает алгоритм устойчивым, но медленным — требуется много итераций для достижения сходимости. SIMPLE используется в решателе simpleFoam и подходит для задач, где установившееся решение существует и переходный процесс не важен.
4.4.3.2.2. PISO (Pressure-Implicit with Splitting of Operators)#
Алгоритм для нестационарных задач. В отличие от SIMPLE, он не требует внешних итераций по нелинейности на каждом временном шаге. Вместо этого после решения уравнения импульса выполняется несколько коррекций давления (обычно две), и поправка не релаксируется. PISO работает быстрее SIMPLE на одном временном шаге и обеспечивает лучшее соблюдение неразрывности. Он используется в icoFoam (ламинарные течения) и pisoFoam. Алгоритм хорош для задач с малым числом Куранта (Co < 1), где течение заметно меняется от шага к шагу.
4.4.3.2.3. PIMPLE (PISO + SIMPLE)#
Гибрид, объединяющий идеи обоих алгоритмов. Внутри одного временного шага выполняется несколько внешних итераций (как в SIMPLE), и на каждой внешней итерации — несколько коррекций давления (как в PISO). Это позволяет использовать крупные временные шаги (Co > 1) без потери устойчивости. PIMPLE реализован в решателе pimpleFoam и является стандартным выбором для большинства промышленных нестационарных задач. Дополнительные внешние итерации увеличивают время счёта на один шаг, но позволяют увеличить сам шаг, что в сумме часто даёт выигрыш.
Выбор алгоритма диктуется физикой задачи и соответствено решателем.Решатель пытается прочитать соответствующий подсловарь в fvSolution. Для стационарного течения — SIMPLE. Для нестационарного с малым шагом по времени — PISO. Для нестационарного с крупным шагом, задач с межфазными границами, динамическими сетками или сильной нелинейностью — PIMPLE. Смена алгоритма в OpenFOAM — это не просто замена решателя в controlDict, но и соответствующая структура словаря fvSolution: для SIMPLE задаются коэффициенты релаксации (relaxationFactors), для PISO — число коррекций (nCorrectors), для PIMPLE — и внешние итерации (nOuterCorrectors), и внутренние коррекции (nCorrectors).
На практике инженер редко меняет алгоритм — он выбирает решатель, в котором алгоритм уже заложен. Но понимание различий помогает при диагностике: если simpleFoam расходится — увеличьте релаксацию давления; если pisoFoam нарушает неразрывность — добавьте коррекций (nCorrectors 3); если pimpleFoam считает медленно — уменьшите nOuterCorrectors и увеличьте шаг по времени
4.4.3.3. fvm vs fvc — главное, что нужно запомнить#
В коде решателей вы видите fvm:: и fvc::. Это не прихоть программистов, а фундаментальное разделение. fvm — неявные члены: они попадают в матрицу СЛАУ и влияют на устойчивость. fvc — явные: они вычисляются по известным значениям и уходят в правую часть. Если вы в fvSchemes выбрали схему для div(phi,U), она будет применяться к обоим пространствам имён. На практике это означает, что одна и та же строка в fvSchemes управляет и матрицей, и правой частью.
4.4.3.4. Число Куранта (Courant number, Co)#
Безразмерная величина, показывающая, сколько ячеек сетки проходит жидкость за один временной шаг. Названа в честь немецкого математика Рихарда Куранта.
\( Co = \frac{\left( |U| \times \Delta t \right)}{\Delta x} \) где: \( \Delta x \)\( |U| \) - скорость жидкости в данной точке,
\( \Delta t \) — временной шаг, — размер ячейки в направлении потока.
Если Co = 0.5, жидкость за один шаг проходит половину ячейки. Если Co = 2, жидкость проходит две ячейки — и численная схема может «перепрыгнуть» важные изменения в потоке.
4.4.3.4.1. Зачем оно нужно#
Устойчивость явных схем требует Co ≤ 1 (условие Куранта-Фридрихса-Леви). Неявные схемы в OpenFOAM (Euler, backward) формально устойчивы при любых Co, но точность падает с ростом числа. Практические рекомендации:
PISO (icoFoam, pisoFoam): Co < 1. При превышении — осцилляции, потеря точности. PIMPLE (pimpleFoam): допускает Co = 2–5 за счёт внешних итераций. Для межфазных границ (interFoam) держите Co < 0.5 в области интерфейса. SIMPLE (simpleFoam): число Куранта не используется (стационарный расчёт), но есть аналог — число Куранта для локального шага по времени.
4.4.3.4.2. Как проверить в OpenFOAM#
После расчёта в логе есть строка:
Courant Number mean: 0.15 max: 0.85Смотрите на max. Если max > 1 для PISO или max > 5 для PIMPLE — уменьшайте deltaT в system/controlDict или измельчайте сетку в быстрых областях.
4.4.3.4.3. Инженерный смысл#
Число Куранта — это «скорость съёмки» вашего расчёта. Если камера снимает слишком редко (Co > 1), быстро движущийся объект размазывается или исчезает. Если слишком часто (Co << 0.1) — вы тратите вычислительные ресурсы на избыточные кадры. Оптимальный диапазон для большинства задач: Co_mean = 0.1–0.5, Co_max < 1.
4.4.3.5. Линейные решатели: PCG, PBiCG, GAMG — что выбрать#
В 2026 году стандарт для давления — PCG с DIC (до 10⁶ ячеек) или GAMG с FDIC (для больших сеток). GAMG (Generalised Algebraic Multi-Grid) — это «турбо-режим» для давления: он сходится в разы быстрее на мелких сетках, но требует больше памяти. Для скорости по-прежнему хорош PBiCGStab с DILU — он устойчивее классического PBiCG. Если расчёт зависает на решении давления — попробуйте GAMG. Если выдаёт ошибки — вернитесь на PCG.
4.4.3.6. Что такое VOF и почему для него важен градиент#
VOF (Volume of Fluid) — это метод, используемый в interFoam для моделирования двухфазных течений (вода-воздух, масло-вода). Он вводит поле alpha.water — объёмную долю воды: 1 — чистая вода, 0 — чистый воздух, 0.5 — межфазная граница. Градиент этого поля нужен для вычисления кривизны поверхности и силы поверхностного натяжения. Если градиент вычислен криво (например, Gauss linear даёт «рваные» значения), сила поверхностного натяжения будет осциллировать, и капля развалится. Именно для таких задач рекомендуется pointCellsLeastSquares — он сглаживает градиент и делает межфазную границу физичной.
4.4.3.7. ddtSchemes: когда менять Euler на backward#
Euler — рабочая лошадка: первый порядок, безусловно устойчив, прощает крупные шаги. backward (BDS2) — второй порядок, точнее, но требует хранения двух предыдущих шагов (больше памяти) и может осциллировать на резких переходах. Практическое правило: для стационарных задач и первых тестов — Euler. Для вихревых течений, акустики, DNS/LES — backward. Для межфазных границ — CrankNicolson 0.7–0.9 (компромисс точности и устойчивости).
4.4.3.8. cellLimited: когда и зачем#
Ограничитель градиента — это «предохранитель» от нефизичных осцилляций. Если в поле есть резкий скачок (ударная волна, межфазная граница), стандартный градиент может выдать значение, превышающее разницу между соседними ячейками. cellLimited масштабирует градиент так, чтобы он не выходил за пределы, заданные соседями. Коэффициент k управляет строгостью ограничения: k = 1 — без ограничения, k = 0.5 — жёстко. На практике начните с cellLimited Gauss linear 1, и если осцилляции есть — уменьшайте k до 0.5.
4.4.3.9. Параллельный запуск: главные ошибки новичков#
Забыли decomposePar перед mpirun.
Указали numberOfSubdomains не совпадающим с -np.
Использовали method simple вместо scotch на неравномерной сетке — половина ядер будет простаивать.
Запустили mpirun без -parallel — каждый процесс считает всю область целиком.
Не сделали reconstructPar перед ParaView — увидите только кусок области.
4.4.3.10. Ускорение: почему на малых сетках параллельность не работает#
Формула \( s = \frac{t_{s}}{t_{p}} \) красива, но на сетке в 400 ячеек вы не увидите ускорения от 4 ядер. Причина: время передачи данных между ядрами сравнимо со временем счёта. Порог рентабельности — примерно 50 000 ячеек на ядро. Меньше — накладные расходы на MPI съедают весь выигрыш. Поэтому для теста MPI используют любую сетку (лишь бы запустилась), а для реальных расчётов — крупные сетки.
4.4.3.11. foamJob и pyFoamPlotWatcher — инструменты мониторинга#
foamJob — это скрипт-обёртка, который запускает решатель в фоне и пишет лог. pyFoamPlotWatcher в реальном времени строит графики невязок из лога. В 2026 году оба живы, но pyFoam требует установленного Python и gnuplot. Если лень настраивать — tail -f log всё ещё работает безотказно.
4.4.3.12. Что изменилось в controlDict к 2026 году#
Параметр writeControl с опциями timeStep, runTime, adjustableRunTime не изменился. purgeWrite стал обязательным к настройке в крупных проектах — диски забиваются быстрее, чем в 2014 году (сетки стали больше). Добавился параметр writeFormat binary — бинарная запись полей, которая экономит место и ускоряет ввод-вывод. Для архивации результатов используйте purgeWrite 2 — храните только два последних временных среза, остальное удаляется автоматически.
5. Параллельные вычисления в OpenFOAM в 2026 году.#
5.1. Сетевые возможности и накладные расходы#
OpenFOAM использует декомпозицию расчётной области: сетка разрезается на подобласти, каждая считается независимо, а на границах подобластей процессы обмениваются данными через MPI. Пока вся работа происходит внутри одной машины, обмен идёт через оперативную память — накладные расходы минимальны. Но как только расчёт выходит за пределы одного корпуса, между процессорами появляется сеть, и именно она становится узким местом.
Накладные расходы на передачу данных определяются двумя величинами: пропускной способностью и задержкой. Пропускная способность — сколько мегабайт можно «прокачать» за секунду. Задержка — сколько микросекунд проходит между отправкой запроса и получением ответа. В CFD важнее задержка. Процессы обмениваются данными на каждом временном шаге, и даже при скромных объёмах передаваемых данных тысячи таких обменов умножаются на микросекунды ожидания. Процессор, который мог бы считать, простаивает в ожидании сети.
Эмпирический порог рентабельности — 50–100 тысяч ячеек на ядро. Если ячеек меньше, время счёта на ядре сопоставимо со временем ожидания данных от соседа, и добавление ядер не ускоряет, а иногда и замедляет расчёт. Поэтому выбор сети — это не вопрос «что лучше», а вопрос «какая сеть соответствует размеру моей задачи».
5.2. Возможные сетевые технологии для построения вычислительного кластера OpenFOAM в 2026 году#
Выбор сетевой архитектуры — это инженерный компромисс. Одна мощная машина с 64 ядрами посчитает быстрее, чем четыре слабых, соединённых гигабитом. Две машины на 10G — разумный минимум для не большой лаборатории. InfiniBand покупают, когда время расчёта начинает измеряться сутками, и каждый процент ускорения оправдывает затраты на оборудование. Обычно начиняют с одной машины. Когда её перестанет хватать — добавляют вторую по 10G. Когда и этого станет мало — вы уже будете знать, сколько ячеек на ядро вам нужно, и выбор между InfiniBand и более крупным сервером станет очевидным.
5.2.0.0.1. Обычный гигабитный Ethernet (1G, ~120 МБ/с, задержка 50–100 мкс)#
Это то, что уже встроено в любой компьютер. Для параллельных расчётов он годится только на крупных сетках (от 200 тысяч ячеек на ядро) и при небольшом числе машин — две, максимум четыре. Дальше сеть захлёбывается.
5.2.0.0.2. Десятигигабитный Ethernet (10G, ~1.2 ГБ/с, задержка 10–50 мкс)#
Первый реально рабочий вариант для небольшого кластера. Две машины можно соединить напрямую, без коммутатора, двумя недорогими сетевыми картами и одним кабелем. Для 4–8 машин добавляется коммутатор. На 10G уверенно считаются задачи с сотней тысяч ячеек на ядро и более.
5.2.0.0.3. InfiniBand#
Это специализированная сеть для параллельных вычислений. Её ключевое преимущество — задержка в 1–2 микросекунды, на порядок ниже, чем у Ethernet. Это позволяет эффективно масштабировать расчёт на десятки и сотни машин, не теряя производительности на коммуникациях. Внутри одного сервера InfiniBand не нужен, для двух машин он опционален, а для кластера из 8+ узлов — практически обязателен, если вы хотите получить линейное ускорение.
5.2.0.0.4. Уровни параллельности#
| Вариант | Сеть | Оборудование | Машин | Ядер (макс.) | Задержка | Ячеек на ядро (мин.) |
|---|---|---|---|---|---|---|
| 1. Одна машина (общая память) | Нет | Обычный ПК/сервер | 1 | 4–256 | 0 | 10 000 |
| 2. Две машины, 1G Ethernet | 1G Ethernet | Встроенные сетевые карты | 2 | 8–128 | 50–100 мкс | 200 000 |
| 3. Две машины, 10G Ethernet (прямое) | 10G Ethernet | 2 сетевые карты 10G + кабель DAC | 2 | 8–128 | 10–50 мкс | 100 000 |
| 4. Кластер, 10G Ethernet + коммутатор | 10G Ethernet | Карты 10G в каждой машине + коммутатор | 4–16 | 16–1024 | 10–50 мкс | 100 000 |
| 5. Две машины, InfiniBand (прямое) | IB QDR/EDR | 2 карты IB + кабель DAC | 2 | 8–256 | 1–2 мкс | 30 000 |
| 6. Кластер, InfiniBand + коммутатор | IB EDR/HDR | Карты IB в каждой машине + IB-коммутатор | 4–100+ | 32–тысячи | 1–2 мкс | 30 000 |
Оценка требуемой памяти — первый шаг перед запуском параллельного расчёта. Если памяти не хватит, задача не запустится вовсе или упадёт с ошибкой на середине. Для OpenFOAM эмпирическое правило таково: на один миллион ячеек требуется от 1 до 8 гигабайт оперативной памяти, в зависимости от сложности задачи.
5.3.0.0.1. Для стационарного несжимаемого течения#
SimpleFoam (одна фаза, без турбулентности) расход памяти минимален: порядка 1 ГБ на миллион ячеек. Турбулентная модель (k-epsilon, k-omega SST) добавляет два-три дополнительных скалярных поля и увеличивает потребление до 1.5–2 ГБ на миллион ячеек.
5.3.0.0.2. Нестационарные расчёты#
pimpleFoam, pisoFoam требуют хранения полей на нескольких временных слоях. Если используется схема второго порядка (backward), хранятся значения с текущего, предыдущего и позапрошлого шагов — потребление памяти вырастает в 2–2.5 раза по сравнению со стационарным случаем.
5.3.0.0.3. Многофазные течения#
interFoam, multiphaseEulerFoam добавляют поле объёмной доли фазы (alpha.water) и связанные с ним поля (кривизна, поверхностное натяжение). Расход памяти достигает 2–4 ГБ на миллион ячеек.
5.3.0.0.4. Сопряжённый теплообмен#
chtMultiRegionFoam требует хранения полей и для жидкости, и для твёрдого тела. Суммарный расход памяти пропорционален общему числу ячеек во всех областях, а не только в жидкости.
5.3.0.0.5. Сжимаемые течения с химическими реакциями#
Добавляют поля температуры, плотности, концентраций компонентов. Каждое дополнительное скалярное поле — это примерно 8 байт на ячейку. Десяток полей концентраций на миллион ячеек — это плюс 80 МБ, что не критично, но в сумме с остальным даёт 3–4 ГБ на миллион.
5.3.0.0.6. Динамические сетки#
Требуют хранения геометрии сетки на каждом временном шаге. Если сетка сохраняется часто, расход дискового пространства многократно возрастает, а оперативная память расходуется на буферы для перестроения сетки.
Ниже приведены усреднённые цифры для планирования:
| Тип задачи | Решатель | Память на 1 млн ячеек |
|---|---|---|
| Ламинарное стационарное | simpleFoam | ~1 ГБ |
| Турбулентное стационарное | simpleFoam + RANS | 1.5–2 ГБ |
| Турбулентное нестационарное | pimpleFoam + RANS | 3–5 ГБ |
| Двухфазное VOF | interFoam | 2–4 ГБ |
| Многофазное дисперсное | multiphaseEulerFoam | 3–5 ГБ |
| Сопряжённый теплообмен | chtMultiRegionFoam | 2–4 ГБ на млн (суммарно) |
| DNS (ламинарное/слаботурбулентное) | pimpleFoam | 5–8 ГБ |
Практический совет. Не закладывайте память «впритык». Оставьте запас в 20–30% на вспомогательные структуры, буферы MPI и пиковые нагрузки при сборке матрицы. Если ваша машина имеет 64 ГБ, безопасный максимум — 40–45 миллионов ячеек для стационарной задачи и 15–20 миллионов для нестационарной двухфазной. Всё, что крупнее — либо увеличивайте память, либо готовьте кластер.
5.4. Задачи, требующие кластерных вычислений#
Не каждая CFD-задача требует кластера. Стационарное обтекание профиля крыла в 2D или течение в прямой трубе считаются на ноутбуке за минуты. Но есть класс задач, где размер сетки и требуемое время расчёта делают одиночную машину бесполезной.
Прямое численное моделирование турбулентности (DNS). В DNS сетка разрешает все вихри вплоть до колмогоровского масштаба. Для течения в плоском канале при умеренном числе Рейнольдса требуется порядка 10⁸–10⁹ ячеек. На одном сервере с 64 ядрами такой расчёт занял бы месяцы. На кластере из 32 машин с InfiniBand задача решается за дни.
Моделирование крупных вихрей (LES) промышленных объектов. Обтекание целого автомобиля, самолёта или ветряной турбины с разрешением пристеночных слоёв требует сеток порядка 10⁸–10⁹ ячеек. Одна машина с 256 ГБ оперативной памяти просто не вместит такую сетку. Декомпозиция на десятки узлов кластера распределяет и память, и вычисления.
Аэроакустика. Расчёт шума винта, струи или выхлопной системы требует не только мелкой сетки в ближнем поле, но и распространения акустических волн на большие расстояния. Сетки — сотни миллионов ячеек. Временной шаг диктуется скоростью звука, а не скоростью потока, поэтому число шагов огромно. Без кластера такие задачи не решаются.
Многофазные течения с разрешением межфазной границы. Моделирование распыла топлива в камере сгорания, захлёбывания трубопровода или эмульгирования в смесителе требует очень мелкой сетки в области контакта фаз. При дроблении капель число ячеек растёт экспоненциально. Задачи с адаптивным измельчением сетки (AMR) легко выходят за пределы возможностей одной машины.
Сопряжённый теплообмен в сложных конструкциях. Одновременный расчёт течения и теплопроводности в твёрдом теле (например, охлаждение лопатки турбины) удваивает число ячеек: сетка нужна и для жидкости, и для металла. В многообластных задачах (chtMultiRegionFoam) сетки в десятки миллионов ячеек — норма.
Параметрические исследования и оптимизация. Часто нужно не одно решение, а сотни или тысячи — варьируя геометрию, граничные условия, режимы работы. Каждый вариант считается независимо, и кластер позволяет запустить их параллельно. Это не ускоряет отдельный расчёт, но сокращает общее время работы с месяцами до дней.
Общее правило. Если ваша сетка превышает 10–20 миллионов ячеек — одной машины, скорее всего, не хватит. Если расчёт на одной машине идёт больше недели — кластер окупается. Если задача требует более 256 ГБ оперативной памяти — кластер становится единственным вариантом, потому что память распределяется по узлам вместе с сеткой.